Monte Carlo cho FDE: để table monitor tự chạy, viết luật SQL riêng cho từng khách
Hai loại monitor, một file YAML và một namespace đặt sai có thể quyết định bộ cảnh báo dữ liệu bạn bàn giao cho khách vẫn còn dùng được hay đã lặng lẽ biến mất.
Tóm tắt nhanh
- Table monitor bắt pipeline gãy và ngừng chạy, với phần lớn tích hợp thì chạy ngay mà không cần cấu hình.
- Luật nghiệp vụ của từng khách nằm trong validation monitor: chọn template hoặc tự viết SQL.
- Monitors as code giúp version và review luật, nhưng mỗi lần apply sẽ thay toàn bộ monitor trong namespace.
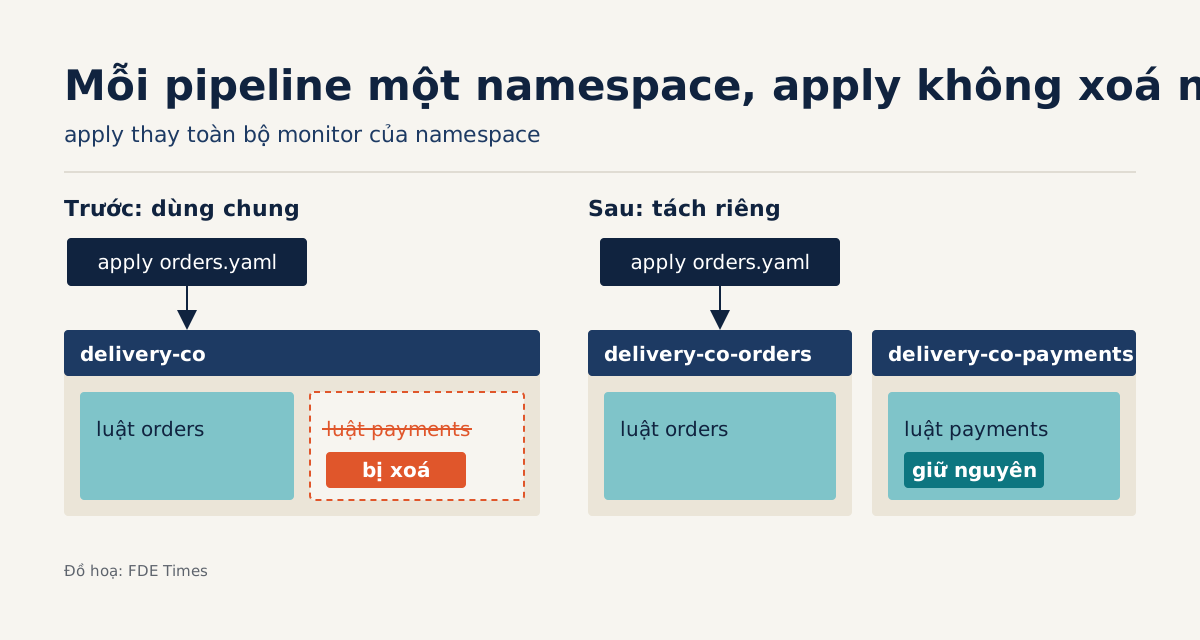
Sai lầm nguy hiểm nhất với Monte Carlo không nằm trong một câu SQL viết dở. Nó nằm trong lệnh apply: theo tài liệu monitors as code, mỗi lần apply sẽ thay toàn bộ monitor trong một namespace. Chạy lệnh đó từ repo của khách A vào đúng namespace của khách B là bộ cảnh báo của B biến mất mà không ai hay.
Với một FDE, chi tiết vận hành này quan trọng hơn mọi slide giới thiệu sản phẩm. Bạn đến chỗ khách để làm dữ liệu của họ đáng tin, rồi bàn giao một hệ thống vẫn chạy được sau khi bạn rời đi.
Nếu khách đang dùng Monte Carlo, hoặc bạn được giao dựng nó cho họ, việc đầu tiên là phân biệt rõ phần nào công cụ tự làm và phần nào bạn phải tự viết.
Phần nào tự chạy, phần nào phải viết?
Table monitor là nhóm có sẵn, dùng để phát hiện chỗ dữ liệu bị gãy hoặc ngừng chảy. Tài liệu cho biết với phần lớn tích hợp, nhóm này hoạt động ngay mà không cần người dùng cấu hình. Ngay tuần đầu ở chỗ khách mới, bạn đã có lưới an toàn cơ bản: bảng nào ngừng cập nhật thì sẽ có người biết.
Có điều table monitor không biết gì về nghiệp vụ của khách. Nó không biết một đơn hàng không thể giao trước lúc được đặt, hay doanh thu trong kho dữ liệu phải khớp với hệ thống thanh toán.
Những luật như vậy thuộc về validation monitor. Theo tài liệu, bạn có thể chọn template hoặc tự viết SQL, và loại này hợp với kiểm tra từng dòng, logic riêng của doanh nghiệp, hoặc so sánh chỉ số giữa nhiều nguồn.
Blog của chính Monte Carlo cũng mô tả SQL Rules là cách thêm monitor tùy chỉnh cho những trường hợp cụ thể, bổ sung cho phần phát hiện bất thường tự động. Cách hiểu đơn giản: phần tự động bắt lỗi kỹ thuật, còn phần bạn viết bắt những lỗi mà chỉ người hiểu nghiệp vụ mới nhận ra.
Một luật cho một công ty giao hàng
Thử hình dung khách là một công ty giao hàng với bảng orders. Qua customer discovery, bạn nghe được ba luật mà đội vận hành coi là hiển nhiên: thời điểm giao không được trước thời điểm đặt, đơn đã giao phải có mã tài xế, và tổng tiền đơn trong kho dữ liệu phải khớp với hệ thống thanh toán theo từng ngày.
Luật đầu tiên có thể viết thành một câu SQL trả về chính các dòng vi phạm:
SELECT order_id, created_at, delivered_at
FROM orders
WHERE delivered_at < created_at
  AND created_at >= CURRENT_DATE - 1
Viết theo kiểu này thì khi có cảnh báo, người trực ca mở ra là thấy ngay đơn nào sai, không phải đoán.
Luật thứ ba thuộc loại so sánh chỉ số giữa nhiều nguồn. Giả sử dữ liệu thanh toán đã được đổ về cùng kho trong bảng payments, một phác thảo có thể trông như sau, chỉ trả về những ngày hai bên lệch nhau:
SELECT o.day, o.order_total, p.payment_total
FROM (
  SELECT DATE(created_at) AS day, SUM(amount) AS order_total
  FROM orders
  WHERE created_at >= CURRENT_DATE - 7
  GROUP BY 1
) o
JOIN (
  SELECT DATE(paid_at) AS day, SUM(amount) AS payment_total
  FROM payments
  WHERE paid_at >= CURRENT_DATE - 7
  GROUP BY 1
) p ON o.day = p.day
WHERE o.order_total <> p.payment_total
Cả hai câu đều cố ý giới hạn khung thời gian: câu đầu chỉ xét đơn từ hôm qua đến nay, câu thứ hai so bảy ngày gần nhất để thấy được ngày nào lệch. Lý do là tài liệu tích hợp của MotherDuck lưu ý rằng độ phức tạp của truy vấn và kích thước kết quả ảnh hưởng đến hiệu năng monitor.
Một luật quét toàn bộ lịch sử đơn hàng mỗi lần chạy sẽ chậm và tốn tài nguyên của khách, nên hãy giới hạn phạm vi và chỉ trả về những cột cần để xử lý sự cố.
Quy trình MotherDuck mô tả cũng là thứ tự nên làm ở chỗ khách: kết nối nguồn trước, rồi tạo monitor SQL tùy chỉnh cho các bảng, cho việc kiểm tra dữ liệu có được cập nhật đúng hạn không, hoặc cho các chỉ số cần theo dõi.
Luật của khách nên nằm trong Git
Tạo luật bằng tay trên giao diện thì nhanh, nhưng khó bàn giao. Monte Carlo cho phép định nghĩa monitor dưới dạng code bằng YAML; CLI đọc file YAML rồi đồng bộ trạng thái đã khai báo lên Monte Carlo. Nhờ vậy luật của từng khách có version, có pull request, và có người review trước khi chạy thật.
Phác thảo dưới đây chỉ minh họa cách tổ chức một repo; tên trường và cú pháp lệnh chính xác bạn cần đối chiếu với tài liệu monitors as code trước khi dùng:
# monitors/delivery-co/orders.yaml
namespace: delivery-co-orders
monitors:
  - name: delivered_before_created
    type: validation
    sql: |
      SELECT order_id, created_at, delivered_at
      FROM orders
      WHERE delivered_at < created_at
        AND created_at >= CURRENT_DATE - 1
  - name: daily_revenue_matches_payments
    type: validation
    sql: |
      -- the cross-source query above
Đây là lúc lệnh apply ở đầu bài trở nên quan trọng. Vì mỗi lần apply thay toàn bộ monitor trong namespace, tài liệu khuyên mỗi nhóm hoặc mỗi pipeline dùng namespace riêng. Trong phác thảo trên, namespace mang tên cả khách lẫn pipeline, nên một file của đội thanh toán sẽ không bao giờ ghi đè luật của đội đơn hàng.
Tài liệu còn giới hạn cờ --auto-yes, dùng để bỏ qua bước xác nhận, chỉ cho môi trường CI. Một quy ước hợp lý là CI chạy apply sau khi pull request được duyệt, còn trên máy cá nhân thì không ai bỏ qua bước xác nhận. Hãy chốt quy ước đặt tên namespace ngay ngày đầu, trước khi viết luật thứ hai.
Học gì trước, ghi gì vào CV?
Thứ đáng học nhất không phải là giao diện của Monte Carlo. Đó là kỹ năng biến một câu nói của khách như “đơn giao rồi thì phải có tài xế” thành một câu SQL kiểm tra được, chạy rẻ và dễ đọc.
Kỹ năng này dùng được với bất kỳ công cụ data quality nào, và càng có giá trị khi Monte Carlo, giờ dùng domain montecarlo.ai, tự giới thiệu là công cụ theo dõi, xử lý sự cố và cải thiện cả AI agent lẫn dữ liệu bên dưới chúng.
Khi đọc mô tả việc làm FDE, hãy để ý các cụm từ như data quality, observability, monitors as code hoặc CI/CD cho data. Trong CV, đừng chỉ ghi “đã dùng Monte Carlo”. Hãy ghi bạn đã mã hóa bao nhiêu luật nghiệp vụ của khách thành monitor được version trong Git, và tổ chức namespace ra sao để nhiều đội cùng làm mà không giẫm chân nhau.
Cảnh báo tự động giúp bạn biết pipeline còn chạy. Còn luật bạn để lại trong repo là thứ giúp đội của khách biết dữ liệu còn đúng, kể cả sau khi bạn đã rời dự án.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!