Microsoft Presidio: che PII trước khi gọi LLM, và vì sao chính tài liệu của nó không hứa bắt hết
Thư viện mã nguồn mở này cho bạn một lớp lọc dữ liệu cá nhân đặt trước model, nhưng mặc định nó chỉ có mô hình tiếng Anh và tự nhận không bắt được hết.

Tóm tắt nhanh
- Presidio gồm Analyzer (phát hiện bằng NER, regex) và Anonymizer (replace, redact, mask, hash, encrypt).
- Mặc định chỉ có mô hình và recognizer tiếng Anh, lại không có định danh riêng của nhiều quốc gia.
- Không bảo hành, không SLA, API không có xác thực: phải tự bọc và tự đo.
Tài liệu của Presidio có một câu mà mọi FDE nên đọc trước khi cắm nó vào hệ thống của khách: không có gì đảm bảo Presidio sẽ tìm ra mọi thông tin nhạy cảm. Một thư viện che dữ liệu cá nhân lại tự nhận mình sẽ bỏ sót. Hiểu rõ lời thừa nhận đó là bước đầu để dùng nó cho đúng.
Khi bạn dựng một agent hay chatbot trên ticket hỗ trợ, hồ sơ bệnh nhân hay email của khách, câu hỏi đầu tiên từ đội bảo mật thường là: dữ liệu cá nhân có đi ra nhà cung cấp model không?
Presidio là một công cụ mã nguồn mở để trả lời câu đó. Nhưng nếu chỉ cài nó rồi gật đầu “đã che PII”, bạn đang hứa một điều mà chính tác giả của nó không dám hứa.
Presidio làm gì, gọn trong hai module
Presidio vốn là repo microsoft/presidio, nay đã chuyển sang data-privacy-stack/presidio, tài liệu dời về presidio.dataprivacystack.org. Dự án mô tả mình là các module nhận diện và ẩn danh hóa thực thể riêng tư trong văn bản và ảnh, phát hành theo giấy phép MIT.
Module thứ nhất là Analyzer. Nó chạy nhiều recognizer, mỗi recognizer phát hiện một hoặc vài loại PII bằng cơ chế riêng: mô hình NER, regex, hoặc logic khác. Có sẵn các thực thể toàn cầu như số thẻ tín dụng, email, IP, URL, PERSON, LOCATION, PHONE_NUMBER, cùng một số loại theo quốc gia như Mỹ, Anh, Singapore, Thái Lan.
Module thứ hai là Anonymizer, quyết định làm gì với thứ vừa tìm thấy. Các operator gồm replace, redact, mask, hash, encrypt và custom. Riêng encrypt đảo ngược được bằng operator decrypt của deanonymizer với cùng khóa, tức là bạn có thể che trước khi gửi model rồi trả giá trị gốc về cho người dùng.
Một ticket đi qua Presidio sẽ ra sao?
Thử hình dung một khách hàng ngân hàng gửi ticket viết tiếng Việt: tên đầy đủ, email, số thẻ, và mã khách hàng nội bộ dạng “KH-482913”. Email và số thẻ có khuôn cố định, regex của Presidio nhiều khả năng bắt được. Tên người là chuyện khác.
Mô hình NER mặc định là en_core_web_lg của spaCy, tức mô hình tiếng Anh. Tài liệu nói rõ mặc định chỉ có recognizer và mô hình tiếng Anh; muốn ngôn ngữ khác phải mở rộng cả NLP engine lẫn recognizer, và mỗi ngôn ngữ chỉ dùng được một mô hình NER. Một cái tên tiếng Việt nằm giữa câu tiếng Việt rất dễ trượt qua mô hình tiếng Anh.
Còn mã “KH-482913” thì chắc chắn lọt, vì không recognizer có sẵn nào biết nó. Danh sách thực thể mặc định cũng không có giấy tờ riêng của nhiều quốc gia, chẳng hạn căn cước hay mã số thuế Việt Nam. Cách sửa là viết một PatternRecognizer: regex cho khuôn mã, kèm context words như “mã khách hàng” và logic validate nếu cần.
Chi tiết dễ quên: context words phụ thuộc ngôn ngữ. Context viết tiếng Anh đặt lên văn bản tiếng Việt thì gần như vô dụng. Và regex chỉ bắt được thứ có khuôn: nếu nhân viên gõ mã khách hàng sai khuôn, chẳng hạn thiếu dấu gạch thành “KH482913”, regex viết cho “KH-482913” sẽ không nhận ra.
Chiều về là chỗ hay bị quên
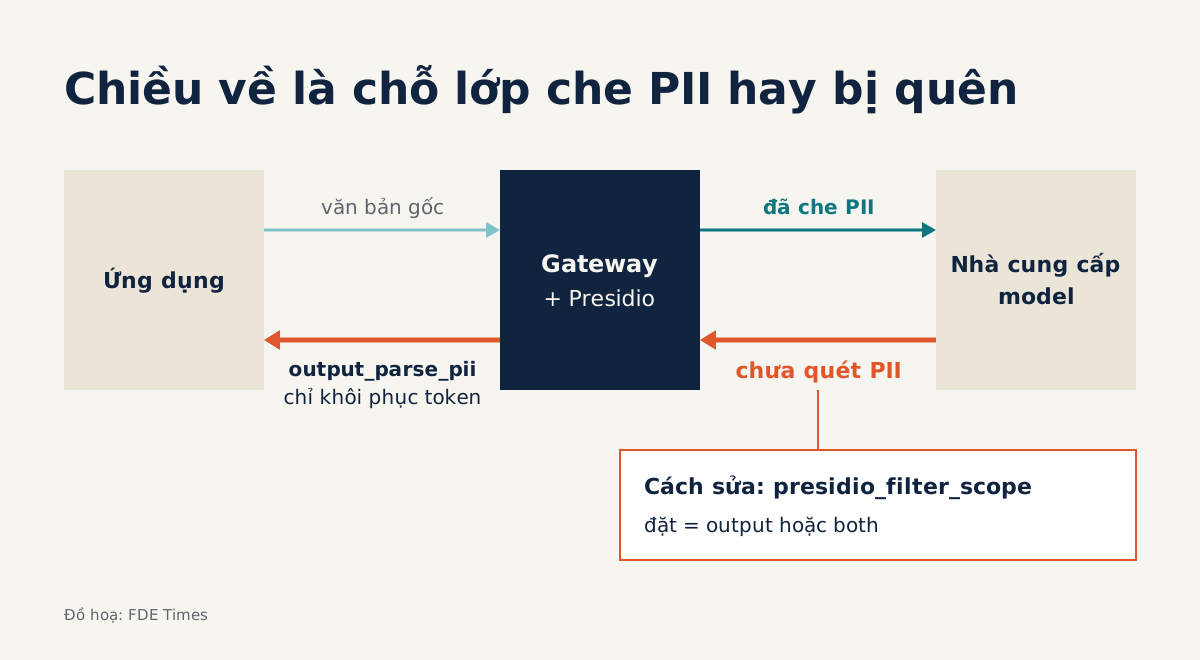
Một cách triển khai thường gặp là đặt Presidio ở lớp gateway, che PII trước khi request tới nhà cung cấp model; trang samples chính thức có hẳn mẫu làm việc này với một AI gateway. LiteLLM cũng có guardrail dùng Presidio, nhưng bạn phải tự triển khai cả container Analyzer lẫn Anonymizer.
Bẫy nằm ở cờ output_parse_pii của LiteLLM. Tài liệu ghi rõ nó chỉ đổi token đã che về giá trị gốc sau khi gọi model, không chạy nhận diện PII trên phản hồi. Muốn quét cả phản hồi, bạn phải đặt presidio_filter_scope là output hoặc both.
Thêm một điều đội bảo mật của khách sẽ hỏi: endpoint API của Presidio không có xác thực tích hợp, và đó là thiết kế có chủ ý. Bạn phải tự bọc nó sau lớp xác thực ở hạ tầng, nếu không thì dịch vụ che PII lại thành cửa hở cho chính PII.
Biết giới hạn thì mới bán được cho khách
FAQ của Presidio nói thẳng mọi logic nhận diện đều có lỗi, và giảm dương tính giả sẽ phải trả bằng việc bỏ sót nhiều hơn.
Nó cũng thừa nhận các dịch vụ PII dạng SaaS thường phủ thực thể rộng hơn hoặc chính xác hơn, và Presidio không phải sản phẩm chính thức của công ty nào, không bảo hành, không SLA.
Vì vậy tài liệu khuyên dùng thêm các lớp bảo vệ khác.
Khi trình bày với khách, hãy đặt Presidio đúng chỗ của nó: một lớp trong nhiều lớp, đi kèm con số đo được.
Trước buổi demo, gắn nhãn tay một mẫu văn bản thật của khách, chạy qua pipeline, rồi báo cáo bao nhiêu thực thể bị lọt theo từng loại.
Khi khách thấy bạn tự tìm ra chỗ hổng trước, họ tin bạn hơn là tin một lời hứa “đã che hết”.
Thứ tự học hợp lý: nắm Analyzer và Anonymizer trên văn bản tiếng Anh, rồi viết một PatternRecognizer cho định danh riêng của khách, sau đó thử cấu hình NLP engine cho ngôn ngữ khác, cuối cùng triển khai sau gateway có xác thực và quét cả hai chiều.
Trên CV, một dòng như “dựng lớp che PII trước LLM, đo tỷ lệ bỏ sót trên mẫu dữ liệu gắn nhãn, viết recognizer cho định danh nội bộ” cho nhà tuyển dụng thấy bạn hiểu deployment với dữ liệu thật, không chỉ biết gọi API.
Khách sẽ không hỏi bạn có dùng Presidio không. Họ sẽ hỏi cái gì còn lọt ra ngoài, và bạn nên là người có câu trả lời bằng số.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
10 nguồn
- Home - Presidio
- Presidio - Data Protection and De-identification SDK (GitHub)
- Frequently Asked Questions (FAQ) - Presidio
- Presidio Analyzer - Presidio
- Customizing the NLP model - Presidio
- Multi-language support - Presidio
- PII entities supported by Presidio - Presidio
- Presidio Anonymizer - Presidio
- PII, PHI Masking - Presidio | liteLLM
- Samples - Presidio