Datadog cho FDE: lần từ trace chậm tới đúng dòng log trên hệ thống của khách
Chỉ cần dòng log thiếu trường trace_id là mạch điều tra đứt ngay giữa buổi họp với khách, trong khi phép kiểm tra lỗi này chỉ mất năm phút.

Tóm tắt nhanh
- Mỗi request gửi vào ứng dụng đã instrument sẽ thành một trace. Flame graph của trace chỉ ra chỗ tốn thời gian.
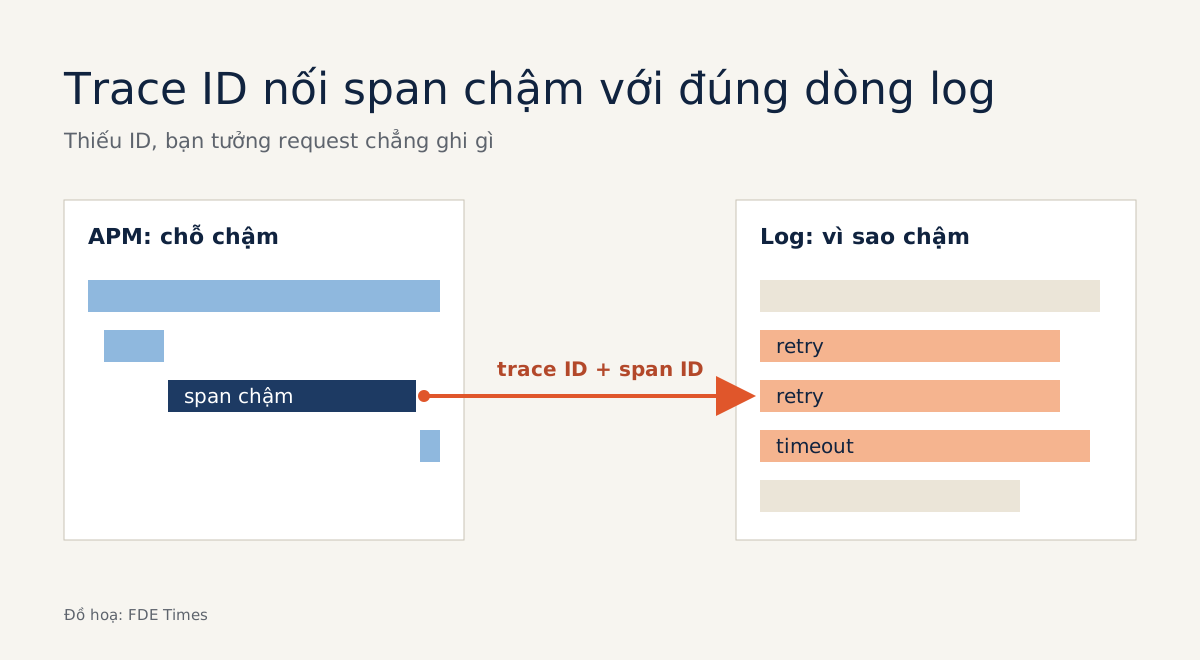
- Datadog nối trace với log bằng cách chèn trace ID và span ID vào log. Log không có trace ID sẽ không hiện dưới trace.
- FDE ở Datadog là vai quản lý, cố vấn cho khách qua các chu kỳ deployment phức tạp. FDE ở Dash0 thì tự tay triển khai OpenTelemetry tại khách doanh nghiệp.
Tin tuyển dụng FDE của chính Datadog không hề yêu cầu bạn gỡ lỗi trong Datadog của khách. Vị trí “Forward Deployed Engineering Manager - Datadog for Startups” cần một người cố vấn mà khách tin tưởng suốt các chu kỳ deployment phức tạp, chịu được việc đi công tác nhiều, và quản lý một nhóm SWE cùng TSE được biệt phái sang theo lượt.
Dash0, khi còn tuyển FDE cho khu vực EMEA, mô tả một việc sát tay hơn nhiều: làm trực tiếp với khách doanh nghiệp để triển khai và cấu hình instrumentation OpenTelemetry trên môi trường của họ. Tin đó nay đã đóng, nhưng nó cho thấy phần việc thật nằm ở chỗ làm observability chạy đúng trên hệ thống của khách.
Với bạn, phép thử thật thường đến khi khách đã chạy Datadog: một request chậm, cả phòng họp nhìn sang bạn, và bạn phải đi từ trace tới đúng dòng log giải thích nó. Phần dưới đây là thao tác đó, kèm một phép kiểm tra năm phút mà nhiều người bỏ qua.
Mỗi request để lại một trace
Hướng dẫn APM của Datadog bắt đầu rất đơn giản: mỗi lần bạn chạy lệnh curl vào ứng dụng mẫu, một trace mới được gửi lên Datadog và mở được trong màn hình Traces. Chọn một trace, bạn thấy chi tiết của nó, trong đó có flame graph. Theo tài liệu của Datadog, flame graph chính là chỗ giúp bạn tìm ra nút thắt hiệu năng.
Trace mới cho bạn biết thời gian bị tiêu ở đâu. Để biết vì sao, bạn cần log, và Datadog nối hai thứ này bằng cách chèn trace ID và span ID vào log dưới dạng thuộc tính. Trong bảng log của một trace có bốn bộ lọc: trace_id, host, container_id và pod_name. Chỉ bộ lọc trace_id khoanh đúng những dòng log mang ID của request đó.
Một request chậm mà không ai giải thích được
Thử hình dung bạn vừa đưa một integration vào hệ thống của khách. Đến ngày thứ ba, khách báo một phần request gọi qua dịch vụ của bạn rất lâu mới trả về. Đội của khách nghi phần của bạn có lỗi, còn bạn chưa có bằng chứng nào cho điều ngược lại.
Bạn mở Traces, chọn một trace chậm của endpoint đó và đọc flame graph. Giả sử phần lớn thời gian rơi vào một lời gọi sang dịch vụ nội bộ của khách, không nằm trong code của bạn. Bạn bật bộ lọc trace_id ở bảng log để xem request ấy đã ghi gì, và bảng trống trơn.
Đây là lúc nhiều người kết luận vội rằng request đó chẳng ghi log nào. Thường thì log vẫn có, chỉ là Datadog không biết nó thuộc về trace nào.
Phép kiểm tra năm phút trước buổi họp
Tự gửi một request mẫu, giống cách hướng dẫn của Datadog dùng curl, rồi mở dòng log mà request đó sinh ra. Câu hỏi duy nhất: dòng này có mang trace ID không? Tài liệu xử lý sự cố của Datadog nói thẳng rằng nếu log không có trace ID, nó sẽ không hiện dưới trace.
Thử hình dung dòng log của dịch vụ khách trông như sau, với ID nằm dưới một tên trường tự đặt:
{"level":"warn","msg":"upstream timeout, retry 3/3","traceId":"<id>"}Gặp trường hợp như vậy, tài liệu của Datadog hướng dẫn bạn trích ID ra rồi remap nó về trace_id, thuộc tính mà Datadog dành riêng cho việc này.
Nếu bạn là người instrument từ đầu, hãy đặt tên đúng ngay từ đầu: đặc tả của OpenTelemetry, một chuẩn trung lập không thuộc nhà cung cấp nào, quy định log JSON và các định dạng không phải OTLP nên dùng trường trace_id và span_id, viết bằng hex chữ thường.
Span chậm nhất chưa chắc là thủ phạm
Khi log đã nối được, bạn có thể thấy một loạt lần thử lại và thông báo timeout. Lúc này cần tỉnh táo: dịch vụ nội bộ của khách có thể chậm chính vì request của bạn gửi sang quá nhiều lần thử lại, và khi đó lỗi lại quay về phía bạn.
Flame graph cho bạn con số thời lượng, còn log cho bạn câu chuyện phía sau. Mang cả hai vào phòng họp, cuộc trao đổi sẽ chuyển từ “lỗi của ai” sang “sửa chỗ nào”.
Học gì trước, ghi gì vào CV
Bắt đầu với ứng dụng mẫu trong hướng dẫn APM, tập đọc flame graph cho tới khi bạn chỉ ra span đáng ngờ trong vài giây. Tiếp theo là nối trace với log, kể cả thao tác remap khi tên trường lệch chuẩn. Sau đó học quy ước của OpenTelemetry, vì đó là phần việc chính của vai FDE mà Dash0 từng tuyển và mang theo được sang mọi khách.
Khi đọc tin tuyển dụng, để ý phần mô tả công việc thực tế: cố vấn deployment như ở Datadog khác hẳn việc tự tay cài instrumentation như ở Dash0, và yêu cầu đi công tác nhiều cũng cần tính trước.
Mô hình biệt phái của Datadog còn gợi ra một đường thử vai: nếu bạn là SWE hoặc TSE ở công ty có chương trình luân phiên tương tự, xin một lượt biệt phái là cách thử làm FDE mà không phải đổi việc.
Trong CV, đừng chỉ ghi “thành thạo Datadog”. Hãy kể một ca cụ thể: bạn đã instrument hệ thống nào, đã nối trace với log ra sao, và thời gian tìm lỗi giảm được bao nhiêu nếu bạn từng đo con số đó.
Công cụ observability tốt đến đâu thì trace vẫn dừng ở ranh giới giữa hai đội. Người mở được dòng log ngay tại ranh giới ấy là người khách muốn giữ lại.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!