Unsloth: fine-tune model nhỏ trên một GPU, rồi chạy ngay trong hạ tầng của khách
Khi khách không cho dữ liệu ra khỏi hạ tầng của họ, bạn cần một model đủ nhỏ để train ngay tại chỗ và đủ gọn để chạy được trên máy của họ.

Tóm tắt nhanh
- Tài liệu của Unsloth nói có thể fine-tune trên Colab, Kaggle hoặc máy cá nhân chỉ với 3GB VRAM; QLoRA lượng tử hoá model gốc về 4-bit để tiết kiệm khoảng 75% bộ nhớ.
- Model sau khi train có thể xuất sang GGUF để chạy bằng Ollama hoặc llama.cpp, hoặc dùng vLLM khi cần phục vụ nhiều người dùng.
- Trước khi bàn giao cho khách, kiểm tra chat template và giấy phép: lõi dùng Apache 2.0, còn Studio và CLI dùng AGPLv3.
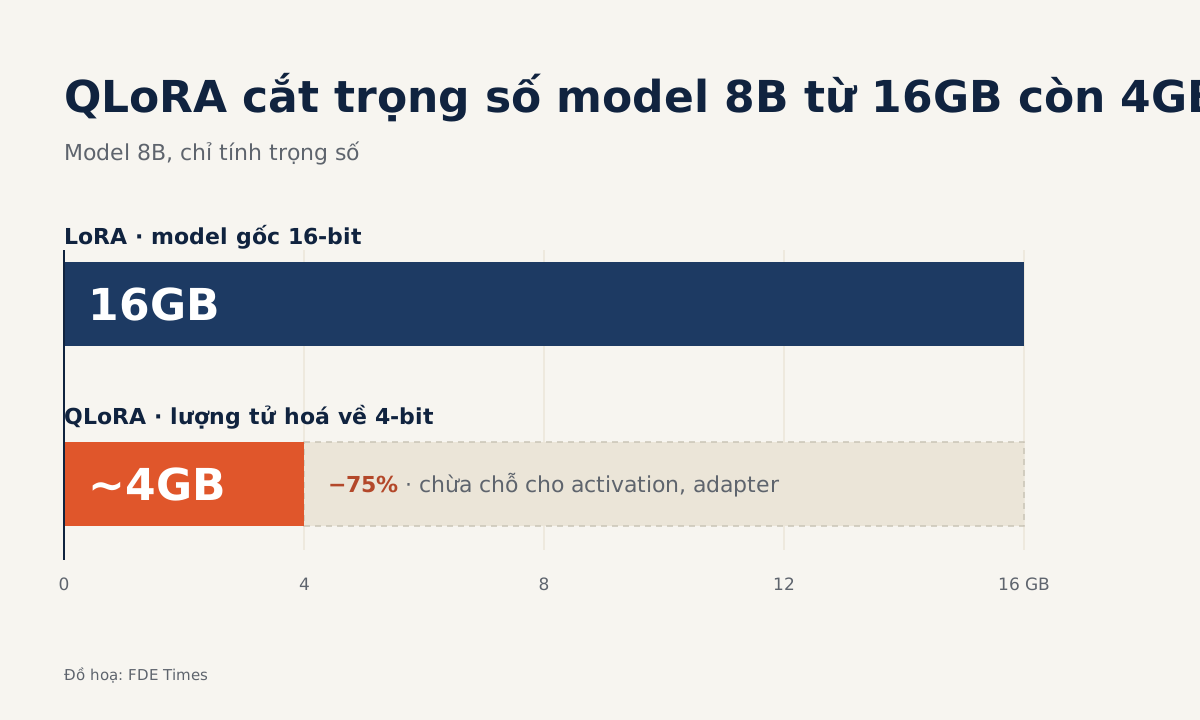
Một model 8B với trọng số 16-bit nặng khoảng 16GB, chưa tính bộ nhớ dành cho việc train. Nếu khách chỉ cấp cho bạn một card tầm trung, riêng phép tính này đã đủ chặn dự án ngay từ buổi đầu. Unsloth nhắm vào đúng điểm nghẽn đó.
Repo chính thức của Unsloth tuyên bố tool này train nhanh gấp 2 lần và dùng ít hơn 70% VRAM, áp dụng cho LLM, diffusion, TTS và cả embedding model. NVIDIA, trong một bài blog thuộc chuỗi RTX AI Garage, gọi Unsloth là một trong những framework mã nguồn mở để fine-tune LLM được dùng rộng rãi nhất thế giới.
Với một FDE, sức hấp dẫn không nằm ở tốc độ. Điều đáng giá hơn là bạn có thể train ngay bên trong hạ tầng của khách rồi xuất model ra định dạng mà máy của họ chạy được, và dữ liệu không phải rời khỏi đó lần nào.
Khi nào bạn nên dùng nó?
Thử hình dung một công ty logistics muốn tự động phân loại ticket hỗ trợ. Họ có hàng nghìn ticket đã gắn nhãn, nhưng chính sách nội bộ không cho gửi dữ liệu này đến API bên ngoài. Họ có một server với một card T4 và muốn model chạy ngay trên máy đó.
Đây là tình huống hợp với Unsloth. Prompt engineering trên một model lớn bị loại vì dữ liệu không được ra ngoài. Còn một model nhỏ chưa fine-tune thì thường không hiểu cách khách đặt tên các loại sự cố. Bạn cần một model nhỏ đã học từ vựng của khách, chạy được trên phần cứng sẵn có.
Bước đầu tiên là kiểm tra phần cứng. Tài liệu của Unsloth yêu cầu GPU có CUDA capability tối thiểu 7.0, tức các dòng như V100, T4, Titan V, RTX 20 và 50, A100, H100, L40. T4 của khách nằm trong danh sách. Nếu khách đưa ra một card cũ hơn, bạn cần biết điều đó trước khi hứa hẹn bất cứ điều gì.
Bài toán bộ nhớ, tính bằng tay
Tài liệu hướng dẫn phân biệt hai cách. LoRA giữ model gốc ở 16-bit, chưa lượng tử hoá. QLoRA lượng tử hoá model gốc về 4-bit và tiết kiệm khoảng 75% bộ nhớ.
Áp vào ví dụ trên: 8 tỷ tham số ở 16-bit, mỗi tham số 2 byte, ra khoảng 16GB chỉ riêng trọng số. Cắt 75% thì còn khoảng 4GB, để lại phần còn trống trên card cho activation và các adapter đang được train.
Phép tính thô này đủ để bạn trả lời khách ngay trong cuộc họp đầu tiên rằng phần cứng của họ có dùng được hay không.
Tài liệu cũng khuyên người mới bắt đầu với một model instruct nhỏ như Llama 3.1 (8B) rồi thử nghiệm dần. Lời khuyên này hợp với FDE vì một lý do thực tế: model nhỏ train nhanh, nên bạn có thể chạy vài vòng thử ngay trong tuần đầu thay vì đợi nhiều ngày.
Nếu chỉ cần thử ý tưởng, tài liệu nói có thể fine-tune miễn phí trên Colab hoặc Kaggle, hoặc trên máy cá nhân với chỉ 3GB VRAM.
Định dạng xuất quyết định model sống ở đâu
Repo của Unsloth cho biết model có thể xuất sang GGUF, NVFP4 và FP8. Lựa chọn nào đúng thì tuỳ vào cách khách sẽ dùng model.
Tài liệu tách thành hai hướng rõ ràng. Nếu model chạy trên một thiết bị, bạn dùng llama.cpp để chuyển sang GGUF rồi chạy trong Ollama, llama.cpp hoặc LM Studio. Nếu nhiều người dùng cùng gọi model, như một hệ thống doanh nghiệp, tài liệu hướng bạn sang vLLM.
Trong ví dụ logistics, nếu chỉ một đội hỗ trợ dùng model trên một server, GGUF chạy bằng Ollama là đủ và dễ bàn giao. Nếu sau này cả công ty cùng gọi qua API, bạn cần tính lại với vLLM. Hãy hỏi khách câu này trước khi bắt đầu train, vì nó quyết định cả định dạng xuất lẫn cách bạn đo hiệu năng.
Hai cái bẫy khi bàn giao
Cái bẫy đầu tiên là chat template. Trang hướng dẫn xuất GGUF của Unsloth nhấn mạnh rằng khi suy luận phải dùng đúng chat template đã dùng lúc train. Nếu lệch, kết quả trên Ollama hoặc vLLM sẽ kém đi.
Đây là loại lỗi khiến model chạy rất tốt trên notebook của bạn nhưng trả lời lung tung trên server của khách, và bạn có thể mất cả buổi chiều để tìm ra nguyên nhân.
Cái bẫy thứ hai là giấy phép. Phần lõi của Unsloth dùng Apache 2.0, nhưng các file trong studio/* và unsloth_cli/* dùng AGPLv3. Khi đóng gói bất cứ thứ gì để giao cho khách, hãy biết rõ mình đang dùng phần nào.
Trao đổi với bộ phận pháp chế của khách trước khi đưa Studio hay CLI vào sản phẩm sẽ rẻ hơn nhiều so với việc phải gỡ ra sau.
Đừng tin con số, hãy tự đo
Các con số về tốc độ không thống nhất. Repo nói nhanh gấp 2 lần, còn NVIDIA nói Unsloth tăng hiệu năng thư viện Hugging Face transformers lên 2,5 lần trên GPU NVIDIA. Cả hai đều đo trong điều kiện của họ, không phải trên dữ liệu và card của khách bạn.
Vì thế, trước khi đưa bất kỳ con số nào vào slide, hãy chạy một lần trên đúng phần cứng của khách. Ghi lại VRAM, thời gian train và chất lượng trên một bộ test cố định.
Đó cũng là thứ đáng đưa vào CV hơn cả: một câu như “fine-tune model 8B bằng QLoRA trên một T4, xuất GGUF chạy bằng Ollama, độ chính xác phân loại tăng từ X lên Y” cho nhà tuyển dụng thấy bạn đã làm trọn từ dữ liệu đến deployment.
Nên học theo thứ tự: LoRA và QLoRA trước, rồi chat template, rồi các định dạng xuất. Phần cuối là chỗ model của bạn gặp hạ tầng thật của khách, nên đừng để nó thành phần học vội nhất.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!