Polars và scan_csv: mở file khách hàng vài GB mà máy không treo như khi dùng pandas
Ở chỗ khách, chạy read_csv lên một file lớn rồi ngồi nhìn laptop đứng hình thì rất mất mặt; đọc lười giúp bạn tránh cảnh đó.

Tóm tắt nhanh
- Chính tài liệu của pandas thừa nhận rằng dữ liệu chiếm một phần đáng kể RAM đã khó xử lý, vì nhiều thao tác tạo bản sao trung gian.
- Hàm scan_csv và scan_parquet của Polars đọc lười, nên filter và lựa chọn cột được áp dụng ngay ở bước đọc file.
- Streaming engine chạy truy vấn theo từng lô, xử lý được dữ liệu lớn hơn RAM, và theo Polars còn nhanh hơn engine in-memory.
Thử hình dung buổi làm việc đầu tiên với một khách hàng logistics. Họ gửi một thư mục gồm vài chục file CSV, cộng lại khoảng vài GB, rồi hỏi: tháng trước kho nào giao trễ nhiều nhất? Bạn mở notebook và gõ pd.read_csv. Quạt laptop rú lên, con trỏ quay mãi không dừng, trong khi cả phòng đang đợi bạn trả lời.
Chuyện này không phải do bạn kém. Đó là giới hạn của kiểu đọc eager: nạp hết dữ liệu vào bộ nhớ rồi mới bắt đầu xử lý.
Polars giải quyết bằng một hướng khác hẳn: lập kế hoạch truy vấn trước, đọc dữ liệu sau. Với một FDE, đây là kỹ năng giúp bạn trả lời khách hàng ngay trong buổi họp, thay vì hẹn họ đến tuần sau.
Vì sao pandas gục khi file chưa lớn bằng RAM?
Tài liệu chính thức của pandas nói thẳng rằng làm việc với dữ liệu lớn hơn bộ nhớ là việc khó. Họ còn thừa nhận rằng dữ liệu chỉ chiếm một phần đáng kể của RAM cũng đã khó xoay xở, vì một số thao tác của pandas phải tạo bản sao trung gian.
Một file 4 GB trên máy 16 GB vì thế có thể làm hết bộ nhớ sau vài phép biến đổi.
pandas có cách xoay xở riêng. Nếu chỉ đọc những cột cần dùng, ví dụ trong tài liệu của pandas cho thấy bộ nhớ giảm còn khoảng 1/10, nhưng không phải định dạng nào cũng hỗ trợ việc này.
Bạn cũng có thể đọc theo từng chunk, có điều chính tài liệu pandas lưu ý rằng những phép như groupby khó làm theo chunk hơn nhiều. Mà câu hỏi “kho nào trễ nhiều nhất” lại chính là một phép groupby.
Đọc lười tức là đọc ít đi
Polars tự giới thiệu là thư viện DataFrame hiệu năng cao cho Python và Rust, với lõi viết bằng Rust. Khác biệt quan trọng với một FDE nằm ở chế độ lazy. Hàm scan_csv đọc CSV theo kiểu lười, và nhận được nhiều file cùng lúc qua glob pattern như data/*.csv. Ngoài CSV, Polars có hàm scan_ cho IPC, Parquet và JSON.
Khi bạn gọi scan_csv, Polars chưa nạp toàn bộ dữ liệu vào bộ nhớ mà ghi lại việc bạn muốn làm thành một kế hoạch truy vấn. Nhờ vậy bộ tối ưu có thể dùng predicate pushdown, tức đưa điều kiện lọc xuống càng sớm càng tốt, ngay ở bước đọc file.
Nó cũng dùng projection pushdown, tức chỉ đọc những cột thực sự cần. Tài liệu scan_csv cho biết cơ chế này có thể giảm lượng bộ nhớ phải dùng.
Câu hỏi của khách, viết thành một truy vấn
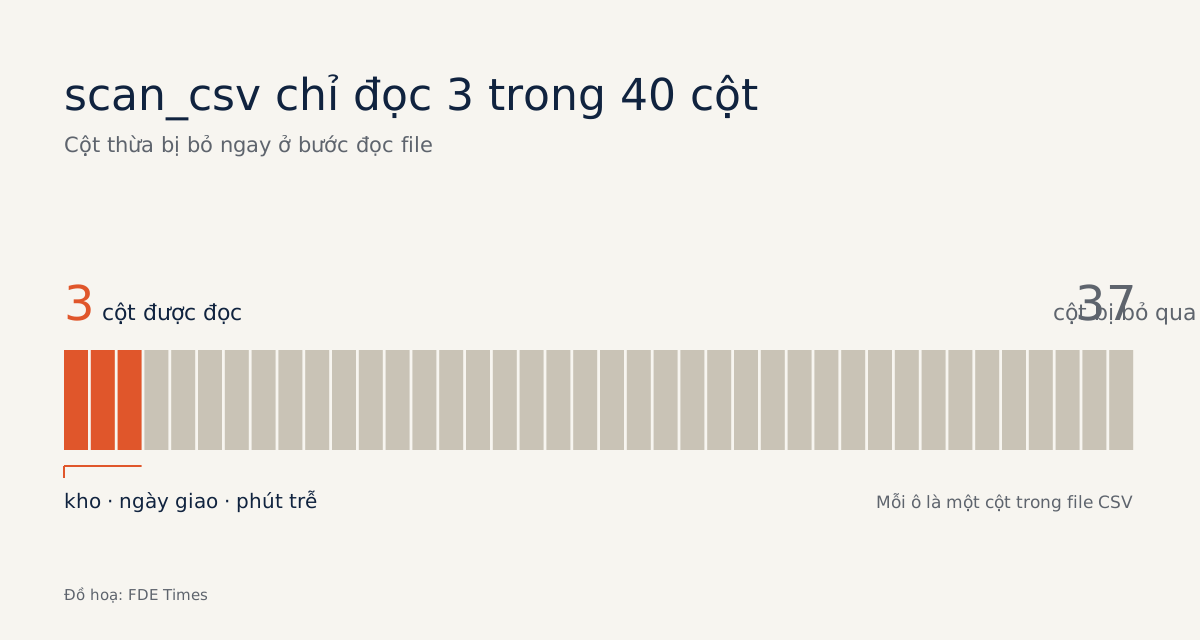
Quay lại câu hỏi về kho giao trễ. Giả sử mỗi file có 40 cột nhưng bạn chỉ cần ba: kho, ngày giao, số phút trễ. Giả sử thêm rằng “tháng trước” là tháng 9/2026 và cột ngày được lưu dạng chuỗi YYYY-MM-DD.
import polars as pl

q = (
    pl.scan_csv("giao_hang/*.csv")          # mới lập kế hoạch, chưa nạp toàn bộ dữ liệu
    .with_columns(pl.col("ngay_giao").str.to_date("%Y-%m-%d"))
    .filter(
        pl.col("ngay_giao").is_between(pl.date(2026, 9, 1), pl.date(2026, 9, 30))
    )
    .select(["kho", "ngay_giao", "phut_tre"])
    .group_by("kho")
    .agg(pl.col("phut_tre").mean().alias("tre_tb"))
    .sort("tre_tb", descending=True)
)

ket_qua = q.collect(engine="streaming")     # lúc này mới thực sự chạy
Hai chi tiết nhỏ quyết định đáp án có đúng câu hỏi hay không. Bộ lọc có cả cận dưới lẫn cận trên, nên chỉ giữ đúng một tháng thay vì “từ tháng 9 đến nay”. Cột ngày được chuyển sang kiểu date trước khi so sánh, để một dòng ghi 2026-9-5 hay có giờ phía sau không lọt qua phép so sánh chuỗi một cách âm thầm.
Phần còn lại dựa vào hai cơ chế đã nói. Nhờ projection pushdown, 37 cột còn lại bị bỏ qua ngay ở bước đọc. Nhờ predicate pushdown, các dòng ngoài tháng 9 bị loại trước khi đi tiếp, và kết quả cuối chỉ còn mỗi kho một dòng, vừa với một slide.
Parquet còn cho phép bỏ qua cả trang dữ liệu
Nếu khách đưa dữ liệu dạng Parquet, mọi việc còn dễ hơn. scan_parquet đọc lười file Parquet nằm trên máy hoặc trên cloud, và cũng đẩy filter và lựa chọn cột xuống bước đọc giống scan_csv. Điểm khác là Polars đọc được thống kê lưu sẵn trong file Parquet, nên có thể bỏ qua những trang dữ liệu chắc chắn không thỏa điều kiện lọc.
Vì vậy, nếu dự án kéo dài vài tuần, việc đáng làm sớm là chuyển CSV thô của khách sang Parquet một lần:
pl.scan_csv("giao_hang/*.csv").sink_parquet("giao_hang.parquet")

# từ đây, mọi câu hỏi mới bắt đầu bằng:
q = pl.scan_parquet("giao_hang.parquet")
Từ đó mỗi câu hỏi mới chỉ phải đọc phần dữ liệu liên quan, thay vì quét lại toàn bộ CSV thô.
Khi dữ liệu thật sự lớn hơn RAM
Đọc lười giúp bạn đọc ít hơn, nhưng sẽ có lúc phần cần đọc vẫn lớn hơn bộ nhớ. Đây là việc của streaming engine: Polars chạy truy vấn theo từng lô, nhờ đó xử lý được dữ liệu không vừa RAM.
Tài liệu của Polars còn khẳng định engine này nhanh hơn engine in-memory, không chỉ tốn ít bộ nhớ hơn. Bạn vẫn nên tự đo trên dữ liệu thật của khách trước khi hứa hẹn gì về tốc độ.
Polars có giới hạn, và bạn nên biết trước. Lợi ích của nó phụ thuộc vào việc bạn viết truy vấn sao cho bộ tối ưu có chỗ để làm việc. Polars cũng không phải pandas viết lại, nên cú pháp biểu thức pl.col(...) cần một thời gian để quen.
Những lỗi nào xóa sạch lợi ích của đọc lười?
Phần lớn lỗi khi mới dùng Polars không nằm ở thư viện mà ở thói quen mang từ pandas sang. Bảng dưới đây là những lỗi nên tự soát trước khi chạy truy vấn trên dữ liệu của khách.
| Lỗi thường gặp | Hậu quả | Cách sửa |
|---|---|---|
Gọi collect() ngay sau scan_csv rồi mới lọc |
Cả file bị nạp vào bộ nhớ, giống hệt khi dùng pandas | Viết hết filter, select, group_by rồi mới collect |
Dùng read_csv theo thói quen |
Không có kế hoạch nào để tối ưu | Đổi sang scan_csv hoặc scan_parquet |
| Lọc “tháng trước” chỉ bằng cận dưới | Gộp nhầm dữ liệu của tháng hiện tại | Dùng is_between với cả hai đầu |
| So sánh ngày dưới dạng chuỗi | Dòng có định dạng lệch bị lọc sai mà không báo lỗi | Chuyển cột sang kiểu date trước khi lọc |
| Quét lại CSV thô cho mỗi câu hỏi | Mỗi lần đều đọc lại toàn bộ dữ liệu | Chuyển sang Parquet một lần ở đầu dự án |
Nên học gì trước
Hãy bắt đầu từ tư duy lazy: hiểu scan_ khác read_ ở đâu, filter và select sớm, chỉ collect ở bước cuối. Sau đó học Parquet và streaming. Khi đi xin việc, đừng chỉ ghi “biết Polars” trong CV.
Hãy viết một dòng có số liệu, ví dụ đã xử lý bao nhiêu GB trên máy có bao nhiêu RAM và mức bộ nhớ đỉnh giảm bao nhiêu, rồi đưa notebook so sánh lên GitHub.
Một bài so sánh có số đo cụ thể cho người đọc CV thấy bạn đã thực sự làm việc đó, điều mà một danh sách từ khóa khó chứng minh.
Laptop của bạn không cần mạnh hơn. Bạn chỉ cần thói quen đọc đúng phần dữ liệu mà câu hỏi của khách cần.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!