jq: lọc và định hình lại JSON từ API của khách ngay trong terminal
Khi khách hỏi "có bao nhiêu đơn lỗi trên 500?", câu trả lời nhanh nhất có khi chỉ là một dòng lệnh, không cần mở notebook.

Tóm tắt nhanh
- jq là một file chạy duy nhất viết bằng C, không phụ thuộc runtime, nên cài được ngay trên máy của khách.
- Mọi thứ trong jq đều là filter; select giữ lại bản ghi khớp điều kiện, @csv xuất ra bảng tính.
- Truyền giá trị từ shell bằng --arg hoặc --argjson thay vì tự ghép chuỗi trích dẫn.
Buổi họp với khách mới được nửa giờ thì đội vận hành hỏi một câu rất bình thường: tuần này có bao nhiêu đơn thanh toán lỗi trên 500, của những khách nào?
Dữ liệu nằm sẵn trong API của họ, trả về một khối JSON dài vài nghìn dòng. Bạn có thể mở notebook rồi viết script, hoặc gõ một dòng lệnh và gửi file CSV trước khi họp xong.
Dòng lệnh đó thường là jq. Trang chính thức jqlang.org gọi nó là công cụ xử lý JSON trên dòng lệnh, “nhẹ và linh hoạt”, và ví nó như sed, nhưng dành cho JSON. Với một FDE, ngày nào cũng phải đọc payload lạ từ hệ thống của khách, jq là một trong những công cụ đáng học sớm nhất.
Vì sao nó hợp với máy của khách?
Máy của khách hiếm khi có môi trường bạn muốn.
Có thể đó là một bastion host bị khóa, không cài được gói Python, không có quyền root. jq được viết bằng C portable và không phụ thuộc runtime nào, nên bạn chỉ cần một file chạy duy nhất, phát hành theo giấy phép MIT, một điểm cộng khi phải xin phép cài công cụ lên hạ tầng của người khác.
Mọi thứ là một filter
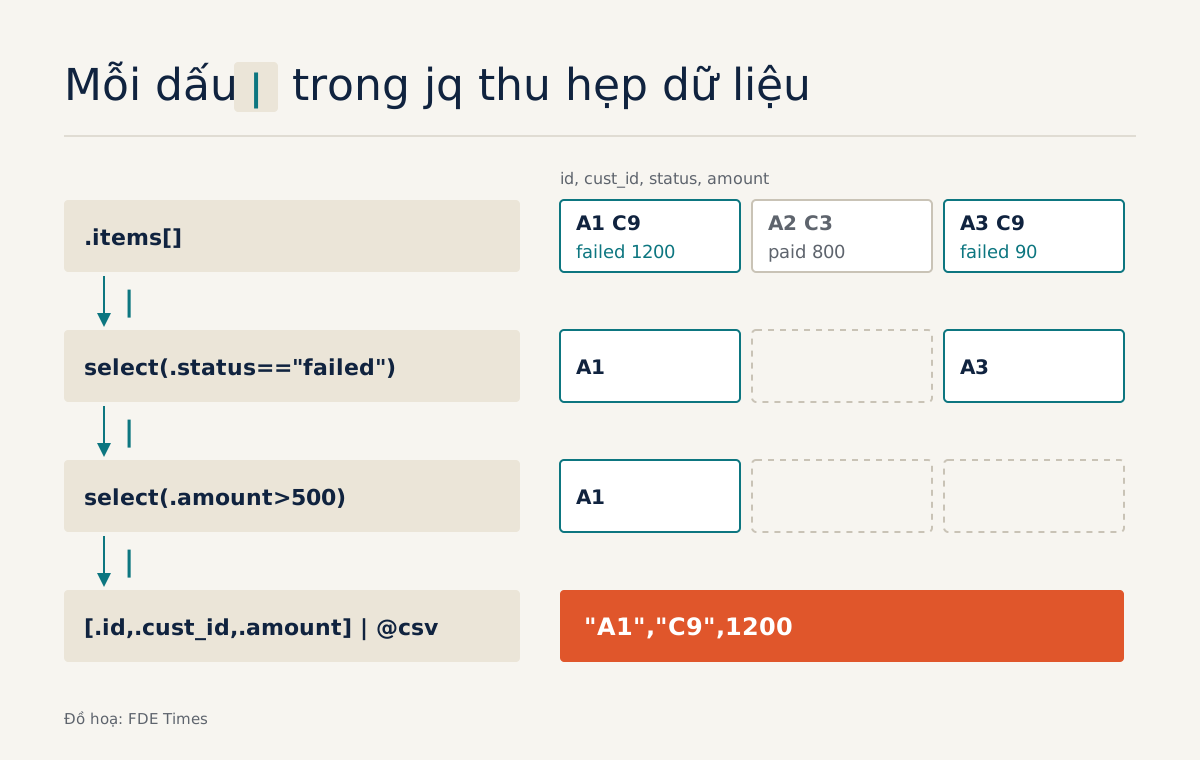
Muốn dùng jq trôi chảy, chỉ cần nắm một ý. Sổ tay jq 1.8 định nghĩa: một chương trình jq là một “filter”, nhận một đầu vào và tạo ra một đầu ra. Bạn ghép các filter bằng dấu |, giống pipe trong shell, và dữ liệu chảy từ trái sang phải.
Thử hình dung API của khách trả về file orders.json như sau:
{"items": [
  {"id": "A1", "status": "failed", "amount": 1200, "cust_id": "C9"},
  {"id": "A2", "status": "paid",   "amount": 800,  "cust_id": "C3"},
  {"id": "A3", "status": "failed", "amount": 90,   "cust_id": "C9"}
]}
Bước đầu tiên là tách mảng ra thành từng bản ghi, rồi chỉ giữ đơn lỗi. Hàm select(f) làm đúng việc đó: nó trả nguyên đầu vào nếu f đúng, và bỏ qua nếu sai.
jq '.items[] | select(.status == "failed")' orders.jsonKết quả là hai đơn A1 và A3. Đọc từ trái sang phải: vào mảng items, duyệt từng phần tử, giữ lại cái nào có trạng thái failed.
Đưa ngưỡng từ shell vào mà không vỡ dấu nháy
Ngưỡng 500 hôm nay có thể thành 1000 ngày mai, nên đừng viết cứng vào lệnh. Cách vụng là ghép chuỗi shell vào giữa chương trình jq, rồi vật lộn với dấu nháy đơn và nháy kép. Sổ tay chỉ ra cách sạch hơn: --arg và --argjson truyền giá trị vào chương trình như một biến định sẵn.
jq --argjson min 500 \
  '.items[] | select(.status == "failed" and .amount > $min)' orders.json
Giờ chỉ còn A1. Với ba bản ghi mẫu thì đếm bằng mắt cũng được; với vài nghìn bản ghi thật, bước tiếp theo sẽ cho bạn cả con số lẫn danh sách.
Từ JSON sang file khách mở được
Đội vận hành của khách không đọc JSON; họ mở bảng tính. Định dạng @csv nhận một mảng và xuất ra một dòng CSV, chuỗi được bọc nháy kép và dấu nháy bên trong được nhân đôi. Vì thế việc của bạn là dựng một mảng gồm đúng các cột muốn xuất, rồi đưa nó qua @csv.
jq -r --argjson min 500 \
  '.items[] | select(.status == "failed" and .amount > $min)
   | [.id, .cust_id, .amount] | @csv' orders.json > failed.csv
File failed.csv chỉ có một dòng: "A1","C9",1200. Một dòng nghĩa là một đơn, và cột thứ hai cho biết đó là khách nào: cả hai nửa câu hỏi đã có câu trả lời đính kèm.
Đôi khi vấn đề lại là tên trường: khách gọi là cust_id, hệ thống của bạn gọi là customer_id. Bộ to_entries và with_entries chuyển qua lại giữa object và mảng cặp key–value, nên bạn đổi được tên key mà không phải liệt kê lại mọi trường:
jq '.items[] | with_entries(.key |= if . == "cust_id" then "customer_id" else . end)' orders.jsonBa lỗi người mới hay vấp
Lỗi đầu tiên là nhầm --arg với --argjson. --arg truyền vào một chuỗi, còn --argjson truyền một giá trị đã mã hóa JSON, nên 500 vẫn là số. Nếu so .amount với chuỗi "500", bạn sẽ không nhận được kết quả mình muốn, và loại lỗi này rất khó phát hiện khi đang demo.
Lỗi thứ hai là đưa cả object vào @csv. Sổ tay ghi rõ đầu vào của @csv phải là một mảng, nên {"id": "A1", ...} phải được biến thành [.id, .cust_id, .amount] trước, và chính bước đó quyết định thứ tự cột trong bảng tính.
Lỗi thứ ba là chờ select sửa dữ liệu. Nó chỉ giữ hoặc bỏ, bản ghi đi qua vẫn nguyên vẹn; muốn đổi hình dạng, bạn phải thêm một filter khác phía sau dấu |.
Giới hạn: nó là một ngôn ngữ, không phải phím tắt
Wikipedia mô tả jq vừa là tiện ích dòng lệnh vừa là một ngôn ngữ lập trình hàm chuyên biệt. Nhờ vậy nó diễn đạt được nhiều thứ, nhưng một chương trình jq dài cũng khó đọc như mã của bất kỳ ngôn ngữ nào.
Khi lệnh dài đến mười dòng với điều kiện lồng nhau, đồng nghiệp tiếp nhận dự án sẽ khó bảo trì nó hơn một script Python có test.
Nguyên tắc thực dụng là dùng jq để khám phá và trả lời câu hỏi tức thời: soi payload, lọc, xuất file. Khi logic biến thành một bước lặp lại trong pipeline của khách, hãy chuyển sang mã có kiểm thử và review.
Học gì trước, và đưa vào CV thế nào
Thứ tự hợp lý là: truy cập trường và duyệt mảng, ghép bằng |, rồi select, --argjson, @csv, cuối cùng mới đến with_entries. Bài tập tốt nhất là lặp lại đúng chuỗi lệnh ở trên trên một phản hồi API trong dự án bạn đang làm: lọc bản ghi lỗi, đưa ngưỡng vào bằng --argjson, xuất CSV, rồi đổi tên một trường.
Đừng chỉ ghi “jq” vào danh sách kỹ năng. Một runbook trong repo portfolio, có vài lệnh jq kiểm tra dữ liệu kèm giải thích ngắn từng lệnh trả lời câu hỏi gì, cho người tuyển dụng thấy bạn biết đọc và gỡ rối dữ liệu không phải của mình.
Lệnh xuất CSV ở trên là điểm khởi đầu tốt: câu hỏi thật, dữ liệu thật, con số thật.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!