Evidently AI: chạy kiểm tra drift trước khi khách hàng thấy dữ liệu đã đổi
Bàn giao xong một model là lúc rủi ro thật sự bắt đầu. Một thư viện mã nguồn mở có thể giúp đội khách hàng biết dữ liệu đã đổi trước khi người dùng gọi điện phàn nàn.

Tóm tắt nhanh
- Evidently là thư viện Python mã nguồn mở Apache 2.0, có hơn 100 metric, từ phát hiện data drift đến LLM judge
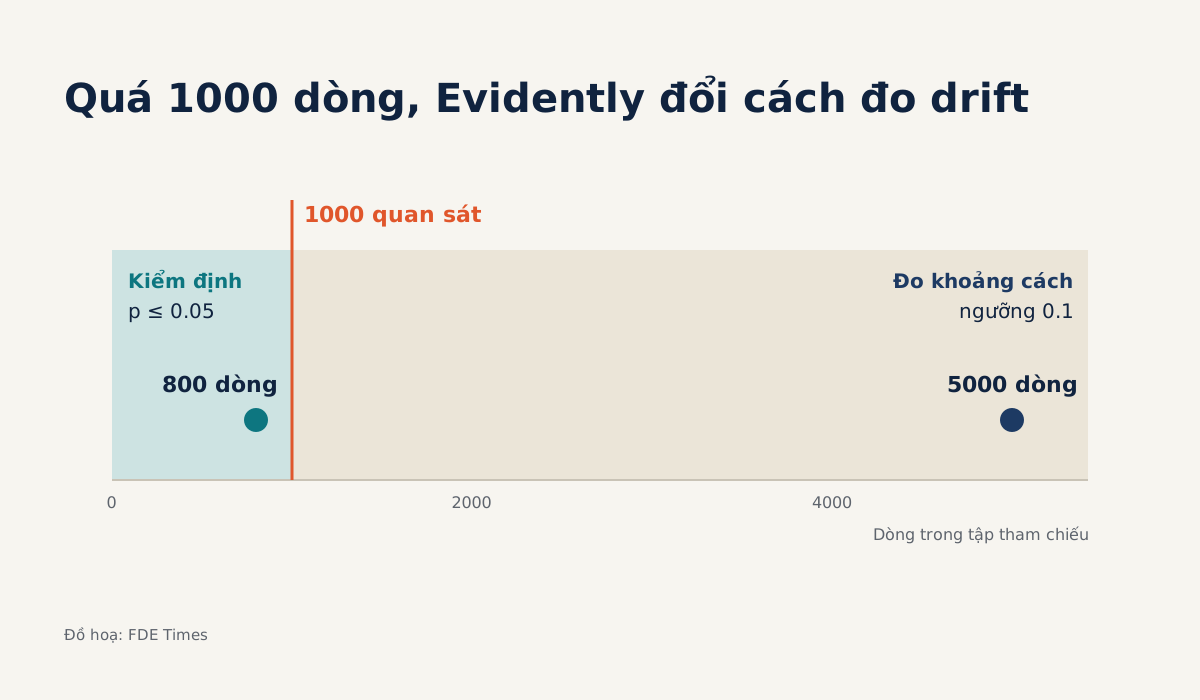
- Tập tham chiếu từ 1000 quan sát trở xuống được kiểm định thống kê (drift khi p ≤ 0.05). Tập lớn hơn dùng độ đo khoảng cách với ngưỡng 0.1
- Khai báo điều kiện pass/fail rồi chạy theo giờ, theo ngày hoặc khi có dữ liệu mới là bạn có ngay một cổng kiểm tra sau bàn giao
Ba tháng sau khi bạn rời khách hàng, model chấm điểm vẫn chạy và không báo lỗi gì, nhưng dữ liệu đầu vào thì đã khác. Model không tự nhận ra điều đó. Thường thì đội nghiệp vụ mới là người phát hiện, khi các con số bắt đầu trông lạ.
Evidently sinh ra để lấp đúng khoảng trống này. Đây là thư viện Python mã nguồn mở để đánh giá, kiểm thử và giám sát hệ thống ML và LLM, phát hành theo giấy phép Apache 2.0.
Với FDE, giấy phép ấy kéo theo những hệ quả rất thực tế. Một thư viện Apache 2.0 cài thẳng vào môi trường của khách hàng thường dễ qua vòng pháp chế hơn một dịch vụ mới phải ký hợp đồng. Bạn cũng để lại được một công cụ mà đội khách hàng tự vận hành sau khi bạn đi.
Mọi phép đo đều bắt đầu từ một đường cơ sở
Gói có sẵn hơn 100 metric, trải từ phát hiện data drift đến LLM judge, kèm một API kiểm thử khai báo. Kiểm tra chất lượng dữ liệu bảng và data drift là một trong những mảng sử dụng chính mà tài liệu liệt kê.
Logic cốt lõi rất đơn giản: so sánh dữ liệu production hiện tại với một tập tham chiếu. Oscar Wong, MLOps engineer tại Fuzzy Labs, mô tả tập tham chiếu là chuẩn để đối chiếu. Blog ra mắt bản 0.0.1 của Evidently năm 2020 khuyên chọn dữ liệu từ giai đoạn model từng chạy ổn định.
Vì thế câu hỏi đầu tiên ở khách hàng không phải là “cài thư viện thế nào”, mà là “tháng nào model chạy đúng ý anh chị?”. Nếu đường cơ sở đã lệch, mọi cảnh báo phía sau đều lệch theo.
Ngưỡng drift phụ thuộc vào lượng dữ liệu tham chiếu
Evidently không dùng một phép đo drift cho mọi trường hợp. Phương pháp mặc định được chọn theo kích thước tập tham chiếu, và đây là chỗ dễ gây hiểu lầm nhất khi bàn giao.
Nếu tập tham chiếu có từ 1000 quan sát trở xuống, Evidently dùng kiểm định thống kê như KS, chi-squared hay Z-score. Điểm drift là p-value, mức tin cậy mặc định là 0.95, nên cột nào có p ≤ 0.05 sẽ bị coi là drift.
Khi tập tham chiếu lớn hơn, công cụ chuyển sang độ đo khoảng cách như Wasserstein hay Jensen-Shannon, với ngưỡng mặc định 0.1.
Thử hình dung một ví dụ. Bạn bàn giao model duyệt hồ sơ vay có 12 feature, tập tham chiếu lấy từ 800 dòng dữ liệu kiểm định. Vì 800 không vượt 1000, từng cột sẽ được kiểm định thống kê.
Giả sử về sau tập tham chiếu được đổi sang 5000 dòng của quý trước. Lúc này phép đo đã chuyển sang khoảng cách với ngưỡng 0.1, và cùng một batch production có thể cho kết quả khác. Nếu tài liệu không ghi lại điều này, người tiếp quản sẽ không hiểu vì sao cảnh báo bỗng dày lên hoặc thưa đi.
Drift cấp tập dữ liệu cũng không phải mặc định cố định mà do bạn khai báo. Tài liệu lấy ví dụ coi cả tập là drift khi 50% số cột drift. Với 12 feature, theo quy tắc đó chỉ cần 6 cột drift là cả tập bị đánh dấu.
Hãy hỏi khách hàng xem 6 cột đó có quan trọng như nhau không. Một cột thu nhập bị drift có thể đáng lo hơn năm cột phụ cộng lại.
Từ báo cáo thành cổng kiểm tra
Một báo cáo chỉ có ích khi có người mở nó ra. Vì thế bước tiếp theo nên là dùng API kiểm thử khai báo: bạn viết ra điều kiện pass/fail, và drift trở thành một bước có thể fail trong CI, giống một bài unit test.
Đoạn mã dưới đây là phác thảo tối giản cho model vay 12 feature ở trên.
# PHÁC THẢO, CHƯA ĐỐI CHIẾU VỚI PHIÊN BẢN CỤ THỂ:
# tên lớp (Report, Dataset, DataDefinition, DriftedColumnsCount, lt)
# và cấu trúc kết quả (result["tests"], "status") có thể khác giữa
# các phiên bản Evidently. Kiểm tra tài liệu của bản bạn cài
# trước khi đưa vào pipeline thật.
import sys
import pandas as pd
from evidently import Report, Dataset, DataDefinition
from evidently.presets import DataDriftPreset
from evidently.metrics import DriftedColumnsCount
from evidently.tests import lt

reference = pd.read_parquet("validation_800_rows.parquet")
current = pd.read_parquet("production_last_batch.parquet")

definition = DataDefinition()
ref = Dataset.from_pandas(reference, data_definition=definition)
cur = Dataset.from_pandas(current, data_definition=definition)

# 1. Báo cáo: chỉ đo và tóm tắt, xuất HTML cho đội nghiệp vụ
report = Report([DataDriftPreset()])
report.run(current_data=cur, reference_data=ref).save_html("drift_report.html")

# 2. Kiểm thử: cùng phép đo, thêm điều kiện pass/fail
#    lt(6): fail khi từ 6/12 cột (50%) trở lên bị drift
suite = Report([DriftedColumnsCount(tests=[lt(6)])])
result = suite.run(current_data=cur, reference_data=ref).dict()

# 3. Cổng CI: test nào không pass thì dừng pipeline
failed = [t for t in result["tests"] if t["status"] != "SUCCESS"]
if failed:
    print(failed)
    sys.exit(1)
Báo cáo và bài kiểm thử đọc cùng một dữ liệu, nhưng mỗi thứ có người nhận riêng. File HTML dành cho đội nghiệp vụ đọc. Mã thoát khác 0 thì khiến CI dừng lại và báo động, kể cả khi không ai nhớ mở báo cáo.
Tài liệu giám sát của Evidently gợi ý chạy kiểm tra theo lô một cách định kỳ, theo giờ hoặc theo ngày, hoặc kích hoạt khi có dữ liệu hay nhãn mới. Với model vay, chạy mỗi khi có batch hồ sơ mới là cách bắt drift trước khi khách hàng nhìn thấy nó trong kết quả.
Những gì công cụ không làm thay bạn
Drift cho biết phân phối dữ liệu đã thay đổi, chứ không cho biết model đã dự đoán sai. Một feature có thể lệch đi mà chất lượng dự đoán vẫn ổn, và điều ngược lại cũng có thể xảy ra. Vì thế đừng hứa với khách hàng rằng “không có drift” nghĩa là “model vẫn tốt”.
Các ngưỡng 0.95 và 0.1 chỉ là mặc định, không phải chân lý. Hãy coi chúng là điểm xuất phát để cùng đội nghiệp vụ thống nhất mức thay đổi nào thì cần người vào xử lý.
Nên học gì trước?
Bắt đầu bằng một lần kiểm tra drift trên một model bạn hiểu rõ. Đọc phần giải thích phương pháp drift trong tài liệu cho đến khi tự giải thích lại được quy tắc 1000 quan sát. Sau đó mới thêm điều kiện pass/fail và đưa vào CI như đoạn mã trên.
Phần LLM nên để sau. Khi cần, thư viện Tracely của Evidently thu thập dữ liệu từ ứng dụng đang chạy, và tài liệu coi tracing là cách phù hợp nhất cho ứng dụng dùng LLM.
Làm sao để kỹ năng này hiện ra khi đi xin việc?
Khi đọc tin tuyển FDE, hãy để ý những cụm như giám sát model sau deployment, data quality, kiểm thử hồi quy hay vận hành hệ thống LLM trên production. Đó là tín hiệu công ty cần người ở lại với hệ thống sau buổi demo, chứ không chỉ người dựng prototype.
Cách chứng minh tốt nhất là một repo công khai nhỏ. Lấy một bộ dữ liệu mở, cắt một phần làm tham chiếu, cố ý làm lệch vài cột ở phần còn lại, rồi để GitHub Actions chạy kiểm tra và fail đúng lúc. README nên giải thích vì sao bạn chọn ngưỡng đó và ai sẽ nhận cảnh báo.
Trên CV, một dòng như “thiết lập kiểm tra drift trong CI cho model production, kèm tài liệu ngưỡng cho đội khách hàng” có sức nặng hơn hẳn một danh sách tên công cụ. Nếu có con số thật của dự án, như số feature được giám sát hay tần suất chạy, hãy ghi vào.
Trong phỏng vấn, hãy chuẩn bị một câu chuyện về một lần test fail: tín hiệu nào báo động, bạn kiểm tra gì để phân biệt drift vô hại với model đang sai, và bạn đã thống nhất lại ngưỡng với đội nghiệp vụ ra sao.
Bàn giao tốt không có nghĩa là model không bao giờ hỏng. Nó có nghĩa là khi dữ liệu đổi, đội khách hàng biết trước người dùng.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!