Thực hành: thiết kế kết quả trả về của tool để agent không ngập trong 10.000 dòng dữ liệu
Chỉ một lệnh gọi API không phân trang cũng có thể làm tràn context window của agent nhiều lần, và người phải chặn nó là người viết tool chứ không phải model.

Tóm tắt nhanh
- Phân trang có sẵn của MCP không áp dụng cho tools/call, nên giới hạn kích thước kết quả là việc của người viết tool.
- Kết hợp lọc, phân trang có trần, cắt bớt và chế độ concise. Trong ví dụ của Anthropic, concise chỉ tốn khoảng ⅓ số token.
- Thông báo cắt bớt có chỉ dẫn cụ thể sẽ kéo agent về những cách gọi tool tốn ít token hơn.
Runpod đã đo một lệnh gọi tool không phân trang trên một tài khoản thật. Dữ liệu trả về lớn gấp khoảng 15 lần context window của Claude Code. Một kết quả to hơn cả context thì agent không thể đọc trọn, dù model mạnh đến đâu.
Thử hình dung tuần đầu bạn làm việc ở chỗ khách. Họ đưa bạn một endpoint đơn hàng, lúc demo nó chỉ trả 20 dòng. Đến khi chạy trên dữ liệu thật, nó trả 10.000 dòng, dòng nào cũng kèm một payload thô. Agent bạn dựng hôm qua chạy mượt, hôm nay thì không chạy nổi.
Trong hướng dẫn viết tool cho agent, Anthropic nhấn mạnh rằng tối ưu lượng context mà tool trả về cũng quan trọng ngang với chất lượng của nó.
Cũng đừng trông vào giao thức. Theo phân tích của Wati, cơ chế phân trang có sẵn của MCP không áp dụng cho tools/call, trong khi đó lại là nơi phần lớn dữ liệu đi qua.
Vậy nên giới hạn kích thước kết quả là việc của bạn.
Bạn sẽ dựng gì, cần chuẩn bị gì?
Bạn sẽ viết tool search_orders bọc một API đơn hàng giả lập có 10.000 dòng. Bản hoàn chỉnh có bộ lọc, limit có trần, opaque cursor, công tắc concise/detailed, ngân sách token cho mỗi lần gọi và thông báo cắt bớt có chỉ dẫn. Thêm một tool phụ để lấy payload lớn khi agent thực sự cần.
Bạn chỉ cần Python 3, không cần thư viện ngoài. Code đã được giản lược và không gắn với framework MCP nào, bạn tự nối các hàm này vào SDK hay framework mình đang dùng. Toàn bộ dữ liệu là dữ liệu giả.
import json, random, base64

STATUSES = ["paid", "pending", "refunded", "failed"]
ORDERS = [
    {
        "order_uuid": f"7f3a-{i:05d}-c91e",
        "customer_name": f"Customer {i % 800}",
        "status": random.choice(STATUSES),
        "amount": round(random.uniform(5, 500), 2),
        "region": random.choice(["north", "south", "central"]),
        "raw_payload": "x" * 400,
    }
    for i in range(10_000)
]
Bước 1: đo kích thước trước khi sửa
Chưa có con số thì đừng sửa. Viết phiên bản “ngây thơ” trước, tức là tool trả nguyên mọi thứ API đưa về, rồi đo xem nó nặng bao nhiêu.
def estimate_tokens(obj) -> int:
    # rough estimate: assume ~4 characters per token; swap in your model's tokenizer
    return len(json.dumps(obj, ensure_ascii=False)) // 4

def list_orders_naive():
    return ORDERS

print(estimate_tokens(list_orders_naive()))
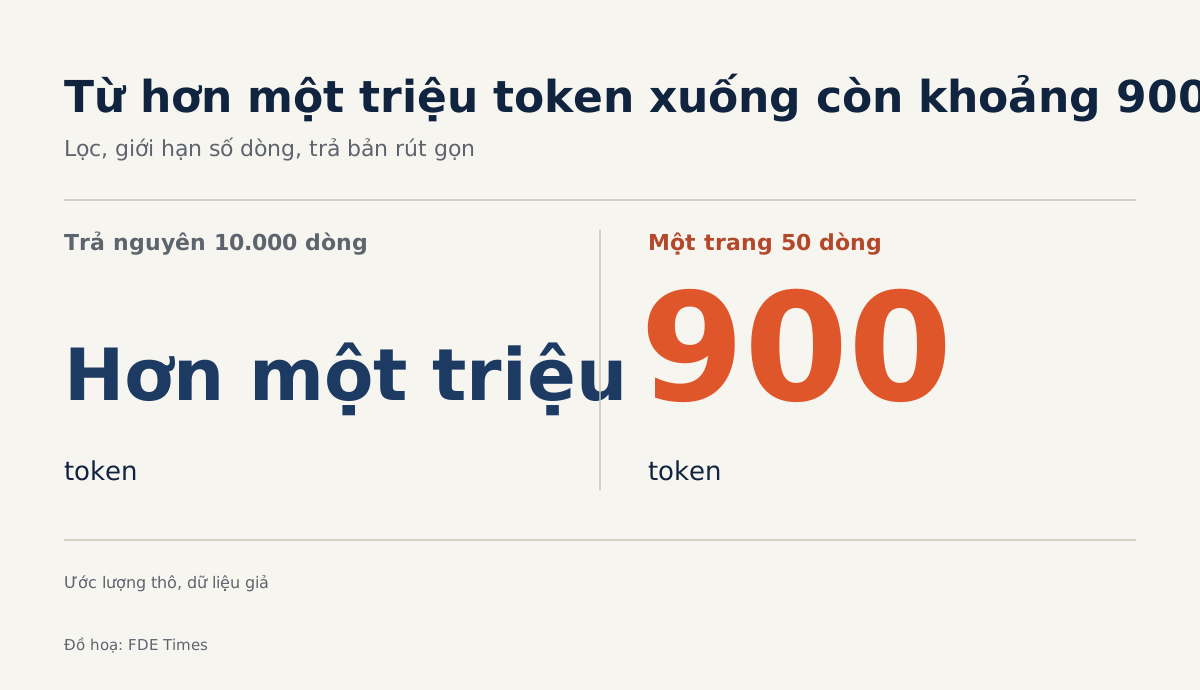
Kiểm tra: Riêng trường raw_payload đã có 4 triệu ký tự, nên theo cách ước lượng thô ở trên, kết quả sẽ vượt một triệu token. Để so sánh, Claude Code mặc định giới hạn mỗi kết quả tool ở 25.000 token. Hãy lấy 25.000 làm mốc ngân sách tham khảo cho mỗi lần gọi.
Bước 2: lọc trước, rồi mới tính chuyện khác
Anthropic khuyên các tool có thể trả nhiều dữ liệu nên kết hợp phân trang, chọn khoảng, lọc và cắt bớt. Lọc là bước rẻ nhất, vì dòng nào đã bị loại thì không bao giờ phải phân trang hay cắt bớt nữa.
def _filter(status=None, region=None, min_amount=None):
    rows = ORDERS
    if status:
        rows = [r for r in rows if r["status"] == status]
    if region:
        rows = [r for r in rows if r["region"] == region]
    if min_amount is not None:
        rows = [r for r in rows if r["amount"] >= min_amount]
    return rows
Kiểm tra: len(_filter(status="refunded")) sẽ còn khoảng một phần tư số dòng. Trong hệ thống thật, hãy đẩy bộ lọc xuống thành tham số query của API khách, đừng tải cả 10.000 dòng về rồi mới lọc.
Bước 3: limit có trần và opaque cursor
Quy tắc của Runpod cho mọi tool trả về danh sách rất ngắn: luôn phân trang, đặt trần cho limit và dùng opaque cursor, tức một chuỗi mà agent chỉ cần chuyển lại chứ không đọc được bên trong.
Có trần thì agent không xin được 5.000 dòng một lần. Khi cursor là opaque, agent không có offset nào để tự đoán, còn bạn có thể đổi cách phân trang ở backend mà không làm hỏng agent.
MAX_LIMIT = 50

def _encode(offset: int) -> str:
    return base64.urlsafe_b64encode(json.dumps({"o": offset}).encode()).decode()

def _decode(cursor) -> int:
    return json.loads(base64.urlsafe_b64decode(cursor))["o"] if cursor else 0
Cursor base64 ở đây chỉ để minh họa: agent không cần đọc nó, nhưng ai muốn vẫn giải mã được. Khi chạy production, hãy ký cursor hoặc dùng cursor do chính API của khách cấp.
Bước 4: concise mặc định, mã định danh chỉ khi cần
Anthropic khuyên kết quả tool nên ưu tiên ngữ cảnh có ý nghĩa và tránh mã định danh kỹ thuật cấp thấp. Một chuỗi uuid trần không cho agent biết gì, tên khách hàng thì có. Công tắc response_format cho agent tự chọn mức chi tiết. Trong ví dụ của Anthropic, chế độ concise chỉ dùng khoảng ⅓ số token.
def _shape(row, fmt):
    item = {"customer": row["customer_name"],
            "status": row["status"], "amount": row["amount"]}
    if fmt == "detailed":
        item["region"] = row["region"]
        item["order_id"] = row["order_uuid"]
        item["payload_ref"] = f"order-payload:{row['order_uuid']}"
    return item
Chế độ detailed vẫn giữ order_id vì agent cần nó để gọi tool tiếp theo. Còn raw_payload thì không bao giờ được trả thẳng, lý do nằm ở bước 6.
Kiểm tra: Ước lượng một trang 50 dòng concise. Với dữ liệu giả này, mỗi dòng chỉ chừng 70 ký tự, nên cả trang vào khoảng 900 token theo cách đếm thô, so với hơn một triệu token ở bước 1.
Bước 5: ngân sách và thông báo cắt bớt có chỉ dẫn
Đây là lúc ráp mọi thứ lại. Anthropic nhận xét rằng thông báo cắt bớt và thông báo lỗi có thể hướng agent tới cách gọi tool tốn ít token hơn. Vì thế đừng chỉ báo “quá lớn”, hãy nói rõ agent nên dùng tham số nào ở lần gọi sau.
BUDGET = 25_000

def search_orders(status=None, region=None, min_amount=None,
                  limit=20, cursor=None, response_format="concise"):
    rows = _filter(status, region, min_amount)
    start = _decode(cursor)
    limit = max(1, min(limit, MAX_LIMIT))
    items = [_shape(r, response_format) for r in rows[start:start + limit]]
    result = {"total_matches": len(rows), "items": items}
    while estimate_tokens(result) > BUDGET and len(items) > 1:
        items = items[: len(items) // 2]
        result["items"] = items
        hint = "Narrow with status/region/min_amount"
        if response_format == "detailed":
            hint += ", switch to response_format='concise'"
        result["note"] = (f"Truncated to {len(items)} items to fit the budget. "
                          f"{hint}, or page with next_cursor.")
    end = start + len(items)
    result["next_cursor"] = _encode(end) if end < len(rows) else None
    return result
Gợi ý chuyển sang concise chỉ xuất hiện khi agent đang dùng detailed. Một chỉ dẫn bảo agent làm điều nó đã làm rồi chỉ khiến nó gọi lại y hệt.
Kiểm tra: Thử ba việc. Gọi với limit=5000 và xác nhận chỉ nhận về 50 dòng. Gọi hai lần liên tiếp với next_cursor và xác nhận hai trang không trùng nhau. Rồi tạm đặt BUDGET = 200 để thấy trường note xuất hiện và next_cursor lùi đúng theo số dòng đã cắt.
Với dữ liệu giả, 50 dòng concise còn cách xa mốc 25.000. Ngân sách là lưới an toàn cho ngày một trường ghi chú của khách dài bất thường. Trần limit đếm theo số dòng, ngân sách đếm theo kích thước, và bạn cần cả hai.
Bước 6: trả tham chiếu thay cho payload nặng
Runpod khuyên với kết quả lớn hoặc dạng nhị phân, tool nên trả một tham chiếu để agent lấy khi cần, thay vì trả nguyên payload. Đó là lý do bước 4 chỉ trả payload_ref.
def get_order_payload(payload_ref: str, max_chars: int = 2000):
    uuid = payload_ref.split(":", 1)[1]
    row = next(r for r in ORDERS if r["order_uuid"] == uuid)
    text = row["raw_payload"]
    return {"payload": text[:max_chars], "truncated": len(text) > max_chars}
Kiểm tra: Gọi search_orders(response_format="detailed"), lấy một payload_ref trong kết quả rồi truyền vào get_order_payload. Tool phụ này cũng có trần riêng, vì không có lý do gì để nó thành cửa hậu cho 4 triệu ký tự.
Còn khi agent buộc phải xem cả 10.000 dòng thì sao?
Có những câu hỏi, chẳng hạn “khu vực nào có tỷ lệ hoàn tiền cao nhất”, thực sự cần quét toàn bộ dữ liệu. Lúc đó hãy để agent viết code chạy bên ngoài model. Anthropic mô tả cách dùng code execution lọc một bộ 10.000 dòng mà agent chỉ nhìn thấy năm dòng: model nhận kết quả đã tổng hợp, không nhận dữ liệu thô.
Kể cả khi từng kết quả đều gọn, chúng vẫn chồng lên nhau qua một phiên làm việc dài. Anthropic xem việc xoá kết quả tool cũ khỏi lịch sử là một trong những dạng nén context nhẹ và an toàn nhất. Một trang đơn hàng agent đã xử lý xong không cần nằm lại trong context thêm 30 lượt nữa.
Những lỗi hay gặp
Lỗi đầu tiên là tưởng giao thức đã lo phần phân trang, trong khi phân trang của MCP không bao gồm tools/call. Lỗi thứ hai là chỉ giới hạn số dòng mà không giới hạn kích thước, nên một dòng có trường văn bản khổng lồ là đủ làm vỡ mọi thứ.
Lỗi thứ ba là thông báo kiểu “response too large” mà không chỉ cho agent đường lui, nên nó gọi lại y hệt hoặc đoán bừa. Lỗi thứ tư là chỉ trả uuid, buộc agent tốn thêm một lượt gọi chỉ để biết uuid đó là của ai.
Kỹ năng này xuất hiện thế nào ở chỗ khách?
Phép đo của Runpod được làm trên một tài khoản thật, và bài học nằm ở đó. Khi làm customer discovery, đừng chỉ hỏi API trả về những trường gì. Hãy hỏi tài khoản lớn nhất của khách có bao nhiêu bản ghi, rồi chạy bước 1 trên chính tài khoản đó trước khi demo. Tài khoản demo luôn nhỏ, tài khoản thật thì không.
Về sự nghiệp, kỹ năng này dễ chứng minh bằng số liệu. Một dòng CV như “giảm token trả về của tool tìm kiếm đơn hàng từ X xuống Y, agent hết tràn context trên tài khoản lớn nhất” thuyết phục hơn hẳn “có kinh nghiệm MCP”.
Khi đọc mô tả công việc FDE, hãy để ý xem họ có nhắc tới việc xây tool cho agent, tích hợp MCP hay kết nối agent với hệ thống của khách không. Nếu có, hãy đưa cặp số trước và sau ở trên vào CV và mang nó vào buổi phỏng vấn.
Agent chạy tốt trên dữ liệu demo mới là bản nháp. Nó chỉ thành sản phẩm khi tool đứng giữa agent và API của khách biết từ chối 9.995 dòng không cần thiết.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
5 nguồn
- Writing effective tools for agents — with agents · 2025-09-11
- Effective context engineering for AI agents · 2025-09-29
- Code execution with MCP: Building more efficient agents · 2025-11-04
- Designing MCP tools that don't blow up your agent's context window · 2026-09-02
- How Much Data Can an AI Agent Pull Through MCP? · 2026-09-03