Đổi embedding model cho RAG của khách mà không dừng dịch vụ: sáu bước diễn tập trên laptop
Vector của hai model không trộn được vào một index, nên bạn phải dựng chỉ mục mới trong lúc khách vẫn đang search, và phải giữ sẵn đường lui.

Tóm tắt nhanh
- Vector của hai model không dùng chung được, nên phải re-embed toàn bộ corpus vào một chỉ mục riêng.
- Ghi song song giữ chỉ mục mới luôn cập nhật, còn backfill insert-only không đè lên bản mới hơn.
- Đo recall theo từng nhóm truy vấn trước và trong lúc đổi alias, vì truy vấn lệch model không báo lỗi.
Đổi embedding model trông như sửa một dòng config. Thực tế, bạn đang xây lại toàn bộ chỉ mục trong lúc khách vẫn gõ truy vấn vào đó.
Zilliz nói thẳng về phần khó: trộn vector của hai model vào một ANN index thì một phần kết quả tìm được sẽ rơi hẳn vào vùng sai. Cách xử lý thực tế là re-embed vào một cột hoặc collection riêng.
Thử hình dung khách muốn chuyển sang model mới nhưng không thể tắt search để chờ bạn. Làm xong bản diễn tập dưới đây, bạn sẽ có một quy trình mang được đến khách, kèm theo lệnh quay lui đã thử thật.
Bạn sẽ dựng gì trên laptop?
Một bản diễn tập nhỏ trên bộ dữ liệu công khai BEIR SciFact, gồm 300 truy vấn và khoảng 5K tài liệu. Bên cạnh đó là hai script chạy liên tục: một script gửi truy vấn, một script sửa và xóa tài liệu, để giả lập một hệ thống đang có người dùng.
Lấy link tải scifact.zip trên wiki BEIR, rồi dựng môi trường:
unzip scifact.zip
pip install qdrant-client sentence-transformers
docker run -p 6333:6333 qdrant/qdrant
Kiểm tra: đối chiếu md5 của file tải về với giá trị trên wiki. Dữ liệu gốc SciFact theo giấy phép CC BY-NC, đủ cho diễn tập, nhưng phải kiểm tra giấy phép nếu định dùng cho mục đích thương mại.
Dùng all-MiniLM-L6-v2 làm model cũ và BAAI/bge-small-en-v1.5 làm model mới, bọc thành hai hàm tự viết embed_old và embed_new, trả về list số. Đây chỉ là lựa chọn để diễn tập, và đừng giả định model nào tốt hơn: bước 4 sẽ trả lời câu đó.
Chuẩn bị thêm golden set: các câu hỏi kèm tài liệu đúng, chia theo nhóm, mỗi nhóm ít nhất 40 câu. Lấy 300 truy vấn của SciFact làm điểm xuất phát, kiểm tra phần gán nhãn trong gói tải, rồi tự đặt quy tắc chia, ví dụ truy vấn có chứa con số và truy vấn còn lại.
Lý do của con số 40 nằm ở phép chia. Trong nhóm 10 câu, một câu sai kéo recall xuống 10 điểm phần trăm; trong nhóm 40 câu, chỉ còn 2,5 điểm. Đây là mức tạm dùng để diễn tập, không phải chuẩn thống kê.
Hai thao tác rủi ro nhất, chèn có điều kiện và đổi alias, được viết bằng lời gọi của qdrant-client; hãy đối chiếu với tài liệu của phiên bản bạn cài. Những đoạn ghi “giả mã” đã được rút gọn, tên hàm chỉ thể hiện ý định.
Bước 1: Cho ứng dụng gọi một tên ổn định
Alias là một tên cố định mà ứng dụng gọi tới, còn collection phía sau nó có thể thay đổi. Nếu ứng dụng đang gọi thẳng tên collection, hãy sửa và deploy phần này trước khi đụng tới model.
from qdrant_client import QdrantClient, models

client = QdrantClient(url="http://localhost:6333")
client.update_collection_aliases(change_aliases_operations=[
    models.CreateAliasOperation(create_alias=models.CreateAlias(
        collection_name="kb_v1", alias_name="kb_search"))
])
Kiểm tra: script truy vấn, giờ gọi kb_search, vẫn chạy và kết quả không đổi so với trước khi dùng alias.
Bước 2: Tạo kb_v2 và bật ghi song song
Zilliz khuyên ghi song song dữ liệu mới, giữ cũ và mới cạnh nhau, và chỉ chuyển truy vấn sang chỉ mục mới khi nó đã chứng tỏ chạy tốt. Hướng dẫn của Qdrant gọi đây là chế độ dual-write: mọi thay đổi đều được ghi vào cả collection cũ lẫn mới.
Bước này đứng trước backfill vì nếu chưa ghi song song, collection mới sẽ lỗi thời ngay trong lúc backfill. Lệnh xóa cũng phải chạy trên cả hai collection.
client.create_collection("kb_v2", vectors_config=models.VectorParams(
    size=len(embed_new("x")), distance=models.Distance.COSINE))

# Giả mã
def save_document(doc):
    write(kb_v1, doc.id, embed_old(doc.text), doc.meta)
    write(kb_v2, doc.id, embed_new(doc.text), doc.meta)

def delete_document(doc_id):
    delete(kb_v1, doc_id)
    delete(kb_v2, doc_id)
Kiểm tra: sửa một tài liệu rồi đọc lại bản ghi theo ID ở cả hai collection. Phần meta phải giống nhau, còn vector phải đến từ đúng model của collection đó.
Bước 3: Backfill chỉ được chèn, không được đè
Backfill là việc duyệt corpus theo lô, re-embed từng bản ghi bằng model mới rồi đưa vào chỉ mục mới. Chữ “upsert” ở bước này là một cái bẫy, nên chỉ chèn khi chưa có bản ghi mang ID đó.
Thử hình dung một ca: lúc 10:00, backfill đọc tài liệu A phiên bản 1. Lúc 10:01, khách sửa A và ghi song song đưa phiên bản 2 vào kb_v2. Lúc 10:02, một lệnh upsert thường sẽ đè phiên bản 1 lên, và kb_v2 âm thầm lùi về dữ liệu cũ.
def insert_if_absent(collection, docs, vectors):
    ids = [d.id for d in docs]  # số nguyên hoặc UUID
    found = {p.id for p in client.retrieve(
        collection, ids=ids, with_payload=False)}
    points = [models.PointStruct(id=d.id, vector=v, payload=d.meta)
              for d, v in zip(docs, vectors) if d.id not in found]
    if points:
        client.upsert(collection, points=points)

# Giả mã
for batch in scroll_corpus(batch_size=BATCH):
    insert_if_absent("kb_v2", batch, [embed_new(d.text) for d in batch])
Hàm này kiểm tra rồi mới ghi, nên giữa hai lệnh vẫn còn một khe hở nhỏ. Như vậy là đủ cho diễn tập; ở production, hãy tra xem phiên bản Qdrant của bạn có hỗ trợ chèn có điều kiện ngay phía server không.
Insert-only cũng không cứu được ca ngược lại. Nếu A bị xóa đúng lúc 10:01, lệnh chèn lúc 10:02 sẽ làm A sống lại, vì ID đó không còn trong kb_v2. Vì thế, sau backfill hãy đối chiếu tập ID của hai collection với nguồn dữ liệu gốc.
Kiểm tra: tập ID khớp nhau, và tài liệu vừa sửa trong lúc backfill mang đúng phiên bản mới nhất.
Bước 4: Đo retrieval, đừng ngắm câu trả lời
Hướng dẫn của Qdrant cảnh báo rằng model mới không tự động tốt hơn trên dữ liệu của bạn, nên phải đo trước khi chuyển traffic. Chỉ số cần nhìn, theo blog tianpan.co, là recall@k. Hãy truy vấn thẳng kb_v2 bằng embed_new trong khi alias vẫn trỏ về kb_v1, để người dùng không bị ảnh hưởng.
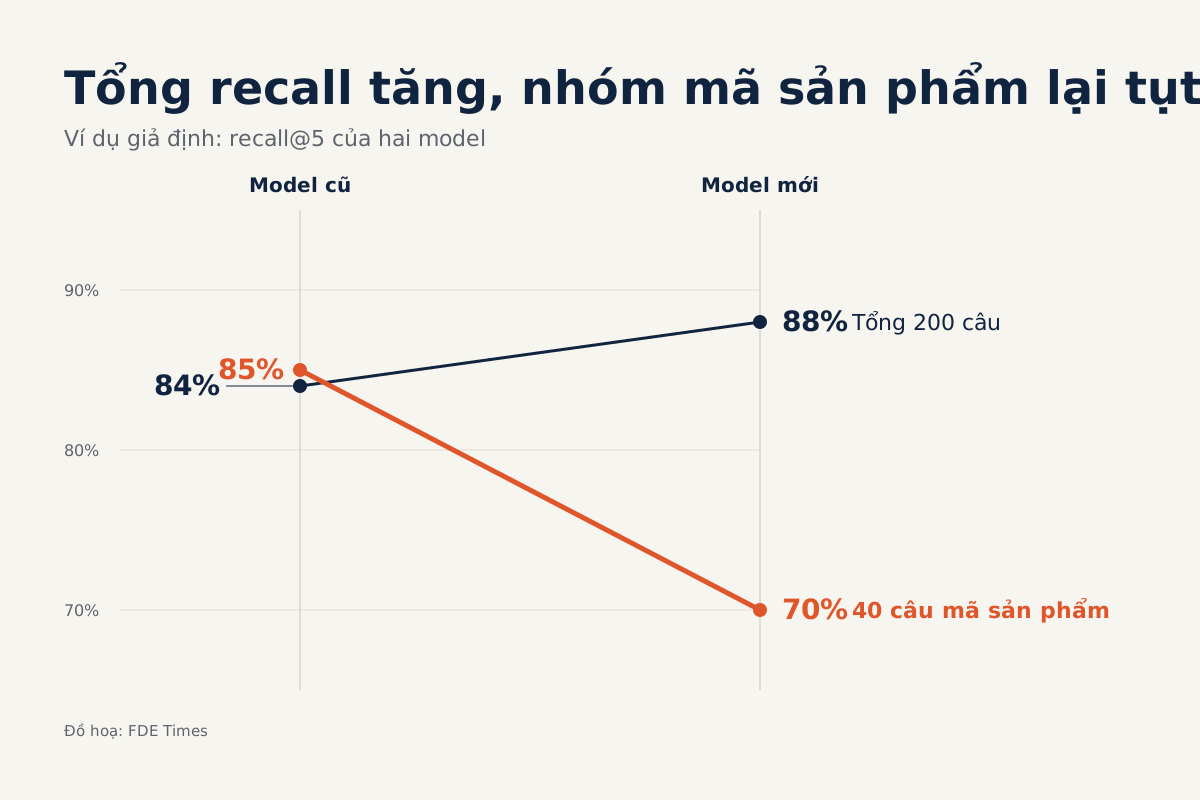
Đây là một ví dụ giả định ở một khách có 200 câu hỏi, mỗi câu có một tài liệu đúng. Model cũ tìm thấy tài liệu đúng trong top 5 ở 168 câu, tức recall@5 là 84%. Model mới đạt 176 câu, tức 88%, nên nhìn qua thì model mới đã thắng.
Giờ tách theo nhóm. Trong 40 câu hỏi chứa mã sản phẩm, model cũ đúng 34 câu còn model mới chỉ đúng 28, tức từ 85% xuống 70%. Con số tổng tăng là nhờ 160 câu còn lại, từ 134 lên 148 câu đúng.
Nếu nhóm mã sản phẩm là thứ đội hỗ trợ của khách dùng cả ngày, 88% là một con số gây hiểu lầm. Luôn báo cáo theo nhóm và thống nhất trước với khách ngưỡng nào thì được phép chuyển.
Kiểm tra: có một bảng recall@k theo từng nhóm cho cả hai model, chạy lại được bằng một lệnh.
Bước 5: Đổi alias và query model cùng một lượt
Với Qdrant, xóa và tạo lại alias trong cùng một request khiến việc đổi trở thành nguyên tử. Nhưng OneUptime lưu ý rằng thao tác này chỉ đổi đích trong database, không deploy luôn model của ứng dụng.
def swap_alias(alias, target):
    client.update_collection_aliases(change_aliases_operations=[
        models.DeleteAliasOperation(
            delete_alias=models.DeleteAlias(alias_name=alias)),
        models.CreateAliasOperation(create_alias=models.CreateAlias(
            collection_name=target, alias_name=alias)),
    ])

swap_alias("kb_search", "kb_v2")
set_query_model("new")  # giả mã: cờ cấu hình của ứng dụng
Trong khoảng lệch giữa hai dòng cuối, truy vấn embed bằng model cũ có thể đi vào chỉ mục mới. Script của bạn sẽ không thấy lỗi nào: blog tianpan.co nhận xét điểm cosine vẫn được tính ra, chỉ là vô nghĩa, và tài liệu của Voyage AI trên MongoDB cũng cảnh báo chất lượng retrieval suy giảm khi so hai model khác nhau.
Hãy in len(embed_old("x")) và len(embed_new("x")). Nếu hai số bằng nhau, database không có lý do gì để từ chối truy vấn lệch model, nên chỉ có recall mới lộ ra sự cố.
# Giả mã: chạy suốt lúc đổi, mỗi vòng lấy một mẫu golden set
while swapping:
    hits = [g.doc_id in search("kb_search", embed_current(g.q), k=5)
            for g in sample(golden, 20)]
    log(now(), current_model(), sum(hits) / len(hits))
Trên laptop, hãy cố tình chèn 30 giây chờ giữa hai dòng đổi để xem recall tụt ra sao. Ở production, một cú tụt như thế chính là dấu hiệu bạn cần nhận ra. Khi làm thật, hãy chọn giờ ít tải và báo trước cho khách.
Kiểm tra: script truy vấn không có lỗi, và recall trong log sau khi đổi quay về mức của kb_v2 ở bước 4. Riêng việc không có lỗi chưa chứng minh được gì.
Lúc nào đường lui biến mất?
Đổi alias chưa phải điểm không thể quay đầu. Chừng nào kb_v1 còn nhận ghi song song, quay lui chỉ là đảo alias và đổi lại query model, và tài liệu của Weaviate cũng coi việc trỏ alias về collection trước là một thao tác đơn giản.
Điểm khó nằm ở lúc dừng ghi song song. Qdrant lưu ý rằng quay lui sau thời điểm đó đồng nghĩa với mất mọi thay đổi về sau, vì collection cũ không còn nhận cập nhật. Khi đã xóa kb_v1, bạn không còn chỉ mục cũ để quay về.
Bước 6: Diễn tập quay lui, rồi mới dọn
Theo OneUptime, quay lui có hai phần và nên được diễn tập trước production. Trên laptop, hãy quay lui một lần trong khi hai script vẫn chạy, rồi chuyển sang kb_v2 lần nữa.
# Thiếu một trong hai dòng là lệch model
swap_alias("kb_search", "kb_v1")
set_query_model("old")  # giả mã
Sau khi chuyển hẳn, blog tianpan.co khuyên giữ chỉ mục cũ suốt một khoảng thời gian dự phòng, và ghi song song cũng nên chạy suốt khoảng đó. Tài liệu của Voyage AI cũng khuyên giữ trường và index cũ đến khi migration hoàn tất.
Kiểm tra: sửa một tài liệu sau lần chuyển, quay lui, rồi tìm thấy phiên bản mới đó trong kb_v1. Recall trong log phải về lại mức của model cũ ở bước 4.
Những lỗi đắt nhất thường trông rất vô hại
Lỗi đầu tiên là coi ghi song song như việc phụ: một phía thất bại trong im lặng và hai chỉ mục lệch nhau lúc nào không ai biết. Hãy đưa lần ghi thất bại vào hàng đợi thử lại, và đối chiếu lại ID trước khi đổi alias.
Lỗi thứ hai là quay lui mà chỉ đổi một trong hai: query model hoặc alias. Lỗi thứ ba là chấm model bằng vài câu trả lời đẹp của LLM trong buổi demo.
Đến chỗ khách, hỏi gì trước khi re-embed?
Hãy hỏi xem ứng dụng có gọi qua alias không, ai sở hữu luồng ghi dữ liệu, và ai có thể gán nhãn câu hỏi thật. Ghi song song phải sửa chính luồng ghi, nên nếu luồng đó thuộc một đội khác, hãy mời họ tham gia ngay từ đầu.
Nếu khách không chấp nhận cả khoảng lệch ngắn ở bước 5, hãy cân nhắc để mỗi request đọc một bản ghi cấu hình chứa cả cặp collection và model. Khi đó bản ghi này là công tắc duy nhất, thay cho alias.
Tiếp theo, chốt bằng văn bản ba điều: ngưỡng recall theo từng nhóm, thời gian giữ chỉ mục cũ, và người có quyền ra lệnh quay lui. Những quyết định này thuộc về khách, còn bạn là người nêu chúng ra trước khi có sự cố.
Về nghề nghiệp, đây là một dòng CV rất rõ nếu bạn có số thật: bao nhiêu tài liệu đã chuyển, recall theo nhóm thay đổi ra sao, dịch vụ có gián đoạn không, đã diễn tập quay lui chưa.
Khi đọc JD có nhắc tới RAG, hãy hỏi người phỏng vấn lần đổi model gần nhất của họ diễn ra thế nào; câu trả lời sẽ cho bạn biết đội đó đang vận hành production hay mới dừng ở demo.
Nếu mọi bước đều ổn, người dùng của khách sẽ không nhận ra model đã đổi. Thứ khách giữ lại là bảng recall và một lệnh quay lui đã thử thật, và nhờ chúng, lần đổi model sau không còn là một cuộc đàm phán căng thẳng.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
7 nguồn
- How do you change your embedding model without re-indexing everything? · 2026-06-26
- Migrate to a New Embedding Model with Zero Downtime in Qdrant
- Retiring an Embedding Model: Re-indexing Millions of Vectors Without Taking Search Down · 2026-07-05
- Zero-downtime collection migration with aliases | Weaviate Documentation
- How to Change a Qdrant Embedding Dimension with a New Collection and Alias Swap · 2026-08-28
- Migrate to a New Embedding Model - Voyage AI by MongoDB - MongoDB Docs
- Datasets available (BEIR wiki)