Thực hành RAG Việt–Anh: đo cả lỗi trả lời sai ngôn ngữ
Truy xuất đúng tài liệu mới là nửa bài toán, vì câu trả lời vẫn có thể hỏng ở đúng chỗ người dùng nhìn thấy đầu tiên: ngôn ngữ.

Tóm tắt nhanh
- Câu trả lời đúng ngôn ngữ là chỗ mọi mô hình trong XRAG đều gặp khó khi tài liệu chỉ có tiếng Anh, nên phải chấm thành cột riêng.
- Chạy cùng một kho với câu hỏi bản Việt và bản Anh, khoảng cách giữa hai kết quả cho biết phần mất do ngôn ngữ.
- Tiền tố của e5, giới hạn 512 token và prompt Ragas sau khi dịch là ba chỗ dễ làm sai lệch kết quả đo.
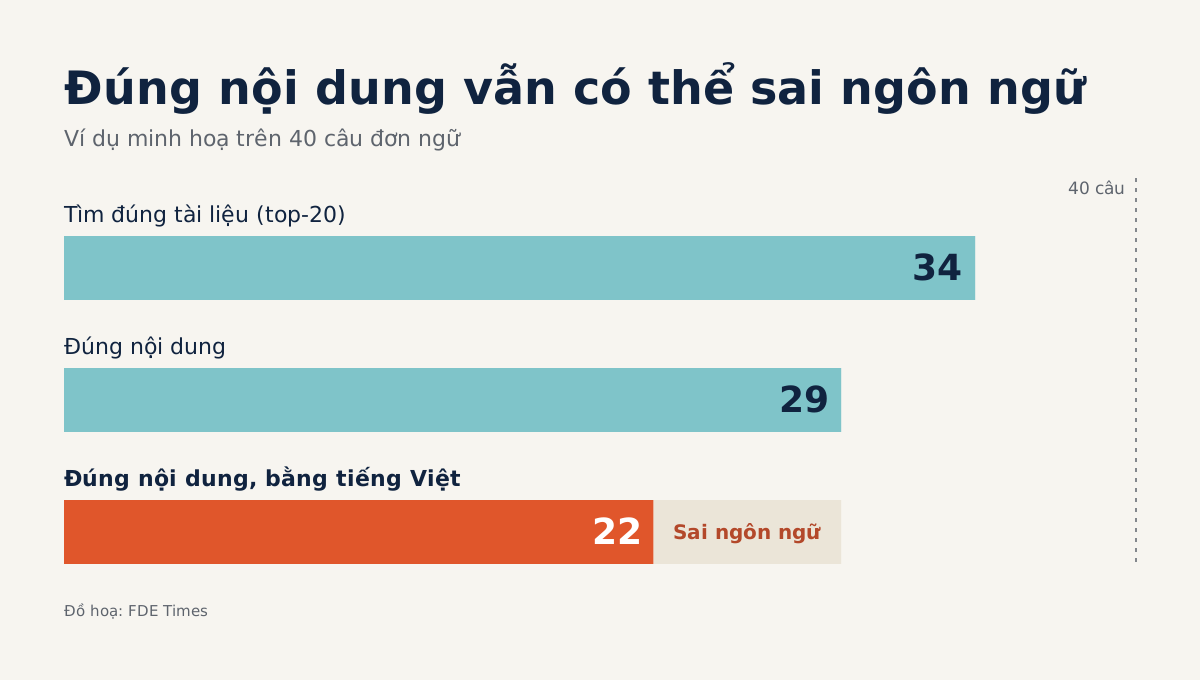
Trong XRAG, benchmark RAG xuyên ngôn ngữ do Amazon Science công bố, khi câu hỏi không phải tiếng Anh còn tài liệu truy xuất là tiếng Anh, mọi mô hình được thử đều gặp khó ở một việc tưởng như đơn giản: trả lời đúng ngôn ngữ. Hệ thống có thể tìm đúng tài liệu, hiểu đúng nội dung, rồi vẫn trả lời người dùng Việt bằng tiếng Anh.
Đó cũng là kịch bản FDE hay gặp: nhân viên của khách hỏi bằng tiếng mẹ đẻ, còn sổ tay vận hành và tài liệu kỹ thuật lại bằng tiếng Anh. Điểm đánh giá gộp sẽ che mất chỗ hỏng, nên bạn cần một bộ đo chỉ ra lỗi nằm ở tầng nào.
Hướng dẫn này dựng một pipeline nhỏ và bộ 52 câu hỏi song ngữ để đo từng tầng. Ví dụ dùng tiếng Việt, nhưng cách làm áp dụng được cho cặp ngôn ngữ khác.
Bạn cần chuẩn bị gì?
Bạn cần Python, quyền gọi một LLM, một trong hai embedding model multilingual-e5-large hoặc BGE-M3, cùng một bộ tài liệu tiếng Anh dài vài chục trang. Bạn cũng cần một người đọc được tiếng Việt để duyệt câu hỏi và câu trả lời.
Code bên dưới đã được giản lược. embed(), count_tokens() và retrieve() là hàm giả định, bạn tự nối vào thư viện đang dùng. Mọi con số về kết quả chạy đều là số minh họa.
Bước 1: Viết đề trước khi dựng hệ thống
Tập test của XRAG có 5.200 mẫu, gồm 4.000 mẫu đơn ngữ (1.000 mẫu mỗi ngôn ngữ) và 1.200 mẫu đa ngữ (300 mẫu mỗi ngôn ngữ). Đơn ngữ là khi tài liệu truy xuất chỉ có tiếng Anh; đa ngữ là khi kho trộn tiếng Anh với ngôn ngữ của câu hỏi.
Dự án khách không cần quy mô đó. Giữ tỷ lệ 10:3 ấy, bạn có một bộ khởi đầu gồm 40 câu đơn ngữ và 12 câu đa ngữ, đủ nhỏ để con người đọc từng câu trả lời. Câu hỏi nên viết từ tài liệu và tình huống thật của khách, không chép từ benchmark.
{"id": "q017", "setting": "mono",
 "question_vi": "Mã lỗi E-4021 nghĩa là gì và xử lý thế nào?",
 "question_en": "What does error code E-4021 mean and how do I fix it?",
 "gold": ["ops-manual#s12"],
 "must_contain": ["E-4021"]}
Mỗi câu có đủ hai bản vì đây là công cụ chẩn đoán chính của cả bài. Định dạng trên là tự đặt, không theo chuẩn nào.
Kiểm tra: mở đoạn tài liệu trong gold và xác nhận nó thật sự trả lời được câu hỏi. Nhờ người đọc tiếng Việt xem câu hỏi có giống cách nhân viên nói thật hay chỉ là bản dịch từng chữ.
Bước 2: Chia chunk và gắn tiền tố
Model card của multilingual-e5-large cắt văn bản ở 512 token. Thử hình dung một mục dài 3.000 token được đưa nguyên vào: 2.488 token phía sau không bao giờ đi vào vector, và câu hỏi về phần đó sẽ trượt mà không báo lỗi. Với giới hạn tự đặt 400 token, mục này cần ít nhất 8 chunk.
Cạm bẫy thứ hai nằm ở tiền tố. Model card yêu cầu mọi input bắt đầu bằng query: hoặc passage: , kể cả văn bản không phải tiếng Anh.
# Giản lược: count_tokens() và embed() là hàm giả định
def to_passage(chunk):
    text = "passage: " + chunk
    assert count_tokens(text) <= 512
    return text

def to_query(question):
    return "query: " + question

# Câu hỏi: embed(to_query(q)); tài liệu: embed(to_passage(c))
Kiểm tra: in ra vài input ngay trước khi embed và tìm đúng tiền tố ở đầu chuỗi. Lỗi này không làm chương trình dừng, nó chỉ làm kết quả tệ đi.
Bước 3: Đo hai bản câu hỏi trên cùng một kho
Chưa cần LLM ở bước này. Việc cần đo chỉ là top-20 có chứa đoạn đúng hay không, trên hai trường câu hỏi của cùng một bộ đề.
def hit_rate(rows, retrieve, field, k=20):
    hits = 0
    for r in rows:
        top = retrieve(r[field], k)  # danh sách id đoạn tài liệu
        hits += all(g in top for g in r["gold"])
    return hits / len(rows)

en = hit_rate(mono, retrieve, "question_en")
vi = hit_rate(mono, retrieve, "question_vi")
Giả sử bản Anh trúng 36/40, bản Việt trúng 30/40. Soi từng câu, bạn thấy 4 câu hỏng ở cả hai bản và 6 câu chỉ hỏng ở bản Việt.
Hai nhóm này cần hai cách sửa khác nhau. 4 câu đầu nhiều khả năng là vấn đề chunking hoặc tài liệu, đổi embedding model chưa chắc đã giúp. 6 câu sau mới là phần mất do ngôn ngữ.
Model card của e5 cũng cảnh báo ngôn ngữ ít tài nguyên có thể bị giảm chất lượng, nên đừng suy khả năng với tiếng Việt từ một điểm benchmark chung.
Kiểm tra: tắt tiền tố rồi chạy lại. Nếu bản Việt tụt xuống 26/40 như trong ví dụ minh họa, bạn vừa có một con số cho thấy tiền tố đáng giá thế nào trên dữ liệu của khách.
Bước 4: Để BM25 bắt những gì không cần dịch
Câu hỏi tiếng Việt vẫn thường giữ nguyên mã lỗi và tên sản phẩm tiếng Anh. Những chuỗi ấy không cần dịch, nên khớp từ khóa có thể tìm ra chúng ngay cả khi embedding bỏ sót. Anthropic cũng ghi nhận embedding kết hợp BM25 tốt hơn embedding đơn lẻ.
# Gộp theo thứ hạng; c=60 chỉ là giá trị khởi đầu, không phải chuẩn bắt buộc
def merge(dense_ids, bm25_ids, k=20, c=60):
    score = {}
    for ids in (dense_ids, bm25_ids):
        for rank, doc_id in enumerate(ids):
            score[doc_id] = score.get(doc_id, 0) + 1 / (c + rank)
    return sorted(score, key=score.get, reverse=True)[:k]
Theo ví dụ minh họa, bản Việt lên 34/40, tức số lượt hỏng giảm từ 10 xuống 6, hay 40%.
Nếu muốn đo tiếp bằng đúng thước này, Anthropic báo cáo trên top-20 chunk rằng Contextual Retrieval giảm 49% lượt truy xuất hỏng, thêm reranking thì giảm 67%. Đó là số của một kỹ thuật khác, nên hãy coi là gợi ý cho tầng thử tiếp theo, đừng biến thành cam kết với khách.
Kiểm tra: lọc riêng các câu có mã lỗi hoặc tên sản phẩm. Nếu BM25 giúp đúng nhóm này, kết quả có lý do rõ ràng; nếu không, xem lại cách tách token có làm vỡ chuỗi như E-4021 hay không.
Bước 5: Chấm nội dung và ngôn ngữ thành hai cột
Giờ mới nối LLM. Bạn có thể bắt đầu bằng một chỉ dẫn trong prompt: câu trả lời phải là tiếng Việt, giữ nguyên mã lỗi và tên sản phẩm. Nhưng với phát hiện của XRAG, chỉ dẫn đó là thứ cần đo, không phải thứ để tin.
import re, unicodedata

# Giản lược: tỷ lệ chữ có dấu tiếng Việt, ngưỡng 0.1 là tự chọn
VI = re.compile(r"[ăâđêôơưáàảãạấầẩẫậắằẳẵặéèẻẽẹếềểễệíìỉĩịóòỏõọốồổỗộớờởỡợúùủũụứừửữựýỳỷỹỵ]", re.I)

def looks_vietnamese(answer):
    text = unicodedata.normalize("NFC", answer)
    letters = [c for c in text if c.isalpha()]
    return bool(letters) and len(VI.findall(text)) / len(letters) >= 0.1

def grade(row, answer):
    return {"id": row["id"],
            "content": all(s in answer for s in row["must_contain"]),
            "language": looks_vietnamese(answer)}
Cột content dùng must_contain: mọi chi tiết bắt buộc phải xuất hiện nguyên văn, nên đây là chỗ để mã lỗi, con số, tên sản phẩm, những chuỗi không đổi khi đổi ngôn ngữ. Có chuỗi chưa chắc đã đúng, nên người duyệt đọc lại các câu được chấm đạt và ghi kết quả cuối vào cột này.
Cột language chỉ là bộ lọc thô, câu trả lời nhiều thuật ngữ tiếng Anh có thể bị đánh trượt oan. Hãy đọc tay những câu nằm gần ngưỡng.
Giả sử trong 40 câu có 29 câu đúng nội dung nhưng chỉ 22 câu trong số đó là tiếng Việt. Một điểm gộp sẽ không nói được điều này, còn hai cột riêng cho thấy ngay rằng việc cần sửa nằm ở prompt hoặc model sinh câu trả lời, không phải ở kho vector.
Nếu chấm bằng Ragas, hãy đọc prompt trước khi tin điểm số. Ragas điều chỉnh metric sang ngôn ngữ khác bằng cách dùng LLM dịch các ví dụ few-shot trong prompt, nên một ví dụ dịch lệch có thể làm lệch mọi lần chấm về sau. Sau khi duyệt, nên lưu lại đúng bản đó để các lần chạy so sánh được với nhau.
Bước 6: Thử kho trộn bằng 12 câu còn lại
Tài liệu khách hiếm khi sạch một thứ tiếng; kho có thể lẫn cả ghi chú nội bộ tiếng Việt. Nhóm tác giả XRAG cho biết khó khăn chính của cấu hình đa ngữ là suy luận trên thông tin truy xuất được bằng nhiều ngôn ngữ, nên bộ câu này phải ép hệ thống dùng cả hai nguồn.
Thử hình dung một câu hỏi về giới hạn tải: con số nằm trong sổ tay tiếng Anh, còn quy trình xin vượt giới hạn nằm trong ghi chú tiếng Việt. gold chứa cả hai đoạn, must_contain có một chi tiết của mỗi đoạn. Thiếu một vế là tính hỏng, kể cả khi vế còn lại rất đúng.
hit_rate() và grade() đã đòi đủ mọi phần tử nên dùng lại được nguyên. Giả sử cả hai đoạn lọt top-20 ở 10/12 câu, nhưng chỉ 6 câu trong số đó có câu trả lời đủ hai vế. 2 câu thiếu đoạn quay về sửa truy xuất, còn 4 câu đã có đủ tài liệu mà vẫn trượt là lỗi ở khâu suy luận.
Kiểm tra: mở hai đoạn gold của từng câu và xác nhận mỗi đoạn chỉ trả lời được một vế. Nếu một đoạn đã đủ trả lời cả câu, câu đó không ép được hệ thống dùng hai nguồn và cần viết lại.
Báo cáo nhóm này tách khỏi 40 câu đơn ngữ, vì hai cấu hình hỏng theo hai kiểu khác nhau: một bên ở ngôn ngữ trả lời, một bên ở suy luận xuyên ngôn ngữ.
Khi nào nên đổi sang BGE-M3?
Khi tài liệu dài khiến giới hạn 512 token trở thành vấn đề thật, BGE-M3 là ứng viên đáng thử. Nó còn gộp dense, sparse và multi-vector trong một mô hình, nên cũng đáng so với phương án dùng BM25 riêng.
| multilingual-e5-large | BGE-M3 | |
|---|---|---|
| Ngôn ngữ | 100 | Hơn 100 |
| Đầu vào tối đa | Cắt ở 512 token | Tới 8192 token |
| Tạo input | Bắt buộc query: và passage: |
Không cần thêm instruction vào truy vấn |
| Cần làm khi chuyển sang | Thêm tiền tố, chia lại chunk, embed lại kho | Bỏ tiền tố, cân nhắc lại cỡ chunk, embed lại kho |
Đừng đổi một lúc nhiều thứ. Giữ nguyên 52 câu, thay model, chạy lại đủ các bước để biết phần chênh lệch đến từ đâu.
Những lỗi khiến kết quả đo vô nghĩa
Một lỗi dễ mắc là dùng máy dịch câu tiếng Anh sang tiếng Việt để làm đề. Câu dịch có thể gọn gàng hơn cách người dùng thật gõ, nên điểm đo dễ đẹp hơn thực tế.
Cái bẫy khác là chỉnh prompt hay chunking theo đúng 52 câu đề rồi báo cáo điểm trên chính bộ đó; khi bộ đề đã thành dữ liệu để tinh chỉnh, hãy giữ riêng vài câu mới để kiểm chứng.
Cũng đừng thay model mà quên đổi input hoặc quên embed lại kho. Hệ thống vẫn chạy, chỉ có điều bạn đang đo một thứ khác với thứ bạn tưởng.
Việc đầu tiên ở chỗ khách
Trước khi viết dòng code nào, hãy xin 20 câu hỏi thật từ đội hỗ trợ hoặc vận hành, kèm tài liệu họ dùng để trả lời. Hãy hỏi thêm kho có bản tiếng Việt không, vì câu trả lời quyết định bạn cần bộ đa ngữ lớn đến đâu.
Rồi chốt với người phụ trách: “đúng ngôn ngữ” nghĩa là gì? Thuật ngữ nào phải giữ tiếng Anh, thuật ngữ nào nhất định phải dịch? Hãy ghi những thỏa thuận này vào tiêu chí chấm, để cuối dự án không ai phải tranh luận một câu trả lời lẫn thuật ngữ Anh là đạt hay trượt.
Khi đi xin việc, thứ đáng đưa ra không phải bản demo mà là báo cáo đo. Trong CV, hãy mô tả bạn đã tách lỗi truy xuất khỏi lỗi ngôn ngữ và nêu số lượt hỏng giảm được, bằng số thật của dự án.
Khi đọc job description, những dòng nhắc tới evals, tài liệu đa ngữ hay triển khai với dữ liệu khách là chỗ bạn nên đưa báo cáo này vào.
Lần tới khi khách hỏi “hệ thống có hiểu tiếng Việt không?”, câu trả lời tốt nhất không phải có hay không, mà là ba cột số đo trên chính tài liệu của họ.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!