Thực hành: làm sạch chuỗi email của khách trước khi đưa vào RAG
Một thread 12 email có thể chứa 78 bản sao nội dung, và retriever của bạn sẽ đọc lại thư cũ mỗi lần ai đó bấm Reply.

Tóm tắt nhanh
- Khi lấy thread qua API, reply nào cũng mang theo toàn bộ chuỗi trích dẫn, nên thư cũ bị lặp lại và lấn át thư mới trong embedding.
- Bỏ phần trích dẫn và chữ ký ngay lúc ingest, giữ người gửi, ngày, message_id và in_reply_to làm metadata.
- Mỗi email là một chunk, đối chiếu số chunk với số email mà API báo, và khi truy vấn thì lọc metadata trước khi tìm theo ngữ nghĩa.
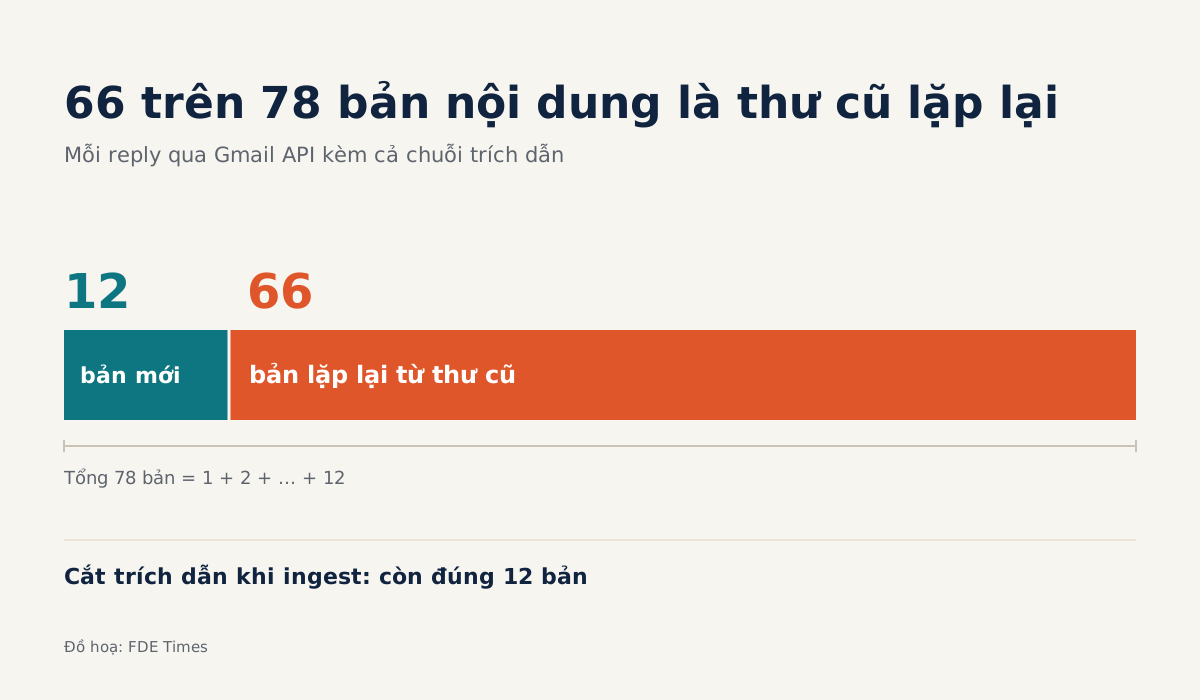
Thử hình dung một thread 12 email giữa bạn và khách. Một bài phân tích trên DEV Community chỉ ra rằng khi kéo thread này qua Gmail API, reply nào cũng được trả về kèm toàn bộ chuỗi trích dẫn bên dưới. Như vậy email thứ nhất xuất hiện 12 lần, email thứ hai 11 lần. Cộng lại, 12 email thật thành ra 1 + 2 + … + 12 = 78 bản nội dung.
Trong 78 bản đó chỉ có 12 bản là mới, phần còn lại là lặp. Một người dùng trên diễn đàn LangChain kể rằng khi chunk nguyên email, 60-80% nội dung là lịch sử được trích dẫn. Đó là quan sát thực tế chứ chưa phải số đo có hệ thống, nhưng nó khớp với phép tính ở trên.
Vì thế, khi khách hỏi “lần cuối chốt deadline là ngày nào”, retriever dễ kéo về câu chốt cũ, vì câu ấy bị lặp nhiều lần nhất. Bài này dựng một pipeline nhỏ để xử lý chuyện đó ngay từ khâu ingest. Nếu khách muốn hỏi đáp trên hộp thư của họ, đây là khâu bạn nên dựng trước tiên.
Bạn sẽ dựng gì, và cần gì?
Đầu vào là các email thô của một thread. Đầu ra là một danh sách record, mỗi record ứng với một email: phần chữ người gửi vừa viết, không có trích dẫn, không có chữ ký, kèm metadata. Danh sách trường lấy theo gợi ý trên diễn đàn LangChain: sender, recipients, date, thread_id, message_id, in_reply_to, has_attachments.
Bạn cần Python và hai thư viện mã nguồn mở. Email Reply Parser của Zapier là bản port sang Python của bộ parser GitHub, chuyên lấy phần trả lời cuối cùng trong thread. Talon của Mailgun được viết riêng để tách phần trích dẫn và chữ ký khỏi email.
pip install email_reply_parser
pip install talon
# chế độ machine learning của Talon cần extra riêng
pip install "talon[ml]"
Kiểm tra: import được cả hai thư viện trong một REPL. Chưa cần chế độ ML thì bỏ dòng thứ ba.
Bước 1: lấy người gửi và ngày trước khi đụng vào nội dung
Header phải được đọc trước. Một khi đã cắt phần trích dẫn, bạn mất luôn những dòng kiểu “Vào thứ Hai, A viết:”, vốn là chỗ duy nhất trong body cho biết ai nói gì, còn header thì vẫn nguyên vẹn. Đoạn dưới đây là phác thảo đơn giản hóa: nó dùng module email có sẵn của Python và giả định mỗi email chỉ có một phần plain-text.
Một chi tiết dễ bỏ sót: header Date là chuỗi kiểu “Mon, 3 Feb 2025 09:15:00 +0700”. Sắp xếp chuỗi này theo thứ tự chữ cái sẽ không ra thứ tự thời gian, nên hãy chuyển nó sang datetime ngay lúc đọc.
import email
from email.utils import parsedate_to_datetime

def read_headers(raw: str, thread_id: str) -> dict:
    msg = email.message_from_string(raw)
    raw_date = msg["Date"]
    return {
        "sender": msg["From"],
        "recipients": msg["To"],
        # chuỗi Date thô không sắp đúng thời gian, phải parse
        "date": parsedate_to_datetime(raw_date) if raw_date else None,
        "thread_id": thread_id,
        "message_id": msg["Message-ID"],
        "in_reply_to": msg["In-Reply-To"],
        # xấp xỉ thô: multipart chưa chắc có file đính kèm
        "has_attachments": msg.is_multipart(),
        "body": msg.get_payload(),
    }
Kiểm tra: in record của email thứ hai và thứ ba. date phải là đối tượng datetime, và in_reply_to của email thứ ba phải trùng với message_id của email mà nó trả lời. Đừng xem nhẹ trường này.
Bài trên DEV Community nhấn mạnh rằng thread email là một cây hội thoại chứ không phải một dòng thẳng, nên làm phẳng thread là mất thông tin ai trả lời ai. Giữ in_reply_to thì khi cần bạn vẫn dựng lại được cây.
Bước 2: chỉ giữ phần người gửi vừa viết
Bước này loại bỏ 66 bản lặp trong ví dụ đầu bài. EmailReplyParser.parse_reply trả về đúng phần trả lời mới nhất của một email.
from email_reply_parser import EmailReplyParser

def newest_text(body: str) -> str:
    return EmailReplyParser.parse_reply(body)
Kiểm tra: so độ dài của body với kết quả. Với email cuối của thread 12 thư, kết quả phải ngắn hơn hẳn và không còn câu nào thuộc các email trước. Thư viện này thiên về plain-text, nên nếu khách gửi nhiều email HTML, đừng mặc định nó vẫn chạy tốt: gom một bộ mẫu HTML thật của họ và đọc kết quả bằng mắt trước khi tin.
Bước 3: tách chữ ký, vì không chữ ký nào giống chữ ký nào
Bỏ xong phần trích dẫn, đuôi mỗi đoạn vẫn còn chữ ký. Bài trên DEV Community mô tả một tổ chức thật có hơn 30 kiểu chữ ký, chưa kể các disclaimer tuân thủ viết bằng nhiều ngôn ngữ. Để nguyên thì tất cả những thứ đó đều bị embed như nội dung.
Talon tách chữ ký theo hai chế độ. Chế độ dựa trên luật không cần cài thêm gì, và README của Talon tự nhận nó “nhanh và chạy rất tốt 90% số lần”. Những trường hợp còn lại dùng chế độ ML, xây trên các bộ phân loại SVM của scikit-learn và cần extra talon[ml].
Hàm này trả về một cặp gồm phần thân và chữ ký tách được; ta chỉ giữ phần thân.
from talon.signature.bruteforce import extract_signature

def strip_signature(text: str, sender: str) -> str:
    # chế độ luật: trả về (phần thân, chữ ký hoặc None)
    body, _signature = extract_signature(text)
    # chế độ ML (cần talon[ml]) nhận thêm địa chỉ người gửi;
    # chỉ chuyển sang khi test cho thấy chế độ luật bỏ sót
    return body
Kiểm tra: lấy 20 email từ 20 người gửi khác nhau và đọc bằng mắt đoạn cuối của từng kết quả. Disclaimer dài nhiều khi trông không giống chữ ký, nên hãy lập một danh sách mẫu riêng cho các disclaimer của chính khách hàng này.
Bước 4: mỗi email một chunk, và đếm bằng một con số độc lập
Hướng dẫn chunking trên theneuralbase khuyên coi mỗi email là một ranh giới tự nhiên rồi gắn metadata của thread vào. Chunk theo số token cố định sẽ cắt ngang email và trộn hai người gửi vào cùng một đoạn.
Phép kiểm mà nguồn này đề xuất là số chunk phải bằng số email. Nhưng nếu đếm lại chính danh sách vừa dựng thì phép kiểm không bao giờ sai được. Vì vậy hãy so với một con số lấy từ chỗ khác, chẳng hạn số email mà API báo cho thread, đồng thời kiểm tra không có message_id nào bị trùng.
def build_chunks(raws: list[str], thread_id: str,
                 expected_count: int) -> list[dict]:
    # expected_count: số email của thread do API báo, không đếm từ raws
    chunks = []
    for raw in raws:
        rec = read_headers(raw, thread_id)
        text = newest_text(rec.pop("body"))
        rec["text"] = strip_signature(text, rec["sender"])
        chunks.append(rec)
    ids = {c["message_id"] for c in chunks}
    assert len(ids) == len(chunks), "có email bị trùng message_id"
    assert len(chunks) == expected_count, "số chunk khác số email API báo"
    return chunks
Kiểm tra: với thread mẫu, chunk nguyên email cũng cho ra 12 chunk, nên con số 12 tự nó chưa chứng minh được gì. Điều cần thấy là mỗi chunk giờ chỉ chứa phần của một email, nghĩa là 66 bản nội dung lặp đã biến mất. Hãy tìm một câu đặc trưng của email đầu tiên trong tất cả các chunk: nó phải xuất hiện đúng một lần.
Dự án mã nguồn mở mailrag cũng xếp việc bỏ reply chain vào nhóm bước tiền xử lý cốt lõi, cạnh việc khử các chunk trùng văn bản y hệt và lọc newsletter. Hai bước đó nên chạy ngay sau khâu chia chunk này.
Bước 5: lọc metadata trước, tìm ngữ nghĩa sau
Đã có metadata sạch thì đừng bắt embedding đoán ngày. Diễn đàn LangChain nêu nguyên tắc rất gọn: lọc theo metadata trước, truy xuất theo ngữ nghĩa sau. Câu hỏi “lần cuối chốt deadline” nên chạy theo thứ tự: lọc theo thread_id, sắp theo date (đã là datetime từ bước 1) giảm dần, rồi mới xếp hạng ngữ nghĩa trong tập đã lọc.
Kiểm tra: hỏi cùng một câu hai lần, một lần có và một lần không có bộ lọc ngày. Nếu lần không lọc trả về email cũ hơn, bạn có ngay một ví dụ trước/sau đáng để cho khách xem.
Những lỗi hay gặp nhất là gì?
Lỗi đầu tiên là chỉ test trên email của chính mình. README của Email Reply Parser thừa nhận rằng mỗi client email định dạng reply một kiểu nên parse rất khó. Hãy hỏi khách đang dùng những client nào, rồi gom mẫu thật của từng loại vào bộ test.
Lỗi thứ hai là bỏ trích dẫn trước khi đọc header, để rồi có văn bản sạch mà không biết ai viết. Lỗi thứ ba là coi thread là một chuỗi thẳng. Khi hai người cùng trả lời một email, chỉ in_reply_to mới cho biết hai nhánh ấy tách ra từ đâu.
Ở dự án thật, khách sẽ kêu điều gì?
Khách hiếm khi yêu cầu “làm sạch email”. Nhiều khả năng họ sẽ phàn nàn rằng con bot trả lời theo thông tin cũ, và đó chính là triệu chứng mà phép đếm ở đầu bài giải thích.
Lời khuyên là mở đầu bằng chính phép đếm đó: lấy một thread thật của họ, đếm số bản lặp và chỉ cho họ xem, rồi mới đề xuất dành thời gian cho khâu ingest.
Khi đưa kinh nghiệm này vào CV, hãy viết kết quả đo được thay vì liệt kê tên công cụ. Ví dụ: “loại bỏ 66 trên 78 bản nội dung lặp trong một thread 12 email bằng cách cắt trích dẫn khi ingest, thêm lọc theo ngày trước khi truy xuất”. Câu này cho người phỏng vấn FDE thấy bạn hiểu dữ liệu của khách.
Nếu JD nhắc đến RAG trên dữ liệu doanh nghiệp, đây là một ví dụ đáng mang vào buổi phỏng vấn.
Mô hình tốt đến đâu cũng không cứu được một hộp thư mà email cũ nào cũng bị lặp lại cả chục lần. Muốn có câu trả lời đúng, trước hết phải dọn dữ liệu.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
6 nguồn
- mailgun/talon – GitHub
- zapier/email-reply-parser – GitHub
- Why email breaks every RAG pipeline – DEV Community
- Beginner questions & Troubleshooting: RAG Best practices for Mail Automation – LangChain Forum
- Email threads by message with thread context – Chunking strategies (theneuralbase)
- fmasi/mailrag – GitHub