Agent ghi vào CRM của khách: chỉ chạy bản kế hoạch đã được duyệt
Sửa nhầm vài trăm bản ghi khách hàng thì không có Ctrl+Z, nên agent của bạn phải viết ra một bản kế hoạch, và chỉ bản kế hoạch đã được người duyệt mới được chạy.

Tóm tắt nhanh
- Terraform đã giải bài này từ lâu: plan -out lưu bản kế hoạch ra file, và việc đưa file đó cho apply chính là lời phê duyệt
- Bước duyệt có ba lựa chọn: duyệt, sửa hoặc từ chối. Bị từ chối thì agent dừng hẳn, không thử lại
- Bước áp dụng phải kiểm tra xem dữ liệu có bị đổi từ lúc dry-run không, và ghi kèm idempotency key để retry không biến thành ghi hai lần
Với Terraform, chỉ cần đưa file kế hoạch đã lưu cho lệnh apply là đủ, vì công cụ coi chính hành động đó là lời phê duyệt. HashiCorp viết rõ điều này trong tài liệu: đưa file plan vào nghĩa là đã duyệt.
Quy ước này nhỏ, nhưng nó trả lời một câu hỏi mà mọi FDE làm agent đều gặp: làm sao biết thứ được chạy đúng là thứ con người đã xem?
Câu hỏi này khó nhất khi agent ghi vào CRM của khách. Thử hình dung agent của bạn phải cập nhật trạng thái cho vài trăm contact sau một đợt dọn dữ liệu. Nếu nó ghi sai, khách mất cả dữ liệu lẫn niềm tin vào dự án.
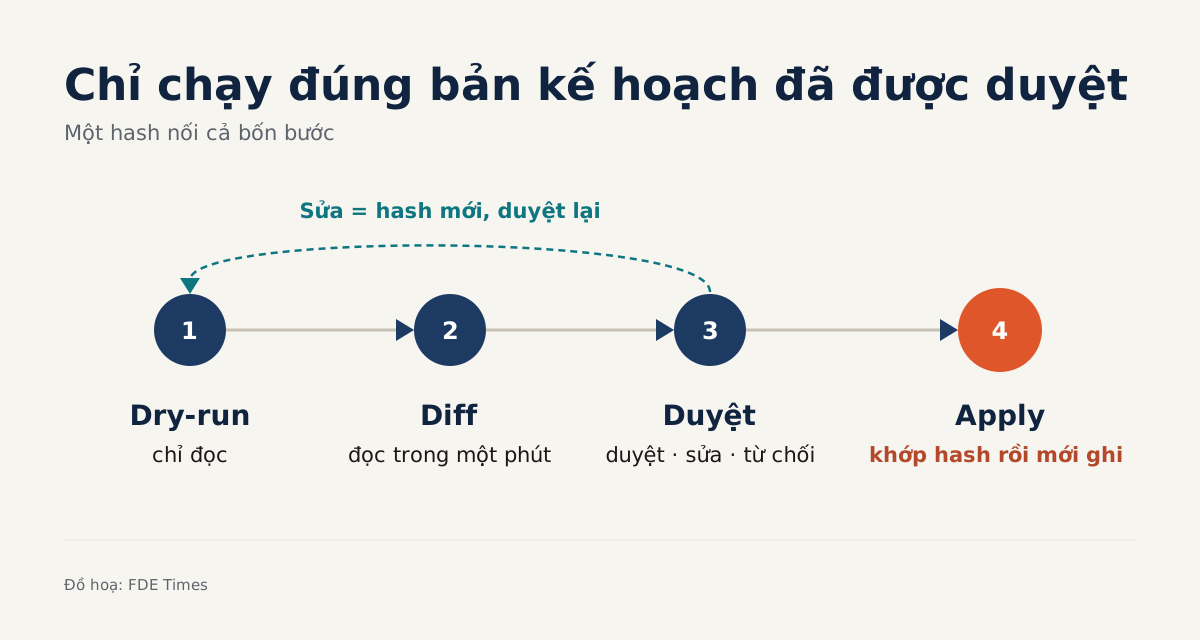
Bài này hướng dẫn bạn dựng bốn bước bảo vệ quanh mọi thao tác ghi: dry-run để sinh kế hoạch, hiển thị diff, chờ người duyệt, rồi áp dụng đúng bản đã duyệt. Code viết bằng Python và đã được đơn giản hoá. crm là một client giả định, bạn thay bằng SDK thật của khách.
Bạn cần chuẩn bị gì?
Bạn cần Python 3 và một môi trường CRM sandbox, của khách hoặc của bạn. Muốn thử mô hình gốc thì cài thêm Terraform. Đừng chạy bản đầu tiên trên dữ liệu production: Anthropic khuyên thử nghiệm kỹ trong sandbox và đặt guardrail phù hợp cho agent tự hành, và lời khuyên đó càng đúng khi agent có quyền ghi.
Trước khi viết code, hãy chạy thử mô hình gốc trên Terraform:
terraform plan -out=tfplan   # lưu kế hoạch ra file, chưa thay đổi gì
terraform apply tfplan       # đưa file vào = phê duyệt, chạy đúng bản đó
Nếu bỏ -out, Terraform chỉ tạo một speculative plan: bản mô tả tác động, không nhằm để áp dụng. Còn khi áp dụng một plan đã lưu, bạn không thể thêm chế độ hay tuỳ chọn lập kế hoạch nào khác. Bản đã xem là bản được chạy, và agent ghi CRM cũng cần đúng tính chất này.
Bước 1: dry-run chỉ được đọc
Dry-run đọc trạng thái hiện tại của từng bản ghi, so với giá trị agent muốn ghi, và chỉ giữ những trường thực sự thay đổi. Kết quả được băm SHA-256 để bản kế hoạch có một định danh duy nhất.
# Đơn giản hoá: crm là client giả định
import hashlib, json

def plan_hash(items):
    body = json.dumps(items, sort_keys=True, ensure_ascii=False)
    return hashlib.sha256(body.encode()).hexdigest()

def dry_run(changes, crm):
    items = []
    for c in changes:
        current = crm.get_contact(c["id"])   # chỉ đọc, không ghi
        diff = {f: [current.get(f), v] for f, v in c["fields"].items()
                if current.get(f) != v}
        if diff:
            items.append({"id": c["id"], "diff": diff})
    return {"hash": plan_hash(items), "items": items}
Kiểm tra: chạy hàm hai lần liên tiếp trên sandbox. Hai hash phải giống nhau, và log của CRM không được có request ghi nào. Nếu hash đổi trong khi dữ liệu không đổi, nguyên nhân thường là quên sort_keys.
Bước 2: diff phải đọc xong trong một phút
Người duyệt sẽ không đọc JSON. Họ cần thấy từng bản ghi, từng trường, giá trị cũ, giá trị mới, và tổng số bản ghi bị ảnh hưởng.
def render(plan):
    for item in plan["items"]:
        for field, (old, new) in item["diff"].items():
            print(f'{item["id"]}  {field}: {old!r} -> {new!r}')
    print(f'{len(plan["items"])} bản ghi | plan {plan["hash"][:12]}')

def save_plan(plan, path):          # vai trò giống file tfplan
    with open(path, "w", encoding="utf-8") as f:
        json.dump(plan, f, ensure_ascii=False)
File plan là thứ duy nhất đi tiếp sang bước duyệt và bước áp dụng, giống tfplan. Kiểm tra: đưa output của render cho một người không viết code, chẳng hạn admin CRM của khách. Nếu họ không trả lời được câu “cái gì sẽ đổi”, diff của bạn chưa đạt.
Bước 3: duyệt, sửa hay từ chối?
Cổng phê duyệt cho agent của Tracecat là một thiết kế đáng học. Agent dừng lại trước một tool call cần phê duyệt, và người duyệt chọn duyệt, sửa hoặc từ chối ngay trong inbox. Lệnh bị từ chối thì không chạy, và agent dừng hẳn chứ không gọi lại tool đó.
def decide(plan, path, reviewer, decision):
    assert decision in ("approve", "edit", "deny")
    approval = {"plan_hash": plan["hash"], "reviewer": reviewer,
                "decision": decision}
    with open(path + ".approval.json", "w", encoding="utf-8") as f:
        json.dump(approval, f)       # lưu ngay cạnh file plan
    return approval
Bản đơn giản này theo hai quy tắc. “Sửa” nghĩa là chỉnh danh sách thay đổi đầu vào rồi chạy lại dry-run, nên bản mới có hash mới và phải được duyệt lại. “Từ chối” thì kết thúc luôn lượt chạy: nếu agent tự diễn đạt lại yêu cầu rồi xin duyệt tiếp, người duyệt sẽ mệt và bắt đầu bấm duyệt cho xong.
Nếu bạn dựng agent bằng LangGraph, đây là chỗ đặt interrupt. Tài liệu LangGraph coi việc dừng trước một hành động quan trọng để xin phê duyệt là một trong những cách dùng interrupt phổ biến nhất. Checkpointer lưu chính xác trạng thái của graph, nên người duyệt có thể duyệt sau nhiều giờ và lượt chạy vẫn tiếp tục từ đúng chỗ đã dừng.
LangGraph cũng cảnh báo một cái bẫy: code nằm trước interrupt sẽ chạy lại khi resume, nên ở đó không được có thao tác không idempotent. Vì thế dry-run của bạn chỉ được đọc. Nếu nó ghi vào CRM dù chỉ một dòng log, lần resume sẽ ghi dòng đó thêm một lần nữa.
Bước 4: áp dụng đúng bản đã duyệt
Bước này nạp file plan cùng bản ghi phê duyệt nằm cạnh nó, rồi làm ba việc theo thứ tự: khớp hash với bản đã duyệt, kiểm tra dữ liệu chưa bị ai sửa từ lúc dry-run, rồi mới ghi. Băm lại items khi nạp file giúp phát hiện file plan bị sửa sau lúc duyệt.
Việc kiểm tra thứ hai là lập luận riêng cho bài toán CRM, không phải điều tài liệu Terraform nói. HashiCorp chỉ khuyên luôn kiểm tra lại plan cuối trước khi apply để chắc nó vẫn đúng ý định. Với CRM, giữa lúc dry-run và lúc được duyệt có thể cách nhau nhiều giờ, và trong thời gian đó nhân viên của khách vẫn sửa contact như thường.
def load(path):
    with open(path, encoding="utf-8") as f:
        plan = json.load(f)
    if plan_hash(plan["items"]) != plan["hash"]:
        raise RuntimeError("File plan đã bị sửa sau khi lưu")
    with open(path + ".approval.json", encoding="utf-8") as f:
        return plan, json.load(f)

def apply(path, crm):
    plan, approval = load(path)
    if approval["decision"] != "approve" or approval["plan_hash"] != plan["hash"]:
        raise RuntimeError("Plan chưa được duyệt hoặc đã bị thay đổi")
    # Kiểm tra toàn bộ trước, chưa ghi bản ghi nào
    for item in plan["items"]:
        current = crm.get_contact(item["id"])
        if any(current.get(f) != old for f, (old, _) in item["diff"].items()):
            raise RuntimeError(f'{item["id"]} đã đổi sau dry-run, cần plan mới')
    for item in plan["items"]:
        crm.update_contact(
            item["id"],
            {f: new for f, (_, new) in item["diff"].items()},
            idempotency_key=f'{plan["hash"]}:{item["id"]}',  # giả định
        )
Idempotency key là cách làm mượn từ Stripe. Với Stripe, nếu kết nối lỗi, bạn có thể gửi lại request với cùng key mà không sợ tạo thêm một object hay cập nhật hai lần. Stripe còn so tham số của lần gửi lại với request gốc và báo lỗi nếu chúng khác nhau, tức là mỗi key gắn chặt với đúng một payload.
Tham số idempotency_key trong đoạn code trên là giả định. Không phải CRM nào cũng hỗ trợ, nên hãy đọc tài liệu API của khách. Nếu CRM không có tính năng này, bạn tự giữ một bảng ghi các cặp hash và id đã áp dụng thành công, rồi bỏ qua chúng khi chạy lại.
Kiểm tra: ngắt mạng giữa vòng ghi, chạy lại apply, và xác nhận không bản ghi nào bị ghi hai lần. Sau đó sửa tay một contact trong sandbox rồi chạy apply. Hàm phải dừng trước khi ghi bất cứ thứ gì.
Những lỗi dễ mắc
Lỗi nguy hiểm nhất là duyệt bản này nhưng chạy bản khác: ở bước apply, agent chạy lại dry-run rồi ghi kết quả mới. Cặp plan -out và apply tfplan được thiết kế để chặn đúng lỗi này. Lỗi thứ hai là kiểm tra drift xen kẽ với việc ghi, nên khi phát hiện lệch ở bản ghi thứ 150 thì 149 bản trước đã bị ghi rồi.
Lỗi thứ ba là diff quá lớn. Một plan chạm vào hàng nghìn bản ghi sẽ được duyệt mà không ai đọc kỹ. Hãy chia thành lô nhỏ, hoặc hiển thị thống kê theo từng trường kèm vài bản ghi mẫu.
Kỹ năng này xuất hiện thế nào ở chỗ khách?
Trước buổi họp đầu tiên với khách, bạn nên chuẩn bị sẵn câu trả lời cho những câu hỏi không liên quan đến model: ai có quyền bấm duyệt, diff được gửi cho ai, và nếu ghi sai thì lấy lại dữ liệu bằng cách nào.
Nếu mang sẵn bốn bước này vào buổi họp, bạn có thể biến câu hỏi “có dám cho agent ghi không” thành một quy trình mà đội vận hành CRM của khách tự kiểm soát được.
Trong CV, đừng chỉ viết “xây agent tích hợp CRM”. Hãy viết rằng bạn đã thiết kế luồng ghi gồm dry-run, diff, phê duyệt và apply idempotent, kèm một con số như số lần ghi bị chặn vì drift.
Khi đọc JD FDE, hãy để ý các cụm như “human-in-the-loop”, “production data” hay “guardrails”, và chuẩn bị kể lại luồng bốn bước này như một ví dụ cụ thể nếu được hỏi về system design.
Khách sẽ quên bạn dùng model nào. Thứ họ nhớ là agent chưa từng ghi một dòng nào mà họ chưa được xem trước.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!