Một chức danh, ba công việc: đọc tin tuyển FDE của Together AI như đọc spec
Cả ba tin đều tuyển Forward Deployed Engineer, hai trong số đó công bố mức OTE 270.000–300.000 USD, nhưng người kiểm tra cluster GPU, người tinh chỉnh inference và người lo post-training phải chuẩn bị những thứ rất khác nhau.

Tóm tắt nhanh
- Ở Together AI, chức danh FDE dẫn tới ba công việc khác nhau: kiểm tra cluster GPU, tối ưu inference và post-training.
- Các động từ trong tin tuyển dụng như chọn, cấu hình, tối ưu, kiểm thử chính là bản mô tả việc bạn sẽ làm hằng ngày.
- Với mỗi dòng yêu cầu, hãy làm sẵn một bằng chứng có số đo trả lời được câu khách hàng sẽ hỏi.
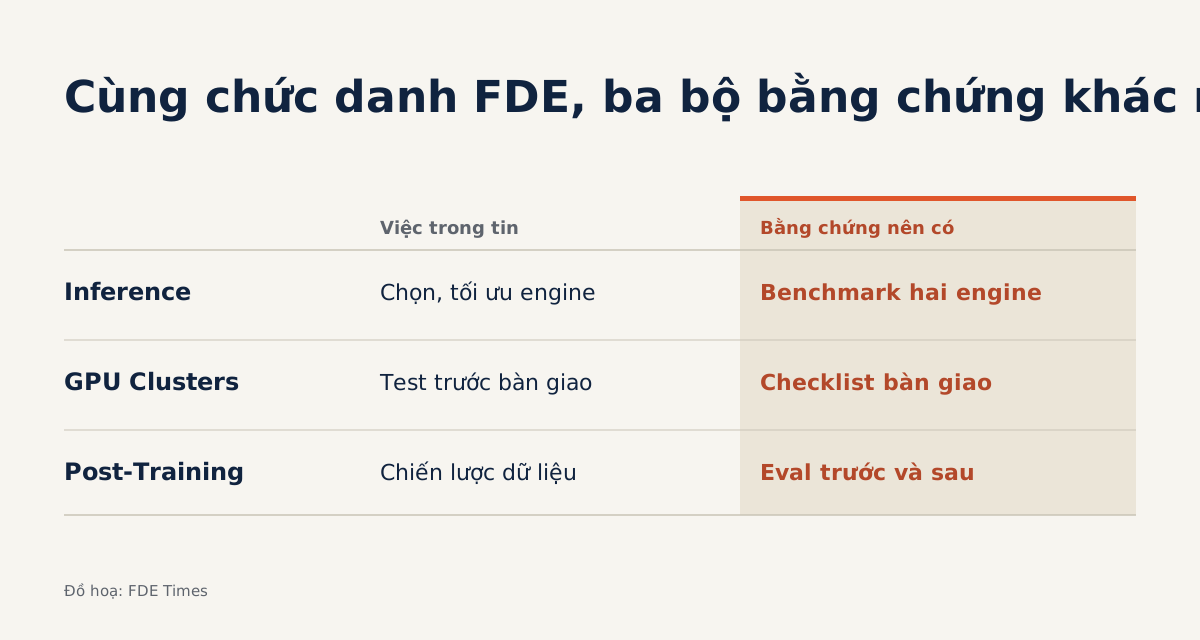
Trong các tin tuyển của Together AI trong năm 2026, cùng một chức danh Forward Deployed Engineer dẫn tới ba công việc. Người thứ nhất kiểm tra cluster GPU trước khi giao cho khách. Người thứ hai chọn và tinh chỉnh inference engine. Người thứ ba giúp khách chọn cách post-training và xây chiến lược dữ liệu.
Nếu đọc lướt rồi ôn “FDE nói chung”, bạn có thể mất cả tháng luyện system design và bài tập thuật toán, trong khi tin tuyển lại xoay quanh những câu như vì sao một engine chạy chậm trên một loại phần cứng nhất định.
Đọc tin tuyển dụng cũng là một kỹ năng. Nó gần với việc FDE làm ở công ty khách: nhận một yêu cầu viết bằng ngôn ngữ kinh doanh, rồi dịch thành việc kỹ thuật có thể đo được.
Ba tin của Together AI là ví dụ tốt để luyện kỹ năng này vì cả ba đều cụ thể, và cùng một cách đọc dùng được cho tin FDE ở bất kỳ công ty hạ tầng AI nào.
Ba tin, ba công việc khác nhau
Tin Strategic Inference giao cho FDE việc chọn, cấu hình và tối ưu inference engine cho từng khách. Tin đòi kinh nghiệm thực chiến ở mức chuyên gia với các engine như vLLM, TensorRT-LLM hay SGLang.
Tin GPU Clusters xoay quanh hạ tầng: chạy bộ test trước khi bàn giao cluster cho khách, và debug các nút thắt ở tầng thấp trong mạng InfiniBand cũng như topology NVLink. Tin này đã được gỡ xuống ngày 8/6/2026, nhưng vẫn là tài liệu tham khảo tốt để hiểu biến thể FDE thiên về hạ tầng.
Theo trang sản phẩm của Together AI, cluster của họ trải từ loại tự phục vụ dựng ngay được đến quy mô hàng nghìn GPU. Ở quy mô ấy, một node lỗi lọt qua khâu kiểm tra không còn là chuyện nội bộ mà trở thành sự cố trong hệ thống của khách.
Tin Post-Training giao cho FDE việc đề xuất cách post-training phù hợp với từng use case, và giúp khách xây chiến lược dữ liệu đi kèm.
Hai tin Inference và Post-Training công bố cùng một khoảng lương cơ bản tại Mỹ: 270.000–300.000 USD OTE. Mức lương như nhau, nhưng phần việc và cách chuẩn bị thì khác hẳn.
Động từ trong tin là việc bạn làm mỗi ngày
Khi đọc tin, hãy để ý động từ trước, sau đó mới đến danh từ. Tin Inference viết rằng FDE chọn, cấu hình và tối ưu inference engine theo phần cứng, kiến trúc model và đặc điểm workload.
Một câu có ba động từ và ba biến số. Vì thế khi ôn, hãy tập trả lời được câu: nếu chỉ đổi một trong ba biến số đó, bạn sẽ chỉnh gì trước và vì sao.
Tin GPU Clusters dùng các động từ “thiết kế và thực thi” bộ test trước khi bàn giao, và kể tên NCCL, DCGM, GPU Burn. Cụm từ “trước bàn giao” cho thấy bộ test này là chốt chặn cuối cùng trước khi cluster đến tay khách.
NCCL test kiểm tra băng thông giao tiếp giữa các GPU qua các phép như all-reduce. DCGM chạy chẩn đoán sức khỏe của từng GPU. GPU Burn ép GPU chạy tải nặng kéo dài để lỗi lộ ra trước khi khách gặp phải.
Ví dụ: dịch tin Inference thành một dự án luyện tập
Thử hình dung khách của bạn chạy một chatbot hỗ trợ khách hàng, lưu lượng cao, mỗi prompt dài vì kèm lịch sử hội thoại, còn câu trả lời thì ngắn. Đây là một workload profile cụ thể: nặng ở phần prefill, nhẹ ở phần decode. Với workload như vậy, bạn sẽ chỉnh gì trước?
Tin Inference kể tên ba đòn bẩy: tinh chỉnh KV cache, áp dụng speculative decoding và chọn mức tensor parallelism tối ưu. KV cache lưu key và value của các token đã xử lý để không phải tính lại, đổi lại tốn bộ nhớ GPU.
Speculative decoding để một model nhỏ đoán trước vài token, model lớn chỉ cần kiểm tra lại. Tensor parallelism chia ma trận của từng layer cho nhiều GPU.
Có một chi tiết đáng chú ý: hai kỹ thuật phù hợp nhất với chatbot này lại không được nhắc tên trong tin.
Tài liệu của vLLM giải thích rằng automatic prefix caching chỉ rút ngắn phần prefill, và với hội thoại nhiều lượt, nó cho phép tái dùng kết quả đã tính thay vì xử lý lại toàn bộ lịch sử chat mỗi lần.
Prefill chính là phần nặng nhất của workload này, nên bật prefix caching là nước đi đầu tiên.
Nước thứ hai là chunked prefill. Theo tài liệu vLLM, kỹ thuật này gộp các phần prefill lớn vào cùng batch với các request đang decode và ưu tiên decode, nhờ đó cải thiện inter-token latency. Với prompt dài, nó giữ cho người dùng khác không bị khựng giữa câu trả lời mỗi khi một prompt nặng đi vào.
Speculative decoding để sau. Tài liệu vLLM nói nó chủ yếu giúp giảm inter-token latency khi QPS ở mức trung bình đến thấp và workload bị giới hạn bởi bộ nhớ. Chatbot lưu lượng cao, câu trả lời ngắn không nằm trong vùng đó, nên bật nó trước tiên là tốn công mà khó thấy lợi.
Câu trả lời tốt vì thế có dạng: đo time to first token và inter-token latency hiện tại, bật prefix caching rồi đo lại, thêm chunked prefill rồi đo lần nữa, và chỉ thử speculative decoding nếu số đo cho thấy decode mới là nút thắt. Từ đó, bạn có thể biến từng dòng yêu cầu trong tin thành một bảng chuẩn bị:
| Dòng trong tin | Câu khách sẽ hỏi | Bằng chứng nên có |
|---|---|---|
| Chọn engine theo phần cứng và workload | “Nên dùng vLLM, SGLang hay TensorRT-LLM?” | Benchmark hai engine trên cùng model, cùng bộ prompt |
| KV cache tuning | “Vì sao tăng số người dùng đồng thời là hết bộ nhớ?” | Đồ thị throughput khi thay đổi giới hạn bộ nhớ dành cho cache |
| Speculative decoding | “Làm sao để câu trả lời ra nhanh hơn?” | Đo latency khi bật và tắt draft model, ghi rõ khi nào nó không giúp được |
| Tensor parallelism | “Model không vừa một GPU thì làm sao?” | So sánh latency và throughput khi chia model trên số GPU khác nhau |
| Tối ưu theo workload profile | “Chatbot của tôi nên bật gì trước?” | Số đo TTFT và ITL sau từng bước, theo đúng thứ tự ở trên |
Cột thứ ba quan trọng nhất. “Đã dùng vLLM” không chứng minh được kinh nghiệm thực chiến ở mức chuyên gia. Một repo có script benchmark, số đo và một đoạn giải thích vì sao kết quả ra như vậy thì chứng minh được.
Áp cùng cách cho hai tin còn lại
Với tin GPU Clusters, câu khách sẽ hỏi gần như luôn là: “Cluster này đã sẵn sàng chưa?”. Bằng chứng tốt là một checklist bàn giao bạn tự viết, ghi rõ chạy test nào theo thứ tự nào, ngưỡng nào thì đạt, gặp lỗi thì xử lý ra sao.
Nếu không có cluster lớn để thử, chỉ cần thuê vài GPU trong vài giờ để chạy NCCL test và DCGM diagnostics, rồi giải thích từng kết quả. Băng thông all-reduce thấp hơn kỳ vọng là điểm xuất phát tự nhiên để luyện phần debug InfiniBand và NVLink mà tin yêu cầu.
Với tin Post-Training, hai cụm đáng chú ý là “cách post-training phù hợp với từng use case” và “chiến lược dữ liệu”. Chúng gợi ý rằng phần khó nằm ở việc chọn đúng cách làm và đúng dữ liệu nhiều hơn ở bản thân model.
Bằng chứng nên có là một lần fine-tune model nhỏ, kèm bộ eval làm trước khi train, một bảng so sánh trước và sau, và một đoạn ngắn giải thích vì sao bạn chọn cách đó cho use case đó.
Ở cả ba tin, cách viết CV giống nhau. Thay “Kinh nghiệm vLLM, KV cache” bằng một câu có bối cảnh, thứ bạn đã thay đổi, và con số đo được trước và sau. Một dòng như vậy cho người đọc thấy nguyên nhân và kết quả, thay vì một danh sách từ khóa.
Những lỗi hay gặp khi chuẩn bị
Lỗi phổ biến nhất là ôn một biến thể chung chung. Người nộp vào vị trí Inference mà chỉ nói về RAG và prompt sẽ lạc đề, cũng như người ứng tuyển một vị trí kiểu GPU Clusters mà chưa từng đọc output của một bài NCCL test.
Lỗi thứ hai là dừng ở tầng kiến trúc. Nếu câu trả lời phỏng vấn của bạn chỉ có sơ đồ hệ thống mà không xuống tới cấu hình engine, rất có thể bạn chưa chạm tới phần việc mà tin mô tả: chọn, cấu hình và tối ưu.
Lỗi thứ ba là học thuộc danh sách kỹ thuật trong tin rồi áp cho mọi workload. Ví dụ chatbot ở trên cho thấy kỹ thuật được kể tên chưa chắc là nước đi đầu tiên; người phỏng vấn muốn nghe bạn suy luận từ workload ra lựa chọn, kèm số đo.
Lần tới khi mở một tin tuyển FDE, đừng hỏi mình có đủ điều kiện không. Hãy hỏi với mỗi dòng trong tin, bạn đã có bằng chứng nào trên GitHub để cho người ta xem.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
7 nguồn
- Forward Deployed Engineer, Strategic Inference (Together AI, Greenhouse)
- Forward Deployed Engineer (GPU Clusters) – Together AI (Built In)
- Forward Deployed Engineer, Post-Training (Together AI, General Catalyst jobs)
- Together AI Products
- Automatic Prefix Caching (vLLM docs)
- Optimization and Tuning (vLLM docs)
- Speculative Decoding (vLLM docs)