Thực hành RAG nhiều lượt: viết lại câu hỏi nối tiếp rồi đo bằng bộ test của chính bạn
Chatbot của khách hàng trả lời tốt ở câu đầu rồi kém dần từ lượt thứ ba. Nguyên nhân thường là một đại từ mà bộ truy xuất không hiểu, và bạn chỉ chứng minh được mình đã sửa xong khi có một bộ test chia theo lượt hội thoại.

Tóm tắt nhanh
- Bộ truy xuất không biết "cái đó" là gì. Trên benchmark mtRAG, viết lại truy vấn luôn cho kết quả truy xuất tốt hơn so với chỉ dùng câu hỏi ở lượt cuối.
- Mô hình yếu nhất ở các lượt về sau và ở câu hỏi không có câu trả lời, nên bộ test phải có đủ hai loại này.
- Bước viết lại làm tăng độ trễ và chi phí. Hãy bỏ qua nó ở lượt đầu, chạy bằng mô hình rẻ hơn, và tắt hẳn khi khách hàng không cần xử lý tham chiếu trong hội thoại.
Thử hình dung chatbot nội bộ của một khách hàng nhận ba câu hỏi liền nhau. “Nhân viên thử việc được nghỉ phép năm bao nhiêu ngày?” “Còn hợp đồng thời vụ thì sao?” “Cái đó có được cộng dồn không?” Hai câu đầu được trả lời trôi chảy. Đến câu thứ ba thì bot đáp một thứ chẳng liên quan.
Mô hình ngôn ngữ không hỏng ở chỗ này. Lỗi nằm ở bước trước đó. Một hướng dẫn về CondenseQuestionChatEngine của LlamaIndex mô tả đúng tình huống này: bộ truy xuất hoàn toàn không biết “that” là gì. Khi câu “cái đó có được cộng dồn không?” được embed nguyên văn, nó có thể khớp với bất kỳ tài liệu nào nhắc đến chuyện cộng dồn.
Nếu bạn làm FDE, demo của bạn thường chỉ có một lượt hỏi, còn người dùng thật của khách hàng thì hỏi thành chuỗi. Bài này đi qua một quy trình bạn làm được ngay trên laptop: dựng bộ test nhiều lượt, đo baseline, thêm bước viết lại câu hỏi, rồi đọc kết quả sao cho đủ sức thuyết phục khách hàng.
Benchmark nói gì về các lượt sau?
mtRAG là benchmark RAG hội thoại do con người tạo, gồm 110 cuộc hội thoại thuộc 4 miền, trung bình mỗi cuộc 7,7 lượt, tổng cộng 842 tác vụ. Nhóm tác giả rút ra hai kết luận nên định hướng cách bạn dựng bộ test.
Mọi mô hình đều gặp khó, rõ nhất ở câu hỏi không có câu trả lời và ở các lượt về sau. Ngoài ra, chiến lược viết lại truy vấn luôn truy xuất tốt hơn so với chỉ dùng câu hỏi ở lượt cuối.
Tuy vậy, viết lại không giải quyết được hết. Cũng theo mtRAG, câu hỏi không độc lập vẫn là điểm khó, dù viết lại có giúp. Phiên bản MTRAG-UN ra năm 2026 tập trung đúng vào nhóm khó này: câu hỏi không thể trả lời, câu hỏi thiếu thông tin và câu hỏi không độc lập, với 666 tác vụ, hơn 2.800 lượt hội thoại trên 6 miền.
Vì vậy, bộ test của bạn cần đo được ba điều tách bạch: lượt thứ mấy, câu hỏi có tự đứng được hay không, và câu hỏi có câu trả lời hay không.
Bước 1: Dựng bộ test trước khi viết code
Bạn cần một pipeline RAG đang chạy (bất kỳ vector store nào), một mô hình gọi được qua API, và Python. Các đoạn code dưới đây đã được đơn giản hoá: retrieve và call_llm là hai hàm bạn tự nối vào hệ thống của mình, không phải API của thư viện nào.
Mỗi dòng trong file JSONL là một lượt hỏi, kèm lịch sử đến lượt đó:
{"conv_id": "hr-01", "turn": 3,
 "history": [["user", "Nhân viên thử việc được nghỉ phép năm bao nhiêu ngày?"], ["bot", "..."],
             ["user", "Còn hợp đồng thời vụ thì sao?"], ["bot", "..."]],
 "question": "Cái đó có được cộng dồn không?",
 "type": "non_standalone",
 "gold_doc_ids": ["leave-seasonal-carryover"]}
Trường type nhận một trong ba giá trị standalone, non_standalone hoặc unanswerable. Với câu không có câu trả lời, để gold_doc_ids rỗng. Câu hỏi nên lấy từ log thật của khách hàng, đã ẩn danh, vì người dùng thật hỏi cụt hơn hẳn những câu bạn tự nghĩ ra.
Kiểm tra: đếm số dòng theo type và theo turn. Nếu gần như toàn bộ là lượt 1 và standalone thì bộ test đang đo cái demo của bạn chứ chưa đo sản phẩm thật.
Bước 2: Đo baseline chỉ với câu hỏi lượt cuối
import json
from collections import defaultdict

def hit_at_k(retrieved_ids, gold_ids):
    return any(d in gold_ids for d in retrieved_ids)

def evaluate(rows, make_query, k=5):
    buckets = defaultdict(lambda: [0, 0])  # hit, total
    for r in rows:
        if r["type"] == "unanswerable":
            continue  # đo riêng ở bước 4
        q = make_query(r["history"], r["question"])
        ids = [d.id for d in retrieve(q, k=k)]
        key = (r["type"], "turn1" if r["turn"] == 1 else "turn2+")
        buckets[key][0] += hit_at_k(ids, r["gold_doc_ids"])
        buckets[key][1] += 1
    for key, (h, n) in sorted(buckets.items()):
        print(key, f"{h}/{n}")

rows = [json.loads(l) for l in open("multiturn_eval.jsonl")]
evaluate(rows, lambda history, q: q)  # baseline: chỉ lượt cuối
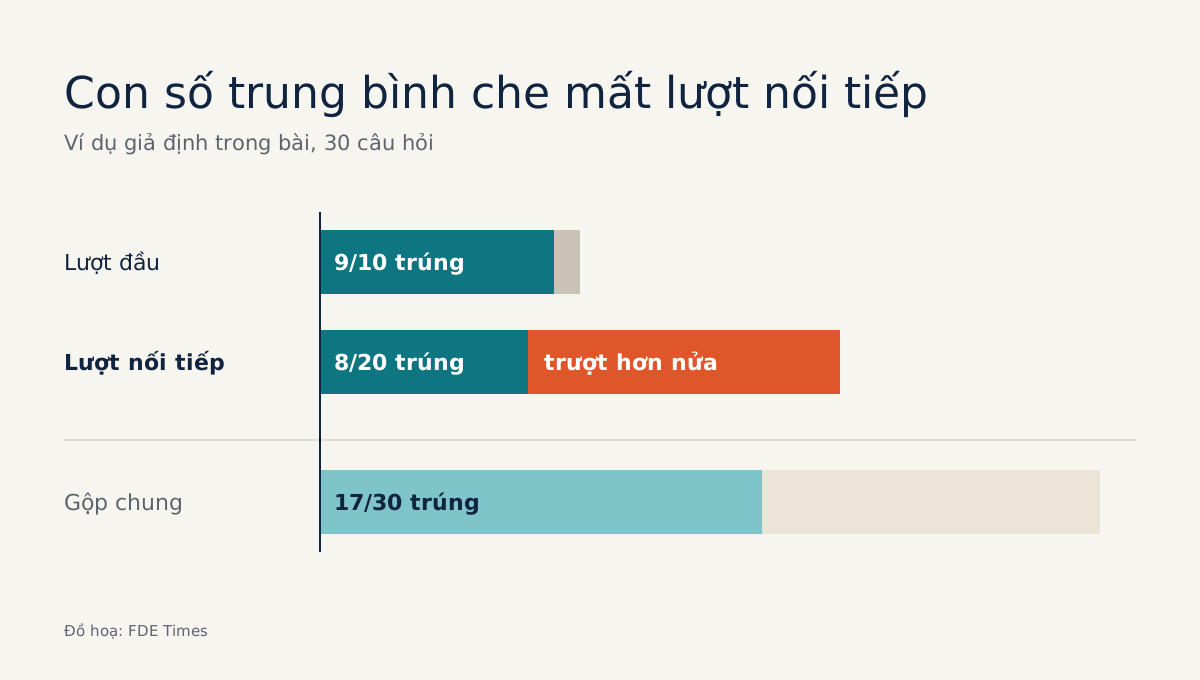
Kiểm tra: in kết quả theo từng nhóm, đừng gộp thành một số trung bình. Giả sử bộ test có 10 lượt đầu và 20 lượt nối tiếp, baseline trúng 9/10 ở lượt đầu và 8/20 ở lượt nối tiếp. Trung bình 17/30 trông tạm được, nhưng nó che mất một sự thật là hệ thống trượt hơn nửa số câu hỏi nối tiếp.
Bước 3: Viết lại câu hỏi, nhưng chỉ khi đã có lịch sử
Mục tiêu của bước này là biến câu hỏi nối tiếp thành một truy vấn tự đứng được để đem đi truy xuất. Có một chi tiết thiết kế nên giữ, mà tài liệu của thư viện RAGLight cũng làm như vậy: nếu lịch sử rỗng thì không gọi thêm mô hình.
REWRITE_PROMPT = """Dựa vào lịch sử hội thoại, viết lại câu hỏi cuối
thành một câu hỏi tự đứng được, thay mọi đại từ bằng đối tượng cụ thể.
Không trả lời câu hỏi. Chỉ trả về câu đã viết lại.

Lịch sử:
{history}

Câu hỏi cuối: {question}"""

def rewrite_query(history, question):
    if not history:
        return question  # lượt đầu: không tốn thêm lệnh gọi mô hình
    text = "\n".join(f"{role}: {msg}" for role, msg in history[-6:])
    return call_llm(REWRITE_PROMPT.format(history=text, question=question))

evaluate(rows, rewrite_query)
Với ví dụ nghỉ phép, kết quả bạn mong đợi là một câu kiểu “Ngày nghỉ phép năm của nhân viên hợp đồng thời vụ có được cộng dồn sang năm sau không?”. Việc chỉ giữ 6 tin nhắn gần nhất là một lựa chọn đơn giản hoá. Hãy chỉnh con số này theo độ dài hội thoại thật của khách hàng.
Kiểm tra: đừng chỉ nhìn điểm. Hãy in câu đã viết lại cạnh câu gốc cho từng lượt non_standalone. Nếu mô hình trả lời luôn thay vì viết lại, hoặc chèn vào một chi tiết không có trong lịch sử, bạn phải sửa prompt trước khi tin vào bất kỳ con số nào.
Bước 4: Đo riêng câu hỏi không có câu trả lời
Truy xuất tốt hơn có thể sinh ra một tác dụng phụ: bot tự tin hơn khi trả lời những câu mà tài liệu không hề đề cập. Theo mtRAG, đây chính là nhóm mọi mô hình đều yếu. Bạn hãy chạy toàn bộ pipeline với các dòng unanswerable và kiểm tra xem bot có nói rõ là không tìm thấy thông tin hay không.
REFUSAL_MARKERS = ["không tìm thấy", "không có thông tin"]  # đơn giản hoá

unans = [r for r in rows if r["type"] == "unanswerable"]
ok = sum(any(m in answer(r).lower() for m in REFUSAL_MARKERS) for r in unans)
print(f"Từ chối đúng: {ok}/{len(unans)}")
So khớp chuỗi là cách làm thô. Khi bộ test lớn hơn, bạn có thể thay bằng một người chấm hoặc một mô hình chấm có rubric. Dù làm cách nào, chỉ số này phải nằm cạnh hit@k trong mọi báo cáo bạn gửi khách hàng.
Bước 5: Tính chi phí trước khi bật cho mọi người dùng
Bước viết lại không miễn phí. Tài liệu RAGLight khuyên để tắt tuỳ chọn này nếu độ trễ và chi phí mô hình quan trọng hơn việc xử lý tham chiếu trong hội thoại.
Có hai cách giảm giá: không viết lại ở lượt đầu như code trên, và dùng mô hình rẻ hơn cho bước này. Hướng dẫn LlamaIndex lấy ví dụ dùng gpt-3.5-turbo cho việc viết lại.
Cách ra quyết định khá đơn giản. Hãy chạy lại Bước 3 với mô hình rẻ. Nếu số câu nối tiếp được truy xuất trúng gần như không đổi, bạn đã có câu trả lời. Còn nếu log cho thấy người dùng của khách hàng gần như chỉ hỏi một câu rồi thôi, thì kết quả đo được là lý do chính đáng để không bật bước viết lại.
Lỗi hay gặp và cách nó hiện ra ở khách hàng
Lỗi phổ biến nhất là bộ test chỉ toàn lượt đầu. Lỗi thứ hai là bỏ hẳn câu không có câu trả lời, nên bản viết lại trông như một cải tiến thuần tuý. Lỗi thứ ba là chấm điểm mà không đọc câu đã viết lại, đến khi khách hàng phát hiện bot tự bịa thêm điều kiện thì đã muộn.
Viết lại câu hỏi cũng chưa phải điểm dừng. Nghiên cứu SELF-multi-RAG cho rằng hệ thống hội thoại còn phải tự quyết định khi nào cần truy xuất, và nhóm tác giả ghi nhận chất lượng phản hồi tăng khoảng 13% theo đánh giá của người chấm.
Con số này đo chất lượng câu trả lời, không phải recall, nên đừng mang nó ra so với hit@k của bạn.
Ở phía khách hàng, kỹ năng này thường xuất hiện dưới dạng một lời phàn nàn mơ hồ như “bot càng nói càng ngớ ngẩn”. Bạn có lợi thế nếu trả lời được bằng một bảng chia theo lượt và theo loại câu hỏi.
Khi đọc JD, hãy để ý các cụm như “evaluation”, “conversational”, “retrieval quality”. Trong CV, hãy ghi bạn đã dựng bộ eval nhiều lượt và cải thiện được nhóm câu hỏi nào, đó là bằng chứng mạnh hơn nhiều so với câu “đã làm RAG”.
Lần tới khi chatbot của khách hàng bắt đầu trả lời lạc đề, việc đầu tiên nên làm là mở log ra và đếm xem bao nhiêu câu hỏi bắt đầu bằng “còn”, “cái đó”, “vậy thì”.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
5 nguồn
- MTRAG: A Multi-Turn Conversational Benchmark for Evaluating Retrieval-Augmented Generation Systems · 2025-01-07
- MTRAG-UN: A Benchmark for Open Challenges in Multi-Turn RAG Conversations · 2026-02-26
- Query reformulation
- CondenseQuestionChatEngine: reformulating follow-ups · 2026-04-15
- Learning When to Retrieve, What to Rewrite, and How to Respond in Conversational QA · 2024-09-23