Hai site pilot cho bạn con số DiD, không cho bạn khoảng tin cậy
Thay sai số cluster bằng kiểm định giả theo thời gian và hoán vị site, rồi nói rõ giới hạn power.
Tóm tắt nhanh
- Khi chỉ vài site được can thiệp, sai số chuẩn thông thường và cluster-robust bị đánh giá thấp nghiêm trọng, nên đừng đưa chúng vào báo cáo.
- Dùng kiểm định giả: dời ngày bắt đầu về quá khứ, và gán vai pilot cho từng cặp site đối chứng.
- Pre-trend phẳng không chứng minh xu hướng song song, và số site pilot ít đặt giới hạn cho p-value nhỏ nhất bạn có thể đạt.
Khách hàng cho bạn triển khai agent hỗ trợ ở hai trung tâm chăm sóc khách hàng, mười trung tâm còn lại chạy như cũ. Ba tháng sau, giám đốc vận hành hỏi đúng một câu: công cụ này có thật sự rút ngắn thời gian xử lý cuộc gọi không? Không ai chia ngẫu nhiên từ đầu, và hai site thì quá ít để chạy A/B test.
Đây là tình huống quen thuộc của FDE. Difference-in-differences (DiD) cho bạn một con số tác động khá dễ hiểu. Cái bẫy nằm ở chỗ khác: phần mềm thống kê sẽ tự in kèm một khoảng tin cậy trông rất gọn gàng, nhưng với hai site thì khoảng đó gần như luôn hẹp hơn thực tế.
Hướng dẫn này đi qua năm bước trên laptop để tính DiD, kiểm tra nó bằng các phép thử giả, và viết một báo cáo không hứa quá điều dữ liệu chứng minh được. Toàn bộ số liệu dưới đây là ví dụ giả định. Code là phiên bản rút gọn để minh hoạ, chỉ dùng pandas và thư viện chuẩn của Python.
Bạn cần gì trước khi bắt đầu?
Bạn cần một bảng dài theo tuần với các cột site, week, treated (1 nếu là site pilot) và aht (thời gian xử lý trung bình, tính bằng phút). Ví dụ có 12 site, 24 tuần, pilot bắt đầu từ tuần 13 ở hai site S03 và S07. Cài Python 3 và pandas là đủ.
Thống nhất với khách hàng trước một chỉ số duy nhất và ngày bắt đầu pilot. Nếu chọn chỉ số sau khi đã xem dữ liệu, mọi kiểm định phía sau đều mất giá trị.
Bước 1: nhìn bốn con số trung bình
import pandas as pd

df = pd.read_csv("sites_weekly.csv")   # site, week, treated, aht
START = 13
df["post"] = (df["week"] >= START).astype(int)
print(df.groupby(["treated", "post"])["aht"].mean().unstack())
Kiểm tra: bảng in ra phải có đúng bốn ô. Giả sử nhóm pilot đi từ 10,0 xuống 8,6 phút, nhóm đối chứng từ 10,2 xuống 9,8 phút. Pilot giảm 1,4 phút, nhưng đối chứng cũng giảm 0,4 phút, có thể vì mùa thấp điểm hoặc một đợt đào tạo chung. DiD lấy hiệu hai mức giảm: −1,4 − (−0,4) = −1,0 phút.
Bước 2: gói phép tính vào một hàm
def did(d, treated_sites, start):
    t = d["site"].isin(treated_sites)
    post = d["week"] >= start
    m = d.groupby([t, post])["aht"].mean()
    return (m[True, True] - m[True, False]) - (m[False, True] - m[False, False])

print(did(df, ["S03", "S07"], START))   # kỳ vọng ≈ -1.0
Hàm nhận danh sách site và ngày bắt đầu làm tham số để hai bước kiểm định giả phía sau có thể gọi lại nó với site giả và ngày giả.
Bước 3: xem chênh lệch theo từng tuần, nhưng đừng tin quá
gap = df.pivot_table(index="week", columns="treated",
                     values="aht", aggfunc="mean")
gap = gap[1] - gap[0]
print(gap.round(2))
Trước tuần 13, chênh lệch giữa hai nhóm nên dao động quanh một mức ổn định, rồi sau đó mới tách ra. Đây là cách kiểm tra bằng mắt giả định xu hướng song song (parallel trends), tức là nếu không có pilot thì hai nhóm đã đi cùng nhịp với nhau.
Brantly Callaway, nhà kinh tế lượng chuyên về DiD, lưu ý rằng parallel trends là giả định phụ mà thiết kế nghiên cứu không hề bảo đảm. Dữ liệu trước can thiệp chỉ giúp bạn kiểm tra lại nó.
Marcus và Sant’Anna đi xa hơn: hệ số trước can thiệp khác 0 là bằng chứng chống lại giả định, còn không bác bỏ được thì không phải bằng chứng ủng hộ.
Jonathan Roth còn cảnh báo thêm một tầng nữa: kiểm định pre-trend thường thiếu power, và nếu chỉ tiếp tục phân tích khi pretest “qua”, chính quyết định đó có thể làm méo cả ước lượng lẫn suy luận. Vì thế hãy dùng bước này để phát hiện vấn đề rõ ràng, đừng dùng nó làm tấm vé thông hành.
Vì sao không được in sai số chuẩn cluster-robust?
Phản xạ tự nhiên là chạy hồi quy rồi cluster sai số theo site. Alvarez, Ferman và Wüthrich chỉ ra rằng khi rất ít đơn vị được can thiệp, các quan sát của chúng có đòn bẩy cao. Hệ quả là cả sai số chuẩn thông thường lẫn cluster-robust đều bị đánh giá thấp nghiêm trọng.
Khi chỉ có một site pilot, các tác giả cho thấy việc cluster theo đơn vị trong DiD khiến sai số chuẩn bị đánh giá thấp đi rất nhiều.
Họ khuyến nghị thẳng là đừng báo cáo cluster-robust SE trong những trường hợp này, và gợi ý dùng phương pháp Conley–Taber hoặc conformal inference. Hai bước tiếp theo không thay được hai phương pháp đó.
Chúng là cách làm rút gọn dựa trên một ý dễ kiểm tra: thay vì tin vào công thức sai số chuẩn, bạn tính lại ước lượng ở những thời điểm và những site chắc chắn không có pilot, rồi xem con số thật có nổi bật so với các con số giả hay không.
Bước 4: dời ngày pilot về quá khứ
pre = df[df["week"] < START]
for fake_start in [7, 9, 11]:
    print(fake_start, round(did(pre, ["S03", "S07"], fake_start), 2))
Bạn chỉ dùng dữ liệu trước khi có pilot và giả vờ pilot đã bắt đầu sớm hơn. Ở đây không có can thiệp nào thật, nên kết quả nên gần 0.
Nếu ngày giả cho ra −0,8 phút thì ước lượng −1,0 phút của bạn đang đo một thứ khác chứ không phải agent. Netflix Games gọi kỹ thuật này là backdating và dùng nó như một bước kiểm tra độ bền trong khung synthetic control của mình.
Bước 5: lần lượt gán vai pilot cho từng cặp site đối chứng
from itertools import combinations

PILOT = ["S03", "S07"]
real = did(df, PILOT, START)
controls = sorted(set(df["site"]) - set(PILOT))
ctrl = df[df["site"].isin(controls)]          # bỏ hẳn site pilot thật
placebo = [did(ctrl, list(c), START) for c in combinations(controls, 2)]
p = (1 + sum(abs(e) >= abs(real) for e in placebo)) / (1 + len(placebo))
print(len(placebo), round(p, 3))
Chi tiết đáng chú ý là dòng ctrl: S03 và S07 bị loại khỏi mọi phép gán giả. Nếu giữ lại, hai site này sẽ nằm trong nhóm đối chứng của các cặp giả, tác động thật của agent lẫn vào phép so sánh và làm các ước lượng giả lệch đi.
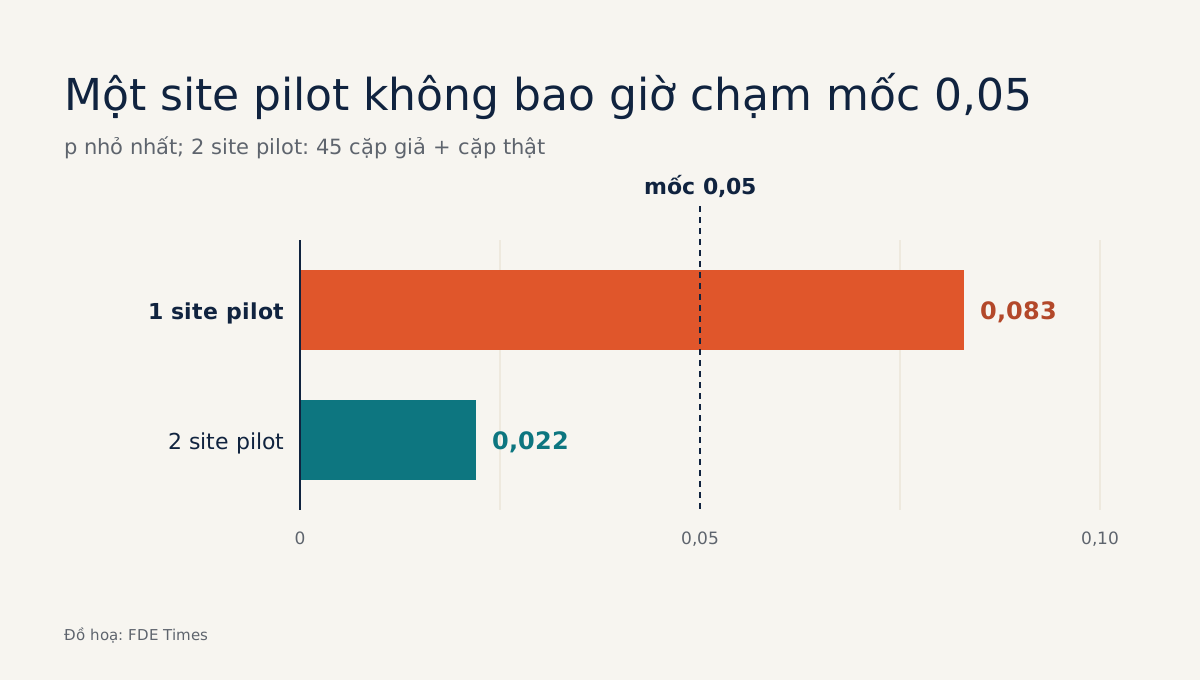
Với 10 site đối chứng, có 45 cặp giả. Cộng thêm cặp thật là 46 phép gán. Nếu −1,0 phút là con số có trị tuyệt đối lớn nhất, p bằng 1/46, khoảng 0,022.
Đây là phép thử hoán vị đã rút gọn, chưa phải quy trình đầy đủ trong các bài báo, nhưng logic của nó đủ đơn giản để giải thích cho một giám đốc vận hành.
Hãy làm thêm một phép tính trước khi hứa hẹn gì. Nếu khách hàng chỉ cho một site pilot trong 12 site, bạn chỉ có 11 phép gán giả cộng phép gán thật. Khi đó p nhỏ nhất có thể là 1/12, khoảng 0,083, nghĩa là bạn không bao giờ chạm được mốc 0,05 dù agent hiệu quả đến đâu.
Alvarez và đồng nghiệp cũng nói rõ: các phương pháp kiểm soát đúng size vẫn có thể thiếu power khi số đơn vị được can thiệp rất nhỏ.
Những lỗi hay gặp nhất
Lỗi đầu tiên là chọn site pilot theo cảm tính, thường là site có quản lý nhiệt tình nhất. Những site đó có thể đã cải thiện từ trước, và bước 3 sẽ cho bạn thấy điều này nếu bạn chịu nhìn kỹ.
Lỗi thứ hai là đổi chỉ số hoặc đổi ngày bắt đầu sau khi thấy kết quả. Lỗi thứ ba là dán nguyên bảng hồi quy có sai số chuẩn cluster vào slide. Con số ấy trông chuyên nghiệp nhưng sai theo hướng có lợi cho bạn, và đó chính là kiểu sai dễ làm mất lòng tin nhất khi khách hàng tự kiểm tra lại.
Kỹ năng này xuất hiện thế nào ở site khách hàng?
Netflix là ví dụ cho thấy cách làm này không chỉ có trong sách: họ dựa nhiều vào cả thí nghiệm lẫn quasi-experiment, và dùng suy luận nhân quả trên dữ liệu quan sát khi không có A/B test được lên kế hoạch trước.
Nhóm Netflix Games xây cả một khung gồm nhiều biến thể synthetic control, trong đó có synthetic DiD, vì mỗi cách hợp với một tình huống khác nhau.
Tại chỗ khách hàng, việc nên làm đầu tiên là chạy phép tính ở bước 5 ngay buổi họp thiết kế pilot. Nếu số site pilot quá ít để đạt mức tin cậy khách hàng cần, hãy thương lượng thêm site pilot; kéo dài thời gian quan sát không làm tăng số cách gán vai pilot trong phép hoán vị.
Nói chuyện này trước khi triển khai dễ hơn nhiều so với lúc phải giải thích một kết quả “không có ý nghĩa thống kê”.
Về sự nghiệp, hãy để ý những tin tuyển dụng FDE có cụm “measure impact” hoặc “prove ROI”. Trong CV, thay vì ghi “phân tích dữ liệu pilot”, hãy viết rằng bạn ước lượng tác động bằng DiD trên N site, kiểm định bằng placebo theo thời gian và hoán vị site, và báo cáo rõ giới hạn về power.
Một câu như vậy cho người phỏng vấn biết bạn hiểu cả con số lẫn những gì con số đó không chứng minh được.
Khách hàng sẽ quên con số −1,0 phút khá nhanh. Họ sẽ nhớ lâu hơn việc bạn là người nói trước với họ rằng hai site chỉ chứng minh được đến mức nào.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
5 nguồn
- Inference with few treated units (Alvarez, Ferman, Wüthrich) · 2025-06-25
- Pretest with Caution: Event-Study Estimates after Testing for Parallel Trends (Jonathan Roth, AER: Insights) · 2022-09
- The role of parallel trends in event study settings: An application to environmental economics (Marcus, Sant'Anna) · 2020-09-03
- Difference-in-Differences (Brantly Callaway, Recent Methodological Advances and their Relevance to Empirical Work)
- Round 2: A Survey of Causal Inference Applications at Netflix (mirror of Netflix Technology Blog post) · 2024-06-08