Dashboard giờ công tiết kiệm phải bắt đầu từ trước khi agent chạy
Trace cho bạn biết agent làm bao nhiêu task, nhưng tài chính chỉ tin con số khi có baseline đo trước.
Tóm tắt nhanh
- Không có baseline đo trước khi launch thì chưa được nói đến ROI, chỉ nên gọi là pilot.
- Trace cho bạn số task, số lần gọi tool và token. Số phút tiết kiệm mỗi task phải lấy từ phép đo thủ công.
- Phần giờ bị review của người nuốt mất và phần giờ không được dùng sang việc khác thì không được tính.
Bạn có thể ngồi trước một Langfuse đầy trace mà vẫn không trả lời được câu duy nhất giám đốc tài chính của khách quan tâm: agent này tiết kiệm được bao nhiêu giờ công? Trace ghi lại agent đã làm gì. Nó không ghi lại người ta từng mất bao lâu để làm việc đó bằng tay.
Hướng dẫn của Fiddler về máy tính ROI cho agent nói thẳng rằng phải đo baseline của quy trình hiện tại trước khi agent đi vào hoạt động. Họ cũng nhận xét rằng bộ phận tài chính sẽ không tin các con số ước tính, mà tin vào chênh lệch đo được.
Vì thế dashboard giờ công tiết kiệm thực chất là hai phép đo ghép lại: một bảng số đo tay trước launch, và một bộ đếm lấy từ trace sau launch.
Bạn sẽ dựng bộ đếm đó, nối nó với baseline và đưa kết quả lên một bảng nhìn được theo từng khách. Code dưới đây đã được giản lược: định dạng file export span là một dạng JSONL giả định, và các số trong ví dụ đều là số giả định để minh hoạ.
Cần chuẩn bị những gì?
Bạn cần một agent đã gắn instrumentation theo quy ước OpenTelemetry GenAI, trace của nó export được ra file hoặc đã nằm trong Langfuse, và Python 3. Điều kiện quan trọng nhất không nằm trên laptop: bạn phải có quyền ngồi cạnh người làm quy trình thủ công để bấm giờ.
MetaCTO, trong bài viết về những gì cần đo trước và sau launch, khuyên rằng nếu đội không làm được baseline thì vẫn có thể chạy pilot, nhưng chưa nên nói đến ROI. Nếu khách chưa cho bạn đo, hãy gọi đúng tên dự án là pilot ngay từ đầu.
Bước 1: đo baseline bằng tay, không ước lượng
Chọn một loại task cụ thể, ví dụ phân loại ticket hỗ trợ. Bấm giờ nhiều lần trên người làm thật rồi lấy trung vị. Sau launch, đo tiếp số phút người còn phải bỏ ra để review kết quả của agent, và mỗi tuần xin quản lý bên khách xác nhận bao nhiêu giờ đã thực sự được giao sang việc khác.
# baseline.py — số đo tay (số giả định để minh hoạ)
BASELINE_MIN = {"phan_loai_ticket": 12.0}  # đo trước launch
REVIEW_MIN   = {"phan_loai_ticket": 3.0}   # đo sau launch, không đoán
# giờ quản lý bên khách xác nhận đã chuyển sang việc khác, theo tuần
REDEPLOYED_H = {("phan_loai_ticket", "tuan_1"): 45.0}
Kiểm tra: mỗi con số phải trỏ được về một buổi đo hoặc một lần xác nhận có ngày tháng và người chịu trách nhiệm. Không trả lời được “số 12 này từ đâu ra” thì đó là con số ước tính, và bên tài chính sẽ không tin nó.
Bước 2: gom tên thuộc tính vào một chỗ
Theo bài giải thích của Dash0, các thuộc tính gen_ai.* vẫn đang ở mức ổn định Development: tên thuộc tính có thể bị đổi, hình dạng span có thể bị cấu trúc lại. Đừng rải các chuỗi này khắp code.
# semconv.py — mọi tên gen_ai.* chỉ nằm ở đây
AGENT_SPAN = "invoke_agent"
TOOL_SPAN  = "execute_tool"
IN_TOK     = "gen_ai.usage.input_tokens"
OUT_TOK    = "gen_ai.usage.output_tokens"
TASK_TYPE  = "app.task_type"    # thuộc tính tự đặt, không thuộc chuẩn
CUSTOMER   = "app.customer_id"  # tự đặt
Kiểm tra: chạy grep -r "gen_ai\." . thì chỉ được thấy một file. Ghim luôn phiên bản thư viện instrumentation để quy ước không âm thầm đổi giữa hai lần deploy.
Bước 3: một task là một invoke_agent gốc
Theo quy ước GenAI, mỗi lần agent chạy là một span invoke_agent, còn sub-agent được lồng vào dưới dạng một span invoke_agent khác. Nếu đếm mọi span invoke_agent, một task có ba sub-agent sẽ bị tính thành bốn. Chỉ có span ngoài cùng mới là task.
import json
from semconv import AGENT_SPAN, TOOL_SPAN, IN_TOK, OUT_TOK

spans = [json.loads(l) for l in open("spans.jsonl")]  # định dạng giản lược
by_id = {s["span_id"]: s for s in spans}

def is_agent(s):
    return s["name"].startswith(AGENT_SPAN)

# giản lược: mỗi span đi ngược lên gốc, tốn O(độ sâu cây)
def root_agent(s):
    top = s if is_agent(s) else None
    p = by_id.get(s.get("parent_id"))
    while p:
        if is_agent(p):
            top = p
        p = by_id.get(p.get("parent_id"))
    return top
Vòng lặp này đơn giản để đọc, nhưng với trace lớn và cây sâu, bạn nên cache kết quả gốc theo span_id để mỗi nhánh chỉ phải đi ngược một lần.
Mỗi lần gọi tool, kể cả gọi qua MCP, là một span execute_tool. Nhờ vậy bạn đếm được số bước tự động trong từng task, và cộng token từ hai thuộc tính usage để có chi phí.
from collections import defaultdict
tasks = defaultdict(lambda: {"tools": 0, "tok": 0})
for s in spans:
    r = root_agent(s)
    if not r:
        continue
    t = tasks[r["span_id"]]
    if s["name"].startswith(TOOL_SPAN):
        t["tools"] += 1
    a = s.get("attributes", {})
    t["tok"] += a.get(IN_TOK, 0) + a.get(OUT_TOK, 0)
Kiểm tra: lấy một ngày trace, so số task gốc với số ticket khách đếm trong hệ thống của họ. Lệch nhiều thì cách gắn span cha–con đang sai, và mọi con số phía sau cũng sai theo.
Bước 4: giờ bị review nuốt mất không phải giờ tiết kiệm
Công thức Fiddler đưa ra khá đơn giản: số giờ tiết kiệm mỗi tuần nhân với đơn giá giờ công bình quân, rồi nhân với 52 tuần. Điều kiện kèm theo là chỉ tính những giờ thực sự được chuyển sang việc khác. MetaCTO cảnh báo cùng hướng: đừng nói agent tiết kiệm 132 giờ nếu số giờ đó đã bị lượng review tăng thêm hấp thụ hết.
Đừng để quy tắc đó chỉ nằm trong slide. Hãy viết nó vào script, để con số được tính không bao giờ vượt quá số giờ khách đã xác nhận.
from baseline import BASELINE_MIN, REVIEW_MIN, REDEPLOYED_H

def weekly_hours(n_tasks, task_type, week):
    gross = n_tasks * BASELINE_MIN[task_type] / 60
    net = n_tasks * (BASELINE_MIN[task_type] - REVIEW_MIN[task_type]) / 60
    confirmed = REDEPLOYED_H.get((task_type, week), 0.0)  # chưa xác nhận = 0
    return {"gop": gross, "sau_review": net, "duoc_tinh": min(net, confirmed)}

def annual_value(counted_h, rate):
    return counted_h * rate * 52
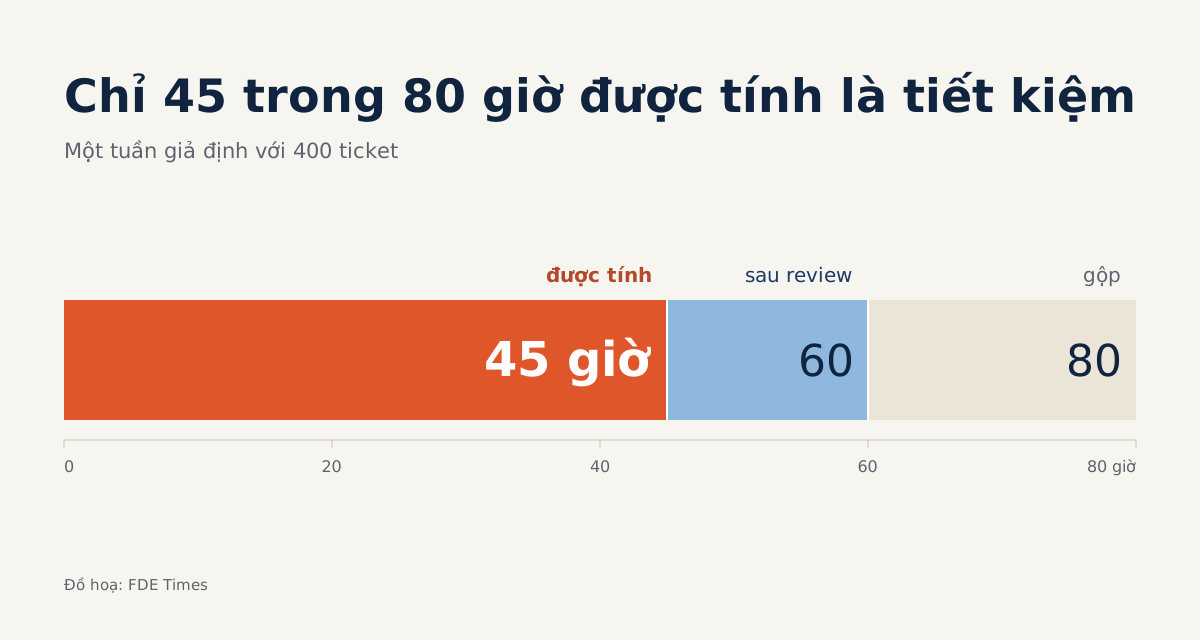
Thử hình dung một tuần với số giả định. Agent xử lý 400 ticket, tức 400 × 12 / 60 = 80 giờ gộp. Trừ 3 phút review mỗi ticket, còn 400 × 9 / 60 = 60 giờ.
Quản lý bên khách chỉ xác nhận 45 giờ đã được giao sang việc khác, nên duoc_tinh là 45, không phải 60. Với đơn giá giả định 40 đơn vị tiền một giờ, annual_value(45, 40) cho 45 × 40 × 52 = 93.600. Tuần nào chưa có xác nhận, script trả về 0 giờ được tính.
Kiểm tra: để lộ cả ba con số trên bảng: giờ gộp, giờ sau khi trừ review, giờ đã được dùng sang việc khác. Người xem cần thấy bạn đã trừ những gì.
Bước 5: đặt chi phí cạnh khoản tiết kiệm
Token đã được cộng ở bước 3. Nhân với đơn giá trong hợp đồng model của khách để ra chi phí mỗi task, rồi hiển thị ngay cạnh giá trị giờ công. Một dashboard chỉ có cột lợi ích sẽ bị hỏi vặn ngay buổi họp đầu tiên.
Nên đưa thêm số tool call trung bình mỗi task lên bảng, như một tín hiệu cảnh báo sớm. Nếu nó tăng trong khi số task không đổi, hãy mở vài trace ra xem agent có đang lặp vòng hay không, vì mỗi bước thừa đều cộng thêm token.
Bước 6: đưa lên bảng theo từng khách
Nếu trace đã nằm trong Langfuse, custom dashboard của Langfuse tổng hợp được trên trace, observation, user, session và score. Metrics API của họ cho phép nhóm theo name, model hoặc user ID, với nhiều mức độ chi tiết theo thời gian. Đặt user ID bằng mã khách hoặc mã đội, chọn mức tuần, và bạn có số task mỗi tuần cho từng khách.
Truy vấn dưới đây chỉ là phác thảo cho thấy hình dạng câu hỏi bạn gửi đi: đếm trace, nhóm theo user ID, chia theo tuần. Tên trường đã được giản lược, hãy đối chiếu với tài liệu Langfuse trước khi chạy.
# phác thảo truy vấn Metrics API — tên trường giản lược, không phải cú pháp chính xác
query = {
    "view": "traces",
    "metrics": [{"measure": "count", "aggregation": "count"}],
    "dimensions": [{"field": "userId"}],          # mỗi khách một dòng
    "timeDimension": {"granularity": "week"},     # mỗi tuần một cột
    "filters": [{"column": "name", "value": "phan_loai_ticket"}],
}
# với mỗi dòng (khách, tuần, số task) trả về:
#   weekly_hours(so_task, "phan_loai_ticket", tuan)
Phần nhân với baseline vẫn chạy trong script của bạn, vì baseline là dữ liệu đo tay và không nằm trong trace. Langfuse cho bạn số task theo khách và theo tuần, còn weekly_hours biến nó thành giờ được tính.
Kiểm tra: cộng số task của mọi khách trong một tuần, rồi so với tổng số task gốc mà script ở bước 3 đếm được trên cùng tuần. Hai con số phải khớp.
Sai ở đâu thì con số sụp?
Lỗi hay gặp nhất là đếm mọi span invoke_agent mà không lọc task gốc, khiến số task phồng lên theo số sub-agent. Lỗi thứ hai là dùng số phút “khoảng chừng” do khách tự nhớ thay cho số bấm giờ. Lỗi thứ ba ít ai để ý: nâng phiên bản instrumentation, tên thuộc tính đổi, bộ đếm token bỗng về 0 mà không ai phát hiện.
Cả ba lỗi đều làm hỏng điều tài chính tin nhất, là chênh lệch đo được. Khi một con số bị phát hiện sai, những con số đúng trên cùng bảng cũng mất uy tín theo.
Ở chỗ khách, kỹ năng này trông như thế nào?
Với một FDE, phép đo baseline thuộc về tuần đầu của engagement, không phải tuần cuối. Hãy đưa nó vào kế hoạch triển khai như một hạng mục có tên riêng, có người chịu trách nhiệm bên khách, trước khi viết dòng prompt đầu tiên. Khi đến buổi review quý, bạn mang ra số đo được, không phải lời hứa.
Về nghề nghiệp, khi một tin tuyển dụng nhắc đến observability hay việc chứng minh giá trị cho khách, đây là kỹ năng nên mang ra kể trong phỏng vấn. Trong CV, đừng viết “xây dashboard”.
Hãy viết rằng bạn đã đo baseline trước launch, lọc task gốc từ trace và báo cáo giờ tiết kiệm sau khi đã trừ thời gian review. Một repo nhỏ chạy trên trace mẫu, kèm file baseline, là bằng chứng thuyết phục hơn mọi dòng mô tả.
Agent nào cũng sinh ra trace. Còn con số mà khách dám đưa vào ngân sách năm sau thì phải được đo bằng đồng hồ bấm giờ, từ trước khi agent chạy.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
5 nguồn
- How To Build an AI Agent ROI Calculator That Finance Actually Trusts · 2026-05-12
- AI Agent ROI: What to Measure Before and After Launch · 2026-07-04
- OpenTelemetry GenAI semantic conventions explained (Dash0) · 2026-09-15
- Custom Dashboards - Langfuse Docs
- Custom Metrics API - Langfuse Changelog · 2025-05-12