Tự dựng bảng lương FDE từ dữ liệu công khai của Greenhouse bằng khoảng 40 dòng Python
Ở các bang có luật minh bạch lương, khung lương FDE thường được ghi ngay trong tin tuyển dụng; chỉ cần gọi đúng tham số và nhớ chia cho 100 là bạn tự dựng được bảng lương của riêng mình.
Tóm tắt nhanh
- Endpoint GET của Greenhouse Job Board không cần API key; phải có pay_transparency=true thì mới nhận được khung lương
- Số tiền nằm ở min_cents và max_cents, nên 5000000 nghĩa là 50,000.00 USD
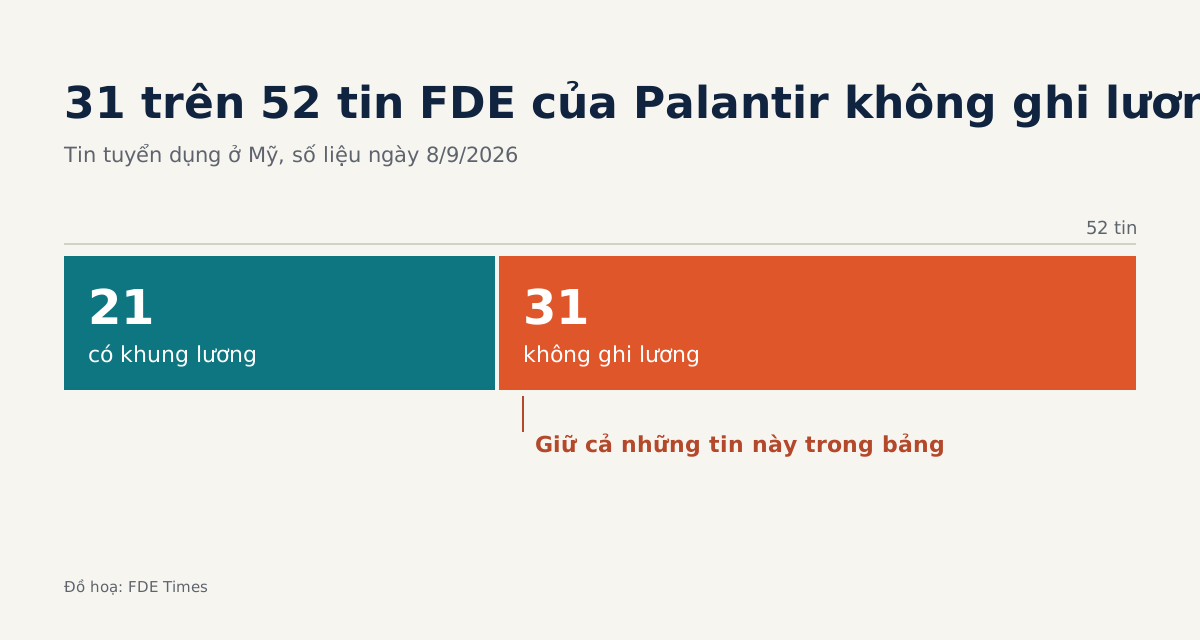
- Tin thiếu khung lương rất phổ biến: Palantir chỉ ghi khung lương trên 21 trong 52 tin ở Mỹ
Một con số trong tài liệu của Greenhouse dễ khiến bạn sai cả bảng lương: "min_cents":5000000. Nếu quên rằng đó là cent, bạn sẽ nghĩ một vị trí trả 5 triệu USD, trong khi con số thật là 50,000.00 USD.
Hướng dẫn dưới đây chỉ cho bạn cách tránh những cái bẫy nhỏ như thế. Bạn sẽ viết một script Python ngắn, gọi API tuyển dụng công khai của Greenhouse, lọc ra các tin Forward Deployed Engineer, đổi khung lương sang đơn vị dễ đọc rồi ghi ra file CSV.
Thành quả là một bảng lương FDE do chính bạn dựng, ghi rõ nguồn và ngày lấy, thay vì một con số truyền miệng.
Bảng lương này có ích cho người đang chuẩn bị đàm phán offer. Nhưng giá trị lớn hơn nằm ở kỹ năng: gọi một API lạ, đọc cấu trúc dữ liệu, chuẩn hoá đơn vị và xử lý chỗ thiếu dữ liệu chính là công việc hằng ngày của FDE ở phía khách hàng.
Vì sao khung lương lại nằm sẵn trong API?
Lý do chính là luật. Theo hãng luật Foley & Lardner, Colorado buộc mọi tin tuyển dụng phải có thông tin lương, áp dụng cả với vị trí remote nếu công ty có ít nhất một nhân viên ở bang này. California yêu cầu ghi khung lương trong tin của các công ty thuộc diện áp dụng, kể cả tin do bên thứ ba đăng.
Thành phố New York cũng buộc tin tuyển dụng ghi mức lương năm tối thiểu và tối đa, hoặc lương theo giờ, cho các công việc làm ít nhất một phần tại thành phố. Vì thế các tin FDE ở San Francisco hay New York thường có khung lương, và Greenhouse đưa phần dữ liệu đó ra qua API.
Bạn cần nhớ hệ quả của chuyện này. Dữ liệu bạn thu được phản ánh chủ yếu thị trường Mỹ, nơi luật bắt buộc công bố lương. Đừng dùng nó để suy ra mức lương ở thị trường khác.
Cần chuẩn bị gì trước khi viết code?
Bạn cần Python 3 và thư viện requests (pip install requests). Không cần API key: tài liệu Greenhouse ghi rõ dữ liệu Job Board là công khai nên các endpoint GET không yêu cầu xác thực.
Thứ bạn phải tự tìm là board token, tức định danh của công ty trong đường dẫn API. Cách nhanh nhất là mở trang tuyển dụng của công ty đó; nếu trang được Greenhouse host, phần định danh công ty thường hiện ngay trên URL. Hãy coi đây là mẹo thực hành, rồi kiểm tra lại bằng bước 1 bên dưới.
Bước 1: gọi endpoint và nhìn cấu trúc trước khi tin vào nó
Endpoint danh sách việc làm có dạng GET https://boards-api.greenhouse.io/v1/boards/{board_token}/jobs. Thêm content=true để mỗi tin có kèm mô tả đầy đủ, phòng ban và văn phòng. Thêm pay_transparency=true để nhận mảng pay_input_ranges; bài hỗ trợ của Greenhouse cũng xác nhận phải bật tham số này thì mới có dữ liệu lương.
import requests

BOARD = "board_token_cua_cong_ty"
URL = f"https://boards-api.greenhouse.io/v1/boards/{BOARD}/jobs"

resp = requests.get(
    URL,
    params={"content": "true", "pay_transparency": "true"},
    timeout=30,
)
resp.raise_for_status()
data = resp.json()
print(data.keys())
Kiểm tra: lệnh chạy không báo lỗi HTTP và in ra các khoá cấp cao nhất. Code bên dưới giả định danh sách tin nằm dưới khoá jobs và mỗi tin có trường title. Đây là chỗ giản lược, nên hãy xác nhận bằng chính kết quả bạn vừa in.
Bước 2: lọc tin FDE
Không phải công ty nào cũng dùng đúng một chức danh. Cách đơn giản là lọc theo chuỗi trong tiêu đề, rồi đọc lại danh sách bằng mắt.
jobs = data.get("jobs", [])
fde_jobs = [
    j for j in jobs
    if "forward deployed" in (j.get("title") or "").lower()
]
print(len(jobs), len(fde_jobs))
for j in fde_jobs:
    print(j.get("title"))
Kiểm tra: in ra toàn bộ tiêu đề đã lọc. Nếu thấy chức danh lạc đề, hoặc biết công ty gọi vai trò này bằng tên khác, hãy chỉnh điều kiện lọc ngay lúc này, đừng để đến khi bảng đã ra số.
Bước 3: đổi cent ra tiền và giữ lại cả tin thiếu lương
Đây là bước quyết định độ đúng của bảng. Ví dụ JSON trong tài liệu Greenhouse cho thấy mỗi khoảng lương có min_cents, max_cents và currency_type, nên phải chia cho 100. Code dùng .get() để một khoảng lương thiếu trường nào đó không làm script dừng giữa chừng, đúng tinh thần không tin mù quáng vào cấu trúc dữ liệu.
def cents(value):
    return value / 100 if value is not None else None

def to_rows(job):
    ranges = job.get("pay_input_ranges") or []
    if not ranges:
        return [{"title": job.get("title"), "min": None,
                 "max": None, "currency": None}]
    return [{
        "title": job.get("title"),
        "min": cents(r.get("min_cents")),
        "max": cents(r.get("max_cents")),
        "currency": r.get("currency_type"),
    } for r in ranges]

rows = [row for j in fde_jobs for row in to_rows(j)]
Chạy thử với số trong tài liệu: 5000000 chia 100 ra 50,000.00 và 7500000 chia 100 ra 75,000.00 USD. Nếu bảng của bạn hiện con số bảy chữ số cho một vị trí kỹ sư, gần như chắc chắn bạn quên phép chia.
Vì sao phải giữ cả những tin không ghi lương? Vì chúng nhiều hơn bạn tưởng. Theo số liệu ngày 8/9/2026 do Valletta Software tổng hợp, khung lương Forward Deployed Software Engineer của Palantir chỉ xuất hiện trên 21 trong 52 tin ở Mỹ; bỏ qua 31 tin còn lại thì bạn không còn biết bảng của mình đại diện cho bao nhiêu phần thị trường.
Bước 4: ghi CSV và đếm số tin có lương
Một tin có thể có nhiều khoảng lương, nên số dòng trong CSV không bằng số tin. Vì thế phép đếm độ phủ phải chạy trên từng tin, để con số của bạn so được với kiểu “21 trên 52 tin”.
import csv
from datetime import date

with open(f"fde_pay_{BOARD}_{date.today()}.csv", "w", newline="") as f:
    w = csv.DictWriter(f, fieldnames=["title", "min", "max", "currency"])
    w.writeheader()
    w.writerows(rows)

covered = sum(1 for j in fde_jobs if j.get("pay_input_ranges"))
print(f"{covered}/{len(fde_jobs)} tin có khung lương")
Kiểm tra: mở file và đọc vài dòng, rồi so số tin in ra với kết quả bước 2. Tên file chứa ngày lấy dữ liệu, vì khung lương thay đổi và bảng của bạn chỉ đúng tại thời điểm chạy.
Làm sao biết bảng của bạn không sai?
Đối chiếu với các khung lương đã được công bố. Cũng theo số liệu ngày 8/9/2026 của Valletta Software, đây là ba mốc để so:
| Công ty | Khung lương cơ bản | Lưu ý khi so |
|---|---|---|
| Anthropic | $280,000 đến $320,000 | Tin ở New York, San Francisco, Seattle |
| OpenAI | $185,000 đến $300,000 | Cộng thêm equity ngoài khung |
| Palantir | $125,000 đến $200,000 | Equity và bonus nằm ngoài khung |
Nếu bảng của bạn lệch hẳn khỏi các mốc này, hãy nghi bước lọc hoặc phép chia trước khi nghi thị trường. Cột cuối cũng nhắc một điều hay bị quên: đây là lương cơ bản, không phải tổng thu nhập. So điểm giữa của Palantir (162,500) với OpenAI (242,500) mà không nhắc phần equity là so sai.
Những lỗi hay gặp nhất
Lỗi phổ biến nhất là quên pay_transparency=true rồi kết luận công ty không công bố lương. Tiếp theo là quên chia 100, gộp các loại tiền tệ khác nhau vào một cột trung bình, và coi tin thiếu lương như lương bằng không.
Lỗi tinh vi hơn là gọi API liên tục trong vòng lặp không có điểm dừng. API không cần key không có nghĩa là bạn được gọi thoải mái; với bảng lương, mỗi ngày chạy một lần là đủ.
Kỹ năng này xuất hiện ở khách hàng thế nào?
Thử hình dung tuần đầu ở một khách hàng logistics: bạn cần kéo dữ liệu đơn hàng từ một hệ thống bạn chưa từng thấy. Trình tự gần như y hệt: gọi một request, in cấu trúc ra xem, xác nhận đơn vị (cent hay đồng, giây hay mili giây), rồi đếm xem bao nhiêu bản ghi thiếu trường quan trọng trước khi dựng bất kỳ dashboard nào.
Vì thế, khi làm xong bảng này, đừng chỉ giữ cho riêng mình. Đưa lên GitHub kèm README ghi ngày lấy dữ liệu, tỷ lệ tin có lương và giới hạn của bảng.
Trong CV, một dòng như “dựng pipeline thu thập khung lương công khai, chuẩn hoá đơn vị và báo cáo tỷ lệ tin thiếu dữ liệu lương” cho nhà tuyển dụng FDE thấy đúng thứ họ cần: bạn biết làm việc với dữ liệu thật, bừa bộn, và nói rõ dữ liệu đó đáng tin đến đâu.
Bảng lương sẽ cũ đi sau vài tuần. Còn thói quen in cấu trúc ra trước rồi mới đếm chỗ trống thì dùng được ở mọi khách hàng.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
4 nguồn
- Greenhouse Job Board API documentation
- Greenhouse Support: Permissions: Job Admin and above who can create, edit, and delete job posts (pay transparency section)
- Navigate New State Pay Transparency Laws (Foley & Lardner) · 2023-01
- Forward Deployed Engineer Salary in 2026 (Valletta Software) · 2026-09-08