ROW_NUMBER và lọc rn = 1: cách FDE khử trùng lặp dữ liệu khách hàng mà vẫn giữ đủ cột
Một khách hàng có thể xuất hiện ba lần trong bảng CRM, và bản ghi bạn chọn giữ lại sẽ quyết định con số đầu tiên bạn báo cáo có đúng hay không.

Tóm tắt nhanh
- Window function tính toán trên một nhóm dòng nhưng không gộp chúng lại, nên bạn vẫn giữ được bản ghi đầy đủ.
- Mẫu chuẩn: PARTITION BY khóa, ORDER BY updated_at DESC NULLS LAST kèm một cột tie-breaker, rồi lọc rn = 1.
- Snowflake và DuckDB có QUALIFY. PostgreSQL cấm window function trong WHERE, nên ở đó bạn cần thêm một CTE hoặc subquery.
Ngày thứ hai ở chỗ khách hàng, bạn nhận một file export từ CRM cùng một câu hỏi tưởng đơn giản: hiện có bao nhiêu khách hàng đang hoạt động?
Bạn đếm ra một con số, và người phụ trách bán hàng lắc đầu vì nó cao hơn thực tế. Lý do rất quen thuộc: cùng một người xuất hiện nhiều lần, do hai lần import, một lần sửa số điện thoại và một lần chuyển dữ liệu từ hệ thống cũ.
Với một FDE, đây không phải chuyện vặt. Mọi thứ bạn dựng sau đó, từ dashboard, pipeline đến agent tra cứu khách hàng, đều dựa trên bảng này. Khử trùng lặp sai thì mọi con số phía sau sai theo, và người ta thường chỉ phát hiện ra trong buổi demo chứ không phải lúc bạn viết truy vấn.
Kỹ năng cần nắm gói gọn trong một mẫu SQL: đánh số các bản ghi trong từng nhóm khách hàng, rồi chỉ giữ dòng số 1. Dưới đây là mẫu đó trên một ví dụ cụ thể, kèm những cái bẫy khiến nó cho ra kết quả khác nhau giữa hai lần chạy, hoặc giữa hai engine.
Vì sao GROUP BY không đủ?
Phản xạ đầu tiên của nhiều kỹ sư là GROUP BY email cùng MAX(updated_at). Cách này cho bạn thời điểm cập nhật mới nhất, nhưng không cho số điện thoại, địa chỉ hay trạng thái nằm trên chính dòng đó.
Muốn lấy lại các cột ấy, bạn phải join ngược về bảng gốc. Nếu có hai dòng cùng timestamp, cả hai đều khớp phép join và khách hàng đó lại bị nhân đôi.
Window function giải quyết đúng chỗ này. Theo tài liệu PostgreSQL, window function không gộp các dòng thành một dòng kết quả như hàm tổng hợp thông thường. Mỗi dòng vẫn đứng riêng trong kết quả, nên bạn tính được thứ hạng trong nhóm mà vẫn còn nguyên bản ghi đầy đủ để chọn.
Mẫu này có ba mảnh ghép. PARTITION BY chia các dòng thành những nhóm có cùng giá trị khóa, ví dụ cùng email. ROW_NUMBER() đánh số liên tiếp các dòng trong mỗi nhóm, và như glossary của MotherDuck lưu ý, khác với RANK() hay DENSE_RANK(), nó không bao giờ cho hai dòng hòa nhau.
Còn ORDER BY bên trong OVER quyết định dòng nào được số 1. Trên SQL Server, tài liệu của Microsoft ghi rõ mệnh đề này là bắt buộc với ROW_NUMBER.
Một bảng bẩn, đánh số từng dòng
Thử hình dung bảng customers_raw sau khi bạn đã đưa email về chữ thường và bỏ khoảng trắng. Khách hàng An có bốn bản ghi: hai bản được tạo trong cùng một giây vì job import chạy hai lần, và dòng 104 chuyển sang từ hệ thống cũ, không có updated_at.
Cột rn là kết quả của ROW_NUMBER() OVER (PARTITION BY email ORDER BY updated_at DESC, id DESC), chạy nguyên văn trên PostgreSQL và trên DuckDB. Cột rnk dùng RANK() với cùng thứ tự nhưng bỏ id, chạy trên DuckDB.
| id | khách | phone | updated_at | rn (PostgreSQL) | rn (DuckDB) | rnk (DuckDB) |
|---|---|---|---|---|---|---|
| 104 | An | 0912 000 099 | NULL | 1 | 4 | 4 |
| 103 | An | 0912 000 222 | 2026-05-10 14:30 | 2 | 1 | 1 |
| 102 | An | 0912 000 222 | 2026-05-10 14:30 | 3 | 2 | 1 |
| 101 | An | 0912 000 111 | 2026-03-01 09:00 | 4 | 3 | 3 |
| 201 | Bình | 0987 000 333 | 2026-04-02 08:00 | 1 | 1 | 1 |
Trên DuckDB, lọc rn = 1 cho đúng hai dòng: 103 của An và 201 của Bình. Lọc rnk = 1 cho ba dòng, vì An vẫn còn hai bản.
Tài liệu Microsoft nói rõ khác biệt này: ROW_NUMBER đánh số liên tiếp 1, 2, 3, 4, 5, còn RANK cho các dòng hòa cùng một số, kiểu 1, 2, 2, 4, 5.
Muốn đúng một dòng cho mỗi nhóm, bạn cần ROW_NUMBER.
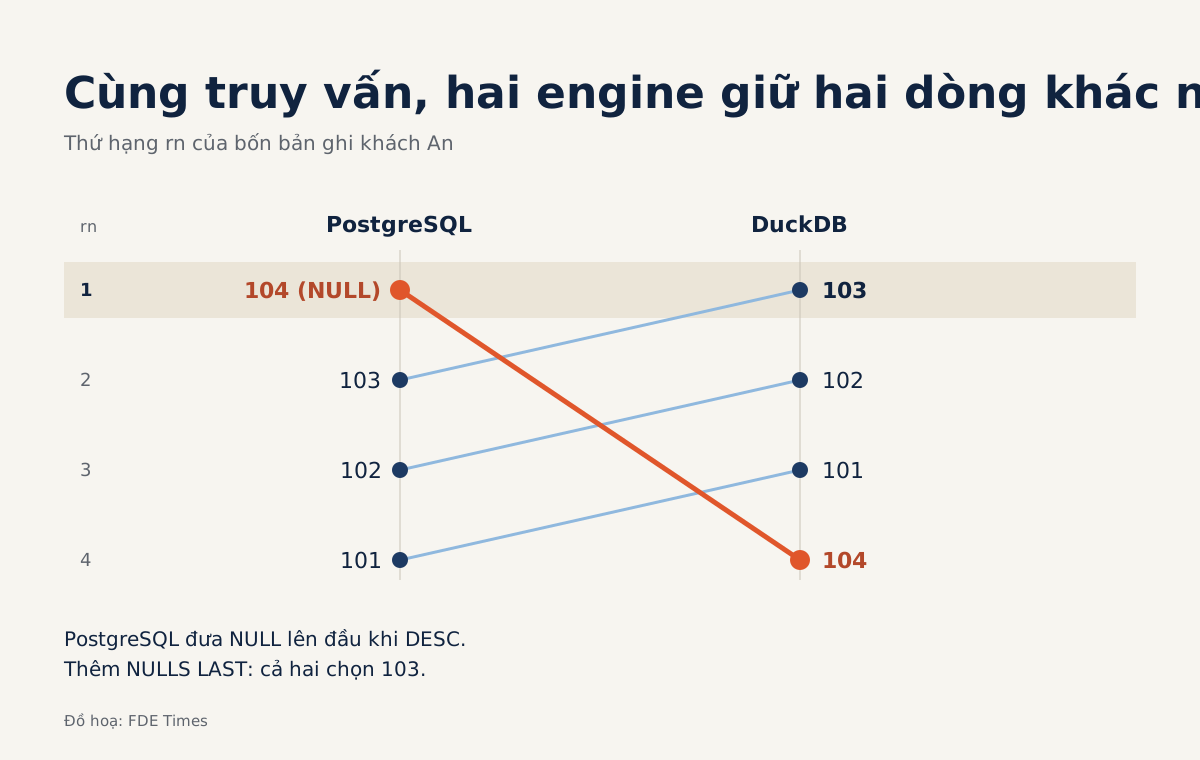
Cột PostgreSQL thì khác hẳn: dòng 104, bản không có timestamp, lại được số 1. Cùng một truy vấn, hai engine, hai khách hàng An khác nhau. Phần cuối bài giải thích vì sao.
PostgreSQL chỉ cho phép window function trong danh sách SELECT và ORDER BY, cấm trong WHERE, vì vậy bạn không thể viết WHERE ROW_NUMBER() ... = 1. Tài liệu khuyên dùng một sub-select khi cần lọc sau khi tính window.
Trên PostgreSQL, cách dễ đọc là bọc phần đánh số trong một CTE rồi lọc ở bên ngoài. Chữ NULLS LAST dưới đây là để chặn đúng cái bẫy của dòng 104:
WITH ranked AS (
  SELECT
    c.*,
    ROW_NUMBER() OVER (
      PARTITION BY lower(trim(email))
      ORDER BY updated_at DESC NULLS LAST, id DESC
    ) AS rn
  FROM customers_raw c
)
SELECT *
FROM ranked
WHERE rn = 1;
Trên Snowflake, mệnh đề QUALIFY làm việc này gọn hơn. Tài liệu Snowflake giải thích rằng QUALIFY làm với window function điều mà HAVING làm với hàm tổng hợp, và ví dụ chính thức của họ dùng đúng ROW_NUMBER() để chỉ trả về dòng đầu tiên của mỗi partition. DuckDB cũng hỗ trợ QUALIFY để lọc kết quả window function.
SELECT *
FROM customers_raw
QUALIFY ROW_NUMBER() OVER (
  PARTITION BY lower(trim(email))
  ORDER BY updated_at DESC, id DESC
) = 1;
Cột id cuối ORDER BY để làm gì?
Đây là chi tiết phân biệt người đã từng bị dữ liệu bẩn “cắn” với người chưa. Nếu chỉ có ORDER BY updated_at DESC, dòng 102 và 103 hòa nhau. Tài liệu PostgreSQL nói thẳng: các dòng hòa được đánh số theo thứ tự không xác định, và chính ví dụ trong tài liệu cũng thêm một cột mã nhân viên vào ORDER BY để phá thế hòa.
Tài liệu Microsoft cảnh báo tương tự: không có gì bảo đảm các dòng trả về từ ROW_NUMBER() được sắp giống nhau ở mỗi lần chạy, trừ khi giá trị ORDER BY trong mỗi partition là duy nhất.
Trong ví dụ trên, dòng 102 và 103 có cùng số điện thoại nên bạn chưa thấy hậu quả. Nhưng giả sử hai dòng hòa nhau lại khác nhau ở cột trạng thái. Hôm nay báo cáo nói khách hàng đang hoạt động, ngày mai lại nói đã hủy, dù không ai sửa dữ liệu. Lỗi kiểu này gần như không thể debug trước mặt khách hàng.
Cách sửa là luôn thêm một cột tie-breaker có giá trị duy nhất ở cuối ORDER BY, thường là khóa chính hoặc id tăng dần của hệ thống nguồn. id DESC nghĩa là khi hòa, bản ghi được tạo sau cùng sẽ thắng. Nếu khách hàng có cột tốt hơn, như số thứ tự sự kiện hay thời điểm ingest, hãy dùng cột đó.
Ba câu hỏi phải có lời đáp trước khi viết PARTITION BY
Câu hỏi đầu tiên không nằm trong SQL: thế nào là “cùng một khách hàng”? Đó là email, mã số thuế, hay một ID từ hệ thống ERP? Câu trả lời sẽ thành biểu thức trong PARTITION BY, và bạn nên chuẩn hóa nó ngay tại đó bằng lower, trim, hoặc bỏ ký tự thừa trong số điện thoại.
Câu hỏi thứ hai là “bản nào đúng”. Bản mới nhất theo updated_at là mặc định hợp lý, nhưng có khách hàng muốn giữ bản do đội bán hàng nhập thay vì bản do form web tạo ra. Khi đó, ORDER BY có thể bắt đầu bằng một biểu thức CASE để ưu tiên nguồn, rồi mới đến thời gian, cuối cùng là tie-breaker.
Câu hỏi thứ ba là làm sao biết kết quả đáng tin. Đếm số khóa riêng biệt trong bảng gốc rồi so với số dòng sau khi lọc: hai con số phải bằng nhau. Sau đó lấy vài nhóm có nhiều bản ghi nhất, in đầy đủ ra, và cho người phụ trách dữ liệu bên khách hàng xem bạn đã giữ dòng nào.
Những cái bẫy khiến bạn giữ nhầm dòng
Cái bẫy khó thấy nhất nằm ở dòng 104. Theo tài liệu PostgreSQL, NULL được sắp như thể lớn hơn mọi giá trị khác, nên với DESC thì NULL đứng đầu. Bản ghi cũ nhất, không có timestamp, lặng lẽ thắng rn = 1.
DuckDB thì ngược lại: tài liệu của engine này ghi rõ NULL được giữ ở cuối kể cả khi sắp DESC, khác với PostgreSQL, nên cùng truy vấn chọn dòng 103. Một notebook DuckDB trên laptop và pipeline PostgreSQL ở chỗ khách hàng vì thế có thể cho hai đáp án khác nhau, như hai cột rn trong bảng.
Cách phòng là đừng dựa vào mặc định. Viết rõ ORDER BY updated_at DESC NULLS LAST, id DESC trên engine hỗ trợ cú pháp này. Nếu cùng một truy vấn phải chạy trên engine không có NULLS LAST, hãy đưa thứ tự của NULL vào chính dữ liệu: ORDER BY CASE WHEN updated_at IS NULL THEN 1 ELSE 0 END, updated_at DESC, id DESC.
Biểu thức CASE gán 0 cho dòng có timestamp và 1 cho dòng rỗng, rồi sắp tăng dần, nên dòng rỗng luôn đứng sau bất kể engine mặc định thế nào. Với bảng trên, cả hai engine đều chọn 103.
Một cái bẫy khác là partition theo cột chưa chuẩn hóa, khiến “[email protected] “ và “[email protected]” thành hai khách hàng. Kế đến là dùng RANK hay DENSE_RANK vì nghĩ chúng tương đương, rồi ngạc nhiên khi bảng “đã khử trùng lặp” vẫn còn bản trùng ở đúng những nhóm có timestamp hòa nhau.
Trong CV và khi phỏng vấn, thay vì ghi “thành thạo SQL”, hãy kể cụ thể bạn đã dựng bước khử trùng lặp xác định cho bảng khách hàng từ nhiều nguồn, có tie-breaker, có xử lý NULL và có đối chiếu số khóa trước và sau.
Lần tới khi ai đó hỏi “có bao nhiêu khách hàng”, con số bạn đưa ra nên là con số mà ngày mai chạy lại, trên laptop hay trên server của khách, vẫn y nguyên.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!