Thực hành: cho agent gọi tool song song mà một lời gọi hỏng không kéo sập cả lượt
Khi agent gọi nhiều tool cùng lúc, lời gọi nào cũng phải nhận về một kết quả, kể cả lời gọi hỏng, và muốn biết vòng xử lý của bạn còn hỏng bao nhiêu thì phải đếm.

Tóm tắt nhanh
- Claude có thể trả nhiều tool_use trong một lượt. Chạy song song hay tuần tự là do bạn quyết, dựa trên việc tool có side effect hay không.
- Lời gọi nào cũng phải có tool_result khớp tool_use_id, kể cả lời gọi hỏng hay bị bỏ qua (is_error: true, kèm lý do ngắn).
- Đo tỷ lệ lỗi tool trên một bộ ca test thực tế, kèm thời gian chạy và số lời gọi, để biết bản sửa có thật sự làm agent tốt lên.
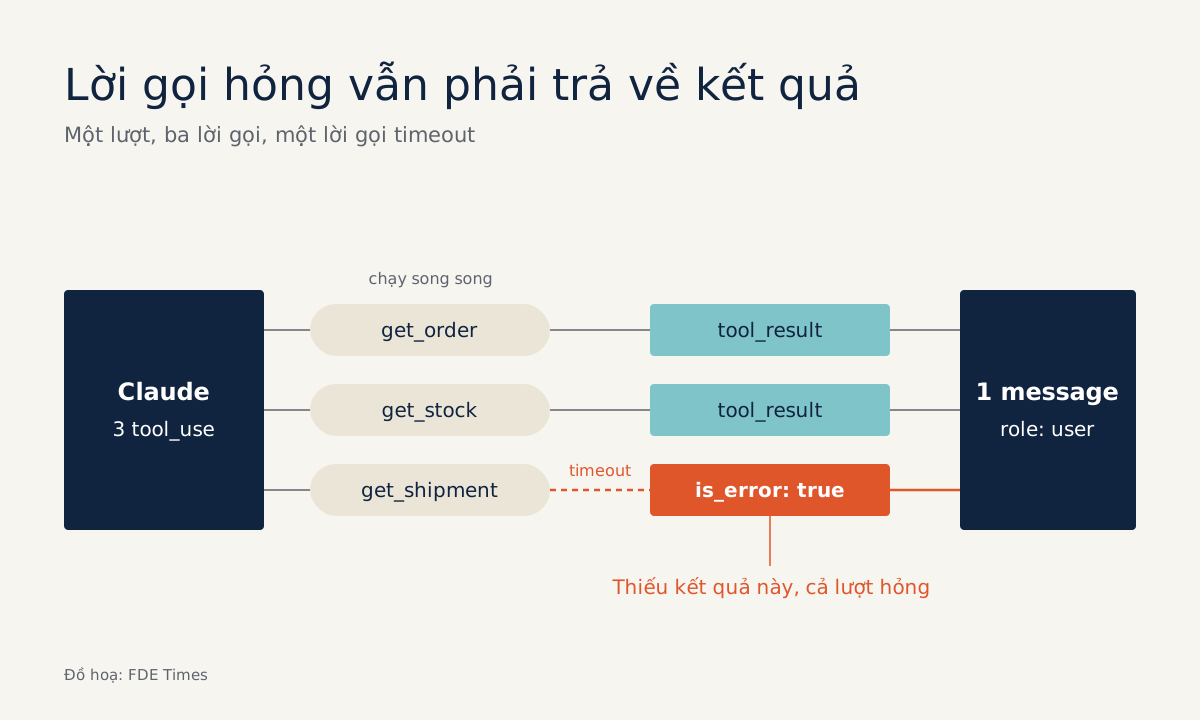
Một agent chăm sóc khách hàng nhận câu hỏi “đơn của tôi đâu, còn hàng để đổi không?” và trả về ba lời gọi tool trong một lượt. Hai lời gọi chạy tốt. Lời gọi thứ ba, tới hệ thống vận chuyển, bị timeout. Nếu code của bạn chỉ gửi lại hai kết quả, cả lượt hội thoại sẽ hỏng, dù hai phần ba công việc đã xong.
Tình huống này không hiếm. Tài liệu của Anthropic xác nhận Claude có thể trả về nhiều khối tool_use trong một lượt, và API không quy định thứ tự chạy: bạn có thể chạy đồng thời bằng asyncio.gather hoặc Promise.all, hoặc chạy lần lượt theo thứ tự xuất hiện.
Phía OpenAI cũng khuyên nên mặc định là sẽ có nhiều lời gọi, vì một response có thể chứa không, một hoặc nhiều lời gọi.
Với FDE, đây là việc thường ngày. Tool ở chỗ khách hàng là API nội bộ chậm, chập chờn, có cái chỉ đọc dữ liệu, có cái trừ tiền thật. Bài này hướng dẫn bạn dựng vòng xử lý chịu được lỗi từng phần, rồi đo xem nó còn hỏng bao nhiêu.
Bạn sẽ dựng gì, và cần chuẩn bị gì?
Bạn sẽ dựng ba thứ. Đầu tiên là hàm chạy các lời gọi tool: tool chỉ đọc chạy song song, tool có side effect chạy tuần tự. Tiếp theo là hàm gom kết quả thành một message hợp lệ. Cuối cùng là script chạy bộ ca test và in ra tỷ lệ lỗi.
Bạn cần Python có asyncio, một agent đã gọi được Claude với vài tool, và quen với cấu trúc khối tool_use. Code dưới đây là bản rút gọn để minh hoạ, đã lược phần gọi API, xác thực và retry. Ví dụ xuyên suốt là agent đơn hàng với bốn tool: get_order, get_shipment, get_stock (chỉ đọc) và issue_refund (có side effect).
Bước 1: phân loại tool trước khi viết dòng async nào
Anthropic đưa ra nguyên tắc rõ: các thao tác độc lập, chỉ đọc thường chạy song song an toàn và giảm độ trễ. Còn tool có side effect, dùng chung state hoặc cần đúng thứ tự thì có lẽ nên chạy tuần tự. Vì thế việc đầu tiên là ghi phân loại này thành code, đừng để nó nằm trong đầu.
import asyncio, time

READ_ONLY = {"get_order", "get_shipment", "get_stock"}
SIDE_EFFECT = {"issue_refund"}  # chạy tuần tự, đúng thứ tự model đưa ra
Kiểm tra: mọi tool trong agent phải nằm ở đúng một trong hai tập. Tool nào chưa rõ thì xếp vào SIDE_EFFECT. Chạy chậm hơn một chút vẫn rẻ hơn hoàn tiền hai lần.
Bước 2: bọc từng lời gọi để lỗi không lan ra ngoài
Mỗi lời gọi được bọc riêng. Khi nó hỏng, bạn vẫn trả về một tool_result, có is_error: true và một lời giải thích ngắn. Tài liệu của Anthropic yêu cầu đúng như vậy cho cả lời gọi bị lỗi lẫn lời gọi bạn quyết định bỏ qua.
async def run_one(block, log):
    start = time.monotonic()
    try:
        out = await TOOLS[block.name](**block.input)
        res = {"type": "tool_result", "tool_use_id": block.id, "content": out}
    except TimeoutError:
        res = {"type": "tool_result", "tool_use_id": block.id, "is_error": True,
               "content": "Shipping system did not respond within 5s. "
                          "Retry get_shipment once, or answer without a delivery date."}
    except Exception as e:
        res = {"type": "tool_result", "tool_use_id": block.id, "is_error": True,
               "content": f"{block.name} failed: {type(e).__name__}. Check the input fields."}
    log.append({"tool": block.name, "is_error": res.get("is_error", False),
                "seconds": time.monotonic() - start})
    return res
Hãy để ý nội dung lỗi. Anthropic khuyên viết thông báo lỗi sao cho agent biết cụ thể cần sửa gì, thay vì đưa mã lỗi khó hiểu hay traceback. “Thử lại một lần, hoặc trả lời mà không có ngày giao” cho model một lối ra. Còn một chuỗi HTTP 504 chỉ khiến nó đoán.
Kiểm tra: giả lập một TimeoutError trong get_shipment, rồi xác nhận hàm vẫn trả về một dict có tool_use_id đúng.
Bước 3: chạy song song phần chỉ đọc, tuần tự phần còn lại
async def run_turn(tool_blocks, log):
    reads = [b for b in tool_blocks if b.name in READ_ONLY]
    writes = [b for b in tool_blocks if b.name not in READ_ONLY]
    # Bản rút gọn: mọi lời gọi ghi phải chờ toàn bộ lời gọi đọc xong mới chạy.
    results = dict(zip([b.id for b in reads],
                       await asyncio.gather(*(run_one(b, log) for b in reads))))
    failed = None
    for b in writes:
        if failed:
            results[b.id] = {"type": "tool_result", "tool_use_id": b.id, "is_error": True,
                             "content": f"Not executed: the preceding {failed} call failed."}
            continue
        r = await run_one(b, log)
        results[b.id] = r
        if r.get("is_error"):
            failed = b.name
    return [results[b.id] for b in tool_blocks]  # giữ thứ tự gốc
Vòng lặp cho các lời gọi ghi đi theo ví dụ trong tài liệu của Anthropic. Khi một lời gọi ghi thất bại, các lời gọi phụ thuộc phía sau không được chạy, nhưng vẫn nhận một kết quả lỗi, kiểu như “Not executed: the preceding write_file call failed.” Bản rút gọn ở đây coi mọi lời gọi ghi phía sau đều phụ thuộc lời gọi trước.
Với hệ thống thật, bạn nên khai báo phụ thuộc cụ thể hơn, và chỉ bắt lời gọi ghi chờ những lời gọi đọc mà nó thật sự cần.
Kiểm tra: cho issue_refund thứ nhất hỏng, rồi xác nhận lời gọi thứ hai không chạm vào hệ thống thanh toán.
Bước 4: gửi trả mọi kết quả trong một message
Mọi kết quả của một lượt song song phải quay lại cùng nhau trong message user tiếp theo. Mỗi kết quả khớp với lời gọi của nó qua tool_use_id, và mọi khối tool_result phải đứng trước phần text.
results = await run_turn(tool_blocks, log)
next_user_message = {"role": "user", "content": results} # text, nếu có, đặt sau cùngNếu không cần kiểm soát kỹ như vậy, Anthropic khuyên dùng Tool Runner của SDK. Nó tự xử lý response có nhiều lời gọi và định dạng kết quả giùm bạn.
Chỉ nên tự viết như trên khi cần batching, thứ tự hoặc cách xử lý lỗi riêng. Nếu dùng OpenAI và muốn tránh hẳn chuyện song song, tham số parallel_tool_calls=false giới hạn mỗi lượt còn không hoặc một lời gọi.
Bước 5: đếm lỗi trên bộ ca test, đừng tin cảm giác
Bạn chỉ biết vòng xử lý có tốt không khi đo nó. Anthropic khuyên tạo thật nhiều nhiệm vụ đánh giá dựa trên cách dùng thật. Ngoài độ chính xác, nên thu thêm thời gian chạy của từng lời gọi và từng nhiệm vụ, số lời gọi tool, số token và số lỗi tool.
Ca test kiểu “tra đơn 123” quá dễ. Hãy lấy câu hỏi từ ticket thật: khách hỏi gộp ba ý, nhập sai mã đơn, đòi hoàn tiền cho đơn chưa giao.
def summarize(task_logs):
    calls = [c for log in task_logs for c in log]
    if not calls:  # tránh chia cho 0 và max() trên danh sách rỗng
        return {"tool_error_rate": None, "calls_per_task": 0, "max_call_s": None}
    errors = sum(c["is_error"] for c in calls)
    return {"tool_error_rate": errors / len(calls),
            "calls_per_task": len(calls) / len(task_logs),
            "max_call_s": max(c["seconds"] for c in calls)}
max_call_s chỉ là lời gọi chậm nhất, chưa phải percentile. Khi bộ ca test đủ lớn, bạn nên tính thêm p95 để một lần timeout lẻ không che hết bức tranh.
Thử hình dung một ví dụ giả định: 20 ca test sinh ra 64 lời gọi tool, trong đó 8 lời gọi có is_error. Tỷ lệ lỗi tool là 8/64 = 12,5%. Nhìn vào log, giả sử 5 lỗi đến từ get_shipment timeout.
Bạn sửa thông báo lỗi để model chỉ thử lại một lần, chạy lại cùng 20 ca, rồi so cả tỷ lệ lỗi lẫn số lời gọi mỗi ca. Nếu lỗi giảm mà số lời gọi tăng vọt, có thể agent đang retry vô tội vạ.
Chỗ nào dễ sai nhất khi tự viết?
Chỗ đầu tiên nên rà là lời gọi hỏng hoặc bị bỏ qua mà không sinh ra kết quả, chẳng hạn code bắt exception, ghi log rồi cho qua. Quy tắc của Anthropic rất rõ: lời gọi đó vẫn phải có tool_result với is_error: true. Chỗ thứ hai là đặt text trước các khối tool_result.
Một sai lầm khác có thể gây hậu quả thật: chạy song song các tool có side effect chỉ vì gather tiện tay. Ngoài ra, đừng đưa nguyên traceback vào content rồi thắc mắc vì sao agent cứ lặp lại đúng sai lầm cũ.
Kỹ năng này xuất hiện ở chỗ khách hàng ra sao?
Tool ở chỗ khách hàng là hệ thống của chính họ, nên nhiều khả năng bạn sẽ phải trả lời câu hỏi agent làm gì khi một hệ thống trong số đó chập chờn. Hãy chuẩn bị câu trả lời đó từ trước, đừng đợi bị hỏi.
Có bảng phân loại tool chỉ đọc và có side effect, bạn có cái để mang vào buổi làm việc với đội vận hành của khách. Có tỷ lệ lỗi tool đo trên ca test lấy từ ticket của chính họ, bạn có con số để báo cáo thay vì một bản demo.
Khi viết CV hoặc đi phỏng vấn cho vị trí FDE, hãy kể đúng chuỗi đó: tool nào chạy song song, lỗi được trả về model ra sao, tỷ lệ lỗi trước và sau khi sửa. Lúc đọc job description, nên tìm những yêu cầu về độ tin cậy của agent hay về eval, vì đó là chỗ câu chuyện này có đất dùng.
Agent chạy ổn trong bản demo là chuyện dễ. Agent biết một tool vừa hỏng, chỉ thử lại một lần rồi vẫn trả lời được khách, mới là thứ khách hàng chịu đưa lên production.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!