Lỗi cộng dồn trong agent: vì sao mười bước, mỗi bước đúng 95%, chỉ còn khoảng 60%
Thử riêng thì bước nào cũng ổn, vậy mà ghép lại thì cả luồng vẫn hỏng. Thủ phạm là một phép nhân mà FDE nào cũng nên tính trước khi hứa với khách hàng.

Tóm tắt nhanh
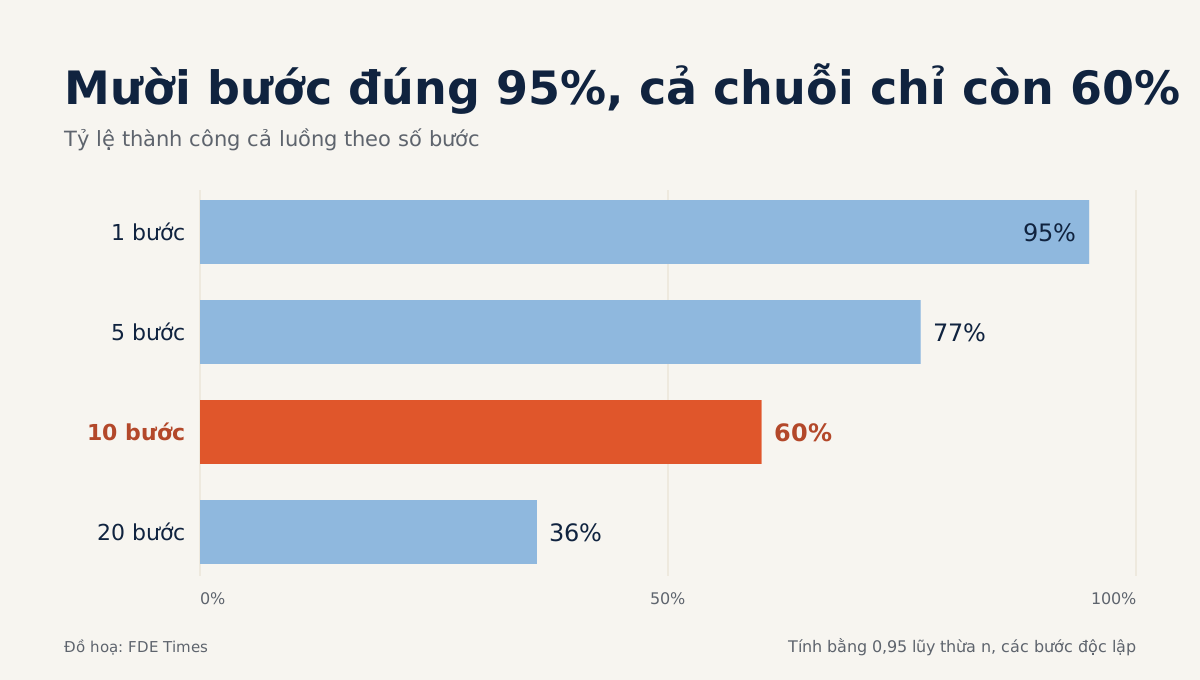
- Mỗi bước đúng 95% thì mười bước còn khoảng 60%, hai mươi bước còn khoảng 36%.
- Ngoài thực tế, độ chính xác mỗi bước còn giảm khi chuỗi dài ra, nên kết quả có thể tệ hơn công thức.
- Cách sửa hiệu quả nhất là bớt bước LLM, rồi đặt điểm kiểm tra theo rủi ro và cho luồng chạy tiếp từ chỗ lỗi.
Thử hình dung buổi demo trước mặt khách hàng diễn ra suôn sẻ. Bạn đã thử riêng từng bước của agent, và bước nào cũng đúng khoảng 19 trên 20 lần. Thế rồi cả luồng mười bước chạy trên dữ liệu thật, và cứ năm lần thì gần hai lần ra kết quả sai hoặc bỏ dở giữa chừng.
Chuyện này không phải do xui. Đó là một phép nhân, và bạn tính được nó trước khi viết dòng code đầu tiên.
Với FDE, phép tính này quyết định hai việc: bạn thiết kế luồng ở khách hàng ra sao, và bạn dám hứa với họ con số nào. Ai chỉ báo độ chính xác của từng bước thì sớm muộn cũng phải giải thích vì sao bản production kém hơn bản demo.
Vì sao 95% lại thành 60%?
Công thức rất đơn giản. Một chuỗi có n bước nối tiếp nhau, mỗi bước đúng với xác suất p, thì cả chuỗi chỉ thành công với xác suất khoảng p^n. Với mười bước ở mức 95%, 0,95^10 cho khoảng 59,9%.
| Số bước | Tỷ lệ thành công cả luồng (p = 95%) |
|---|---|
| 1 | 95% |
| 5 | khoảng 77% |
| 10 | khoảng 60% |
| 20 | khoảng 36% |
| 50 | khoảng 7% |
Mirantis lập một bảng gần như y hệt, với khoảng 59% ở mười bước, và nhận xét rằng ngay cả với mức 95% mỗi bước, vốn đã rất lạc quan, luồng họ phân tích vẫn hỏng khoảng 40% số lần. Utkarsh Kanwat, một kỹ sư tự xây agent, ra cùng các con số và cho rằng 95% là mức lạc quan với LLM hiện nay.
Thử tính với p = 99% sẽ thấy rõ: 20 bước vẫn chỉ còn khoảng 82%. Mài prompt cho từng bước có giúp, nhưng muốn con số nhảy vọt thì phải cắt bớt số bước.
Vì sao con số thật có thể tệ hơn?
Công thức p^n ngầm coi mỗi bước độc lập và có độ chính xác cố định. Mirantis cho rằng ngoài thực tế, lỗi cộng dồn còn tệ hơn phép nhân thuần túy.
Một bài báo tại ICLR 2026 đưa ra lý do cụ thể: độ chính xác mỗi bước của mô hình giảm dần khi số bước tăng. Bước thứ mười không còn đúng 95% như bước thứ nhất, nên mô hình “mỗi bước độc lập” đánh giá thấp vấn đề.
Anthropic gặp đúng chuyện này khi xây hệ thống nghiên cứu đa agent. Đội của họ viết rằng agent có trạng thái nên lỗi cộng dồn. Trong hướng dẫn xây agent, họ cũng nói rõ: tính tự chủ của agent kéo theo chi phí cao hơn và nguy cơ lỗi cộng dồn.
Vì vậy, hãy coi p^n là mức trần lạc quan chứ không phải dự báo. Nếu ngay mức trần đã thấp thì thiết kế đó cần làm lại.
Một ví dụ: agent đối soát hóa đơn
Thử hình dung một khách hàng muốn tự động hóa việc đối soát hóa đơn nhà cung cấp.
Ở bản đầu tiên, LLM điều khiển cả mười bước: phân loại email, tải file PDF, trích số hóa đơn, trích tổng tiền, chuẩn hóa ngày, tra mã nhà cung cấp trong ERP, tìm đơn đặt hàng, so khớp, ghi kết quả vào ERP và gửi email báo.
Mười bước, mỗi bước 95%, nên cả luồng còn khoảng 59,9%.
Giờ hãy hỏi từng bước một câu: bước này có cần suy luận không? Tải file, chuẩn hóa ngày, tra mã trong ERP, ghi kết quả và gửi email đều là việc của code bình thường. Bước phân loại email biến mất nếu khách lập một hộp thư riêng cho hóa đơn.
Hai bước trích xuất cũng gộp lại được thành một lời gọi trả về dữ liệu theo schema.
def reconcile(email):
    pdf = download_attachment(email)              # code
    fields = llm_extract(pdf, schema=InvoiceFields)  # LLM bước 1
    check_fields(fields)        # số tiền dương, mã NCC có trong ERP
    po = erp.find_po(fields.po_number)            # code
    verdict = llm_match(fields, po)               # LLM bước 2
    save_checkpoint(email.id, fields, verdict)
    if verdict.status != "match":
        return queue_for_human(email.id, verdict)  # cổng con người
    erp.post(fields)            # hành động không đảo ngược
Còn lại hai bước LLM: 0,95 nhân 0,95, khoảng 90,25%. Phần code vẫn có thể hỏng, nhưng khi hỏng nó ném ra exception chứ không lặng lẽ bịa ra một con số.
Con số 90,25% giả định các bước code không bao giờ hỏng, nên đừng hứa nó với khách. Hãy ghi log từng lần chạy đầu-cuối, tính cả exception từ bước tải file hay tra ERP, rồi lấy số lần ra kết quả đúng chia cho tổng số lần chạy: đó mới là con số đem đi báo.
Hàm check_fields chặn những lỗi trích xuất dễ thấy trước khi chúng đi tiếp. Mọi trường hợp lệch đều phải chờ người duyệt rồi mới được chạm vào ERP.
Rút ngắn chuỗi thế nào?
Việc đầu tiên là bỏ bước. Vì xác suất nhân với nhau, mỗi bước bỏ được sẽ kéo tỷ lệ cả luồng lên theo phép nhân. Anthropic cũng khuyên tìm giải pháp đơn giản nhất có thể, và chỉ tăng độ phức tạp khi thật sự cần.
Việc thứ hai là chuyển sang code mọi phần không cần suy luận, kèm kiểm tra kết quả trung gian để lỗi không lan sang bước sau. Một phân tích về agent chạy dài hơi nhấn mạnh rằng khả năng phục hồi theo từng bước phải được gắn từ bên ngoài mô hình, không trông vào chính mô hình.
Việc thứ ba là kiểm tra có chọn lọc. Kiểm tra sau mọi bước rất tốn. Blog của Tian Pan lưu ý rằng con người tham gia duyệt chỉ hiệu quả khi điểm kiểm tra được đặt theo rủi ro, không theo lịch cố định.
Trong ví dụ hóa đơn, chỗ rủi ro nhất là ngay sau bước trích xuất và ngay trước khi ghi vào ERP. Anthropic mô tả đúng kiểu thiết kế này: agent dừng lại xin phản hồi của con người tại các điểm kiểm tra hoặc khi gặp vướng mắc.
Việc thứ tư là cho luồng chạy tiếp được sau lỗi. Khi agent hỏng, Anthropic không khởi động lại từ đầu mà để hệ thống tiếp tục từ chỗ lỗi xảy ra, kết hợp retry với checkpoint định kỳ. Dòng save_checkpoint trong đoạn code trên phục vụ đúng mục đích đó.
Những sai lầm hay gặp
Sai lầm phổ biến nhất là đo từng bước rồi báo con số đó cho khách. Khách không trải nghiệm từng bước, họ trải nghiệm cả luồng. Vì thế, hãy đo đầu-cuối trên dữ liệu thật ngay từ tuần đầu.
Sai lầm tiếp theo là thêm một agent “kiểm duyệt” sau mọi bước. Theo đúng phép nhân ở trên, mỗi agent thêm vào là thêm một bước có thể sai, chưa kể chi phí. Tách bài toán thành nhiều agent cho có vẻ hiện đại cũng mắc đúng cái bẫy này.
Sai lầm khó thấy hơn cả là tin rằng lỗi sẽ tự lộ ra. Lỗi nguy hiểm nhất là một trường bị đọc sai nhưng trông vẫn hợp lệ. Vì vậy, điểm kiểm tra nên đối chiếu với nguồn sự thật như ERP hay schema, chứ đừng hỏi lại chính mô hình.
Biến phép tính này thành lợi thế nghề nghiệp
Trong CV, đừng chỉ viết “xây agent đa bước”. Hãy viết rằng bạn giảm số bước LLM từ mười xuống hai, và tỷ lệ thành công đầu-cuối đo được tăng từ bao nhiêu lên bao nhiêu.
Khi phỏng vấn mà được hỏi về thiết kế agent, hãy vẽ luồng ra, đếm số bước rồi tính p^n ngay trên bảng. Người phỏng vấn sẽ thấy bạn quen nghĩ theo kết quả của cả luồng, đúng thứ khách hàng thật sự cần.
Agent tốt nhất ở khách hàng thường không phải agent làm được nhiều bước nhất. Đó là agent chỉ giao cho mô hình đúng những bước mà code không làm được.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
7 nguồn
- The Compound Accuracy Problem: Why Your 95% Accurate Agent Fails 40% of the Time · 2026-04-20
- Why I'm Betting Against AI Agents in 2025 (Despite Building Them) · 2025-07-19
- Why Multi-Step AI Workflows Fail · 2026-05-26
- Building effective agents · 2024-12-19
- How we built our multi-agent research system · 2025-06-13
- The Illusion of Diminishing Returns: Measuring Long Horizon Execution in LLMs · 2026-03-13
- Why Long-Horizon AI Agents Fail: Compounding Error, Memory as Infrastructure, and Step-Level Recovery · 2026-07-03