Dịch vụ chạy ổn hôm nay vẫn có thể chết sau lần reboot đầu tiên
Thủ phạm thường nằm ở ba dòng cấu hình systemd, và bằng chứng có thể đã mất cùng lần khởi động lại.
Tóm tắt nhanh
- start chỉ chạy dịch vụ ngay lúc đó, còn enable mới giúp nó chạy lại sau mỗi lần reboot
- Restart=on-failure không cứu được tiến trình thoát mã 0 sau lỗi, còn crash liên tục sẽ chạm giới hạn khởi động
- Với Storage=auto, máy không có /var/log/journal sẽ mất sạch log khi khởi động lại
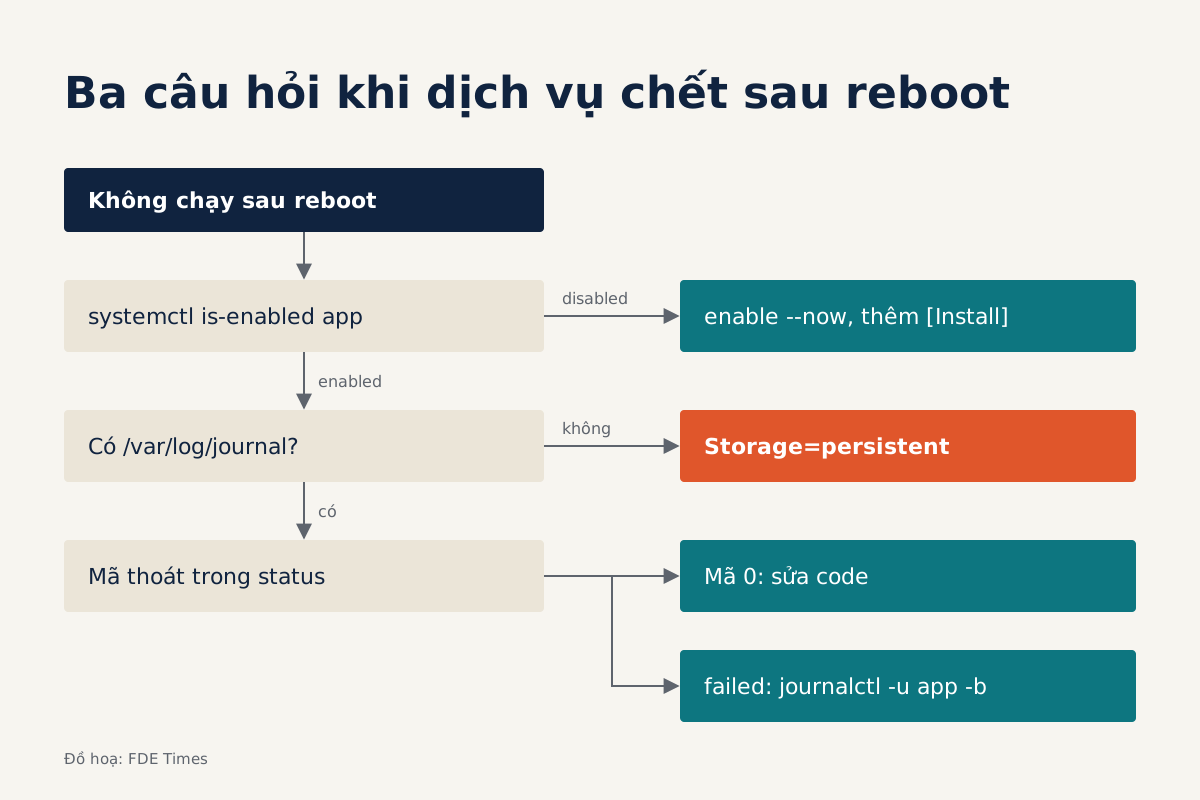
Bạn cài xong dịch vụ trên máy chủ của khách, gõ systemctl start, thấy trạng thái active (running), gửi email báo xong rồi về. Cuối tuần, đội vận hành bên khách vá hệ điều hành và khởi động lại máy. Sáng thứ Hai, dịch vụ không chạy, và journalctl không có dòng nào cho biết chuyện gì đã xảy ra.
Với FDE, kiểu sự cố này đặc biệt khó chịu. Bạn không sở hữu máy chủ, không có người trực ca đêm, và thứ khách nhớ không phải độ chính xác của model mà là việc “hệ thống của bên kia hay chết”.
Có ba nguyên nhân dễ bỏ sót, đều nằm trong cấu hình systemd. Nguyên nhân thứ tư lại khiến bạn khó tìm ra ba nguyên nhân kia: log không được lưu lại.
Start và enable là hai việc độc lập
Tài liệu systemctl viết rất rõ rằng enable và start là hai việc độc lập. Một unit có thể được enable mà không chạy, và cũng có thể đang chạy mà chưa từng được enable. systemctl start chỉ chạy dịch vụ ngay lúc đó, còn sau lần reboot tiếp theo thì systemd không biết phải chạy lại nó.
Ngược lại, systemctl enable không chạy dịch vụ. Lệnh này chỉ tạo symlink dựa trên mục [Install] của unit, và tài liệu nói rõ là nó không đồng thời khởi động unit. Dòng WantedBy=multi-user.target thêm một phụ thuộc kiểu Wants= từ target đó tới dịch vụ của bạn. Hệ quả trực tiếp là unit không có mục [Install] thì không có gì để enable.
Vì thế, lệnh nên gõ khi cài là systemctl enable --now app.service: tạo liên kết cho lần boot sau, đồng thời chạy luôn bây giờ. Sau đó kiểm tra bằng systemctl is-enabled app chứ đừng chỉ nhìn status.
Restart= không làm điều bạn tưởng
Nguyên nhân thứ hai là dịch vụ chết giữa chừng mà không ai dựng nó dậy. Restart= mặc định không bật, và tài liệu systemd.service khuyên dùng on-failure cho các dịch vụ chạy lâu dài.
Bài hướng dẫn của Red Hat về dịch vụ tự phục hồi cũng coi on-failure là chính sách bao được nhiều kịch bản crash nhất, gồm tín hiệu bất thường và mã thoát khác 0.
Nhưng có một cái bẫy. on-failure chỉ khởi động lại khi mã thoát khác 0, hoặc khi gặp tín hiệu hay timeout. Thử hình dung một worker Python bắt mọi exception, ghi log “mất kết nối database” rồi sys.exit(0). Với systemd, đó là một lần thoát sạch, nên dịch vụ nằm im.
Restart=always thì khởi động lại bất kể thoát sạch hay không. Lựa chọn tốt hơn vẫn là sửa code để lỗi trả về mã khác 0, vì với on-failure, một lần thoát mã 0 bị coi là xong việc chứ không phải hỏng. Chỉ dùng always khi bạn không sửa được tiến trình.
Khi systemd bỏ cuộc
Nguyên nhân thứ ba khó thấy hơn. Mỗi lần khởi động lại đều chịu giới hạn tốc độ khởi động của unit, trong khi khoảng chờ mặc định RestartSec chỉ là 100ms. Một dịch vụ crash ngay khi chạy, chẳng hạn vì file cấu hình sai, sẽ dùng hết số lần khởi động được phép rất nhanh.
Tài liệu systemd.unit nói rằng unit bị khởi động quá số lần burst trong một khoảng interval sẽ không được phép khởi động nữa. Ví dụ của Red Hat cấu hình để dịch vụ khởi động lại thất bại hai lần trong 30 giây thì chuyển sang trạng thái failed. Đến lúc đó, Restart= không còn tác dụng: systemd đã dừng thử.
Bạn có thể dùng cơ chế này có chủ đích. Một unit hợp lý cho dịch vụ ở site khách trông như sau:
[Unit]
Description=Customer inference worker
After=network-online.target
Wants=network-online.target
StartLimitIntervalSec=30
StartLimitBurst=2

[Service]
ExecStart=/opt/app/bin/worker
Restart=on-failure
RestartSec=5

[Install]
WantedBy=multi-user.target
RestartSec=5 giúp lỗi tạm thời như database khởi động chậm có thời gian tự hết. Giới hạn burst giúp lỗi vĩnh viễn hiện ra thành trạng thái failed rõ ràng thay vì một vòng lặp crash vô tận.
Bằng chứng biến mất cùng lần reboot
Giờ quay lại buổi sáng thứ Hai. Bạn gõ journalctl -u app -b -1 để xem log của dịch vụ ở lần boot trước, nhưng chẳng có gì. Theo tài liệu journald.conf, với Storage=auto, journal chỉ ghi lên đĩa nếu thư mục /var/log/journal tồn tại, còn không thì log nằm trong bộ nhớ.
Red Hat cảnh báo đúng hậu quả này: các bản ghi bị xoá sau khi reboot, nên bạn không còn dữ liệu lịch sử để phân tích. Cách sửa là tạo chỗ lưu và đặt chế độ persistent:
sudo mkdir -p /var/log/journal
# trong /etc/systemd/journald.conf, mục [Journal]
# Storage=persistent
sudo systemctl restart systemd-journald
Khi đã có log bền vững, bộ ba lệnh chẩn đoán là -u để lọc theo một unit, -b để giới hạn trong một lần boot, và -f để theo dõi trực tiếp khi bạn thử start lại.
Trình tự kiểm tra trước khi rời site
Đừng đợi sự cố mới làm những việc này. Mỗi dòng trong bảng dưới là một câu hỏi bạn nên trả lời được trước khi gửi email báo xong.
| Triệu chứng | Nguyên nhân có thể | Lệnh kiểm tra |
|---|---|---|
| Không chạy sau reboot | Chưa enable hoặc thiếu [Install] |
systemctl is-enabled app |
| Chết giữa chừng, không dậy | Thiếu Restart= hoặc thoát mã 0 |
systemctl status app xem mã thoát |
| Trạng thái failed sau vài lần thử | Chạm giới hạn khởi động | journalctl -u app -b |
| Không có log lần boot trước | Journal chỉ nằm trong bộ nhớ | ls /var/log/journal |
Cách kiểm tra đáng tin nhất vẫn là tự reboot máy staging của khách khi bạn còn ngồi đó, rồi kill tiến trình bằng tay để xem nó có tự dậy không. Năm phút này rẻ hơn rất nhiều so với một cuộc gọi sáng thứ Hai.
Những lỗi lặp đi lặp lại
Một lỗi dễ mắc là đặt Restart=always cho một tiến trình hỏng cấu hình, rồi ngạc nhiên vì nó bị khoá ở trạng thái failed sau vài giây. Lỗi khác là chỉ test bằng start mà không bao giờ test bằng reboot thật.
Lỗi cuối cùng mang tính con người hơn: để lại máy cho khách mà không có runbook. Bàn giao nên có tên unit, lệnh journalctl cần chạy, và giải thích trạng thái failed nghĩa là gì, để người trực bên khách không phải gọi bạn.
Biến kỹ năng này thành điểm cộng trong hồ sơ
Trong phỏng vấn FDE, kể được một lần dịch vụ chết sau reboot, bạn đã chẩn đoán bằng journalctl -u ... -b -1 ra sao và đã sửa unit thế nào, có sức thuyết phục hơn một dòng kỹ năng chung chung.
Trên CV, hãy viết thành kết quả: chuẩn hoá unit file và journal persistent cho các deployment tại site khách, kèm runbook bàn giao.
Bài tập cho tuần này: dựng một VM, cài một worker cố tình thoát mã 0 khi lỗi, cài unit theo mẫu trên rồi reboot. Nếu bạn giải thích được vì sao nó không tự dậy và chỉ ra dòng log chứng minh điều đó, lần tới đến site khách bạn sẽ biết phải kiểm tra gì trước khi về.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
7 nguồn
- systemctl manual (freedesktop.org)
- systemd.unit manual (freedesktop.org)
- systemd.service manual (freedesktop.org)
- Set up self-healing services with systemd · 2021-10-04
- journald.conf manual (freedesktop.org)
- How to configure your system to preserve system logs after a reboot · 2022-06-02
- journalctl manual (freedesktop.org)