Shadow AI ở khách hàng là bản yêu cầu, đừng xử như một vụ án
Một buổi phỏng vấn không truy lỗi biến rủi ro rò rỉ thành danh sách use case đầu tiên của dự án.
Tóm tắt nhanh
- Gần như chắc chắn nhân viên của khách đã dán dữ liệu vào chatbot công cộng trước khi bạn đến
- Lệnh cấm không lấy lại được dữ liệu đã gửi và không xóa được nhu cầu công việc phía sau
- Mỗi lần dán là một use case kèm loại dữ liệu và tần suất, nên hãy lập bảng kê rồi thay bằng công cụ được duyệt
Thử hình dung tuần đầu ở một công ty bảo hiểm. Bạn đang phỏng vấn đội xử lý hồ sơ bồi thường để thiết kế trợ lý nội bộ, thì trưởng nhóm nói rất tự nhiên: “Việc tóm tắt biên bản thì bọn chị làm rồi, dán vào ChatGPT là xong.”
Cả phòng im vài giây, rồi có người liếc sang anh bên IT. Bạn phản ứng thế nào trong vài giây đó sẽ quyết định buổi discovery còn đi tiếp hay không. Tỏ ra hoảng hốt hay trách móc là từ đó trở đi chẳng ai kể thêm điều gì thật với bạn.
Cảnh này không hiếm. Khảo sát của TELUS Digital cho thấy 68% nhân viên dùng tài khoản AI cá nhân trong công việc, và 57% trong số đó thừa nhận đã nhập thông tin nhạy cảm.
Khảo sát shadow AI năm 2026 của PagerDuty ghi nhận 34% nhân viên văn phòng đã nhập dữ liệu hoặc thông tin khách hàng vào công cụ AI công cộng, còn 31% đã nhập thông tin tài chính hoặc tài liệu, chiến lược mật.
Một FDE mang AI vào doanh nghiệp gần như luôn đến sau những lần dán dữ liệu như vậy.
Cấm không lấy lại được dữ liệu đã dán
Phản ứng quen thuộc nhất là cấm. Năm 2023, sau khi một kỹ sư Samsung vô tình làm lộ mã nguồn nội bộ nhạy cảm khi tải lên ChatGPT, công ty ra memo cấm các công cụ generative AI. Lý do họ nêu là dữ liệu gửi cho chatbot nằm lại trên máy chủ của công ty vận hành dịch vụ.
Lo ngại đó có cơ sở, nhưng lệnh cấm chỉ chặn những lần dán sau, không lấy lại được những gì đã gửi. Nó cũng không làm biến mất cả chồng biên bản cần tóm tắt mỗi sáng. Không có công cụ thay thế thì nhu cầu vẫn còn nguyên, và nhiều khả năng người ta chỉ chuyển sang những cách kín đáo hơn.
Thường thì cũng chẳng có quy định nào để dựa vào. Báo cáo chi phí rò rỉ dữ liệu 2025 của IBM cho thấy 63% tổ chức bị rò rỉ chưa có chính sách quản trị AI để quản lý AI hay ngăn nhân viên dùng shadow AI. Nhiều khả năng bạn sẽ là người đầu tiên đặt câu hỏi này một cách có hệ thống.
Khi cần thuyết phục nhà tài trợ, bạn còn có một lý lẽ về chi phí. Cũng báo cáo đó ghi nhận mức shadow AI cao làm chi phí trung bình của một vụ rò rỉ dữ liệu toàn cầu tăng thêm 670.000 USD. Đưa việc dùng AI ra chỗ nhìn thấy được vì thế đáng tiền hơn là cấm rồi để nó chìm xuống.
Mỗi lần dán là một use case
Ý tưởng cốt lõi rất đơn giản: shadow AI vừa cho bạn biết rủi ro nằm ở đâu, vừa cho bạn biết người dùng thật sự cần gì.
Mỗi lần nhân viên dán dữ liệu vào chatbot cho bạn bốn thông tin mà buổi workshop nào cũng khó moi ra: việc gì đang tốn thời gian, dữ liệu gì liên quan, làm bao nhiêu lần, và kết quả cỡ nào thì họ đã thấy đủ dùng.
Nhìn như vậy thì vai của bạn thay đổi. Bạn không đi bắt lỗi. Bạn kiểm kê những việc người dùng đang làm, rồi đưa chúng vào chỗ có kiểm soát.
Tính trước một con số
Giả sử đội bồi thường có 40 người. Lấy tỷ lệ của TELUS làm ước lượng thô, đừng coi là số đo: 68% của 40 là khoảng 27 người dùng tài khoản AI cá nhân. Trong số đó, 57% từng nhập thông tin nhạy cảm, tức khoảng 15 người.
Con số này không dùng để báo cáo, nó giúp bạn đặt đúng câu hỏi. Khi nghĩ rằng có thể đến 15 người đã dán dữ liệu nhạy cảm, bạn sẽ thôi hỏi “có ai dùng không” và chuyển sang hỏi “đang dùng cho việc gì, với loại dữ liệu nào”.
Kịch bản cho buổi nói chuyện
Trước buổi nói chuyện, hãy chốt ranh giới với nhà tài trợ dự án và đầu mối bảo mật của khách. Bạn thu thập việc cần làm và loại dữ liệu, không ghi tên ai.
Nếu gặp dữ liệu thuộc diện quản lý chặt như hồ sơ y tế hay số tài khoản, bạn báo cho đúng một người đã thỏa thuận trước. Có ranh giới đó thì lời hứa không truy lỗi của bạn mới đáng tin.
Mở đầu bằng một câu gỡ thế phòng thủ: “Tôi không đi kiểm tra ai. Tôi muốn biết việc nào đang nặng đến mức mọi người phải tự tìm công cụ, để công cụ mới gánh đỡ đúng những việc ấy.”
Sau đó hỏi năm câu theo thứ tự. “Việc nào anh chị hay nhờ AI làm nhất?” “Anh chị dán vào đó những gì, biên bản, email hay bảng tính?” “Mỗi tuần làm khoảng bao nhiêu lần?” “Kết quả thế nào thì anh chị thấy dùng được?” “Nếu ngày mai không dùng được công cụ đó nữa thì việc nào sẽ bị chậm?”
Câu cuối là câu đáng giá nhất. Nó cho bạn biết việc nào thật sự đáng ưu tiên, và cho nhà tài trợ thấy một lệnh cấm sẽ làm chậm những gì. Ghi câu trả lời vào một bảng kê như dưới đây:
| Việc cần làm | Công cụ, loại tài khoản | Loại dữ liệu | Tần suất | Rủi ro | Hướng xử lý |
|---|---|---|---|---|---|
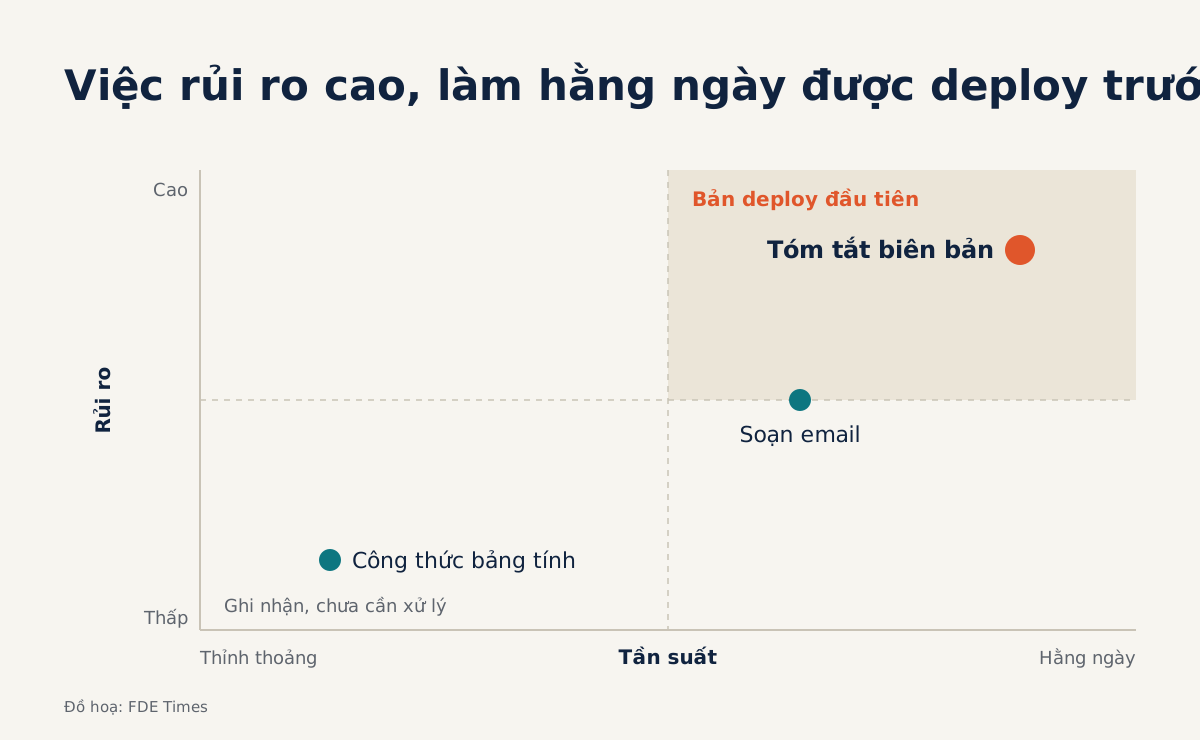
| Tóm tắt biên bản giám định | Chatbot công cộng, cá nhân | Thông tin người được bảo hiểm | Hằng ngày | Cao | Use case đầu tiên của trợ lý nội bộ |
| Soạn email trả lời khách | Chatbot công cộng, cá nhân | Tên, số hợp đồng | Vài lần mỗi tuần | Trung bình | Mẫu soạn sẵn có che dữ liệu |
| Viết lại công thức bảng tính | Chatbot công cộng, cá nhân | Không có dữ liệu khách | Thỉnh thoảng | Thấp | Ghi nhận, chưa cần xử lý |
Từ bảng kê đến công cụ được duyệt
Khi bảng kê đã có, sắp các dòng theo hai cột rủi ro và tần suất. Dòng vừa rủi ro cao vừa làm hằng ngày chính là phạm vi cho bản deploy đầu tiên. Lý do rất thực tế: thay được nó là bạn giảm rủi ro lớn nhất và có ngay người dùng hằng ngày.
Còn dữ liệu đã gửi đi thì để đội bảo mật của khách đánh giá và quyết định cách xử lý. Bạn đưa họ bảng kê, chứ đừng tự kết luận hậu quả hay hứa với ai là dữ liệu đã an toàn.
Khi dựng công cụ thay thế, đặt kiểm soát truy cập vào ngay từ thiết kế. Đừng để dành đến cuối dự án. Theo IBM, 97% tổ chức từng gặp sự cố bảo mật liên quan đến AI nói họ thiếu kiểm soát truy cập AI phù hợp. Con số đó tính cho sự cố AI nói chung, nhưng nó cho thấy chỗ hở thường nằm ở đâu.
Bước cuối là cùng khách viết một chính sách ngắn: loại dữ liệu nào được đưa vào công cụ nào. Chính sách viết từ bảng kê thật sẽ sát thực tế hơn hẳn một văn bản soạn từ đầu.
Những lỗi khiến bạn mất lòng tin
Lỗi phổ biến nhất là ghi tên người. Chỉ cần một cái tên lọt vào báo cáo gửi lãnh đạo, mọi buổi phỏng vấn sau sẽ chỉ còn những câu trả lời an toàn. Lỗi thứ hai là đẩy hết sang bảo mật với lý do ngoài phạm vi dự án, trong khi chính bảng kê này mới định ra phạm vi thật.
Lỗi thứ ba là tiện tay đề xuất cấm luôn cho xong, mà không đưa ra công cụ thay thế. Lỗi thứ tư dễ mắc nhất vì chính bạn gây ra: dán log hay mẫu dữ liệu của khách vào tài khoản AI cá nhân để gỡ lỗi cho nhanh. Khi đó bạn cũng thành một dòng trong bảng kê của chính mình.
Kỹ năng này lên CV thế nào
Nếu tin tuyển dụng FDE bạn nhắm tới có nhắc đến quản trị AI, security review hay làm việc với đội bảo mật của khách, hãy đưa kỹ năng này lên trước. Trên CV, hãy viết theo kết quả, chẳng hạn đã kiểm kê việc dùng AI chưa được duyệt ở một đội bao nhiêu người, và use case nào đã được chuyển sang công cụ có kiểm soát.
Ở vòng phỏng vấn hành vi, đây cũng là câu chuyện kể rất tốt: một tình huống nhạy cảm, một lời hứa không truy lỗi bạn đã giữ, và một bản deploy ra đời từ đó. Người phỏng vấn nhìn vào đó sẽ thấy bạn vừa làm được kỹ thuật vừa giữ được lòng tin của khách.
Vài giây im lặng sau câu “bọn chị dán vào ChatGPT rồi” chính là lúc bạn có được thông tin thật nhất trong cả buổi discovery. Đừng để nó trôi qua bằng một cái nhíu mày.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
4 nguồn
- 2025 Cost of a Data Breach Report: Navigating the AI rush without sidelining security
- Shadow AI: The Hidden Threat to Enterprise Security
- Samsung bans ChatGPT among employees after sensitive code leak · 2023-05-02
- L'intelligence artificielle parallèle est à l'œuvre au sein de votre organisation. · 2026-06-11