Phỏng vấn FDE ở Scale AI: hai vòng HackerRank, một codebase lỗi và kỹ năng thật sự được chấm
Các vòng phỏng vấn FDE ở Scale AI giống một tuần làm việc ở chỗ khách hàng hơn là một kỳ thi thuật toán, vì thế cách ôn cũng phải khác.

Tóm tắt nhanh
- Hai vòng HackerRank mở đầu quy trình, trong đó bài online assessment kéo dài 60 phút với câu hỏi code kiểu dự án.
- Vòng onsite có coding, system design, debugging trên codebase lạ và vòng behavioral xoay quanh tinh thần làm chủ và tốc độ.
- Giao tiếp không có vòng riêng mà được chấm xuyên suốt, nên code trong im lặng là cách dễ mất điểm.
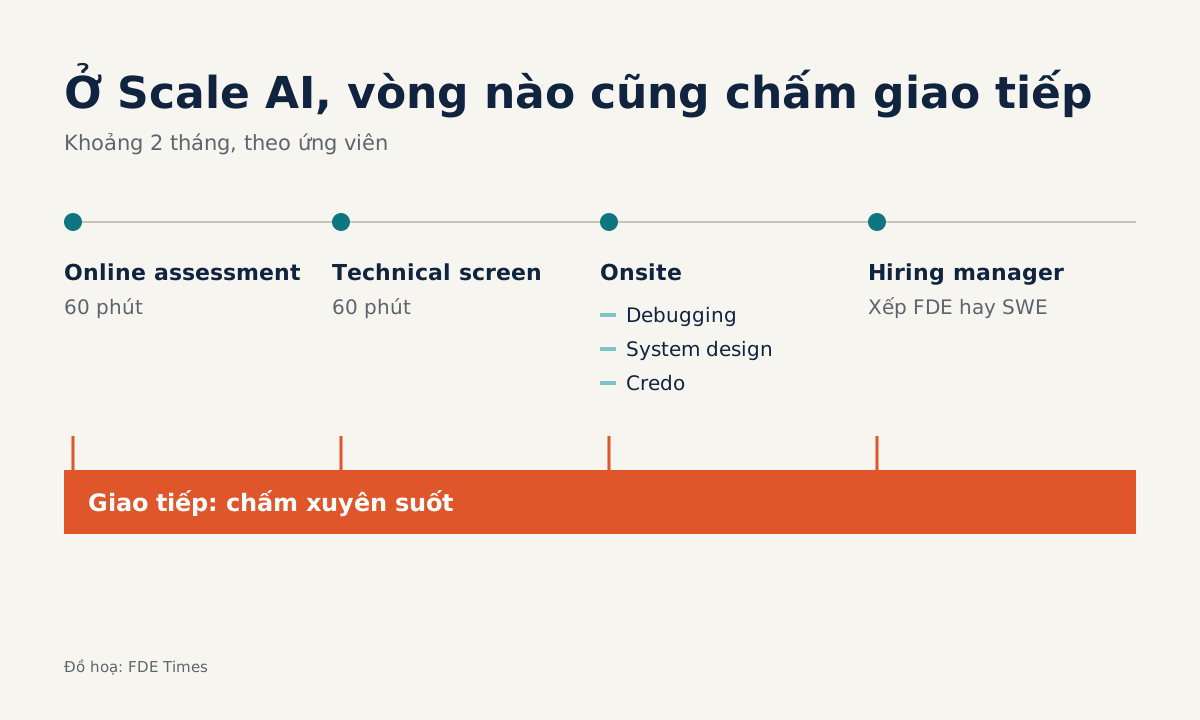
Bạn mở link HackerRank, đồng hồ bắt đầu đếm 60 phút, và đề bài không phải đảo ngược cây nhị phân mà là một dự án nhỏ cần chạy được. Theo hướng dẫn của Aced (trước đây là Exponent), vòng online assessment cho vị trí Forward Deployed Engineer ở Scale AI có dạng như thế, xoay quanh một câu hỏi code kiểu dự án được mô tả là khó.
Đó mới là một trong hai vòng HackerRank bạn phải qua trước khi tới onsite. Final Round AI lại ghi bài assessment dài 50 phút và lưu ý không phải ứng viên nào cũng đi qua các bước theo đúng thứ tự, nên hãy coi mọi mô tả về thời lượng và trình tự là gần đúng.
Đọc kỹ mô tả từng vòng, có thể thấy chúng bám sát những việc một FDE làm hằng tuần: nhận một hệ thống người khác viết, làm nó chạy, và giải thích cho người khác vì sao. Nếu bạn ôn đúng những việc đó, bạn cũng đang luyện chính công việc.
Mỗi vòng mô phỏng một ngày ở chỗ khách hàng
Theo techinterview.org, vòng onsite trực tuyến gồm bốn đến năm vòng: hai vòng coding, một system design, một debugging và một behavioral. Ở vòng debugging, bạn nhận một codebase chưa từng thấy cùng một test đang fail hoặc một triệu chứng được mô tả, có khoảng 45 phút để tìm và sửa lỗi.
Vòng hiring manager, theo Aced, là một vòng behavioral có nội dung gần với vòng credo. Techinterview.org mô tả cuộc trò chuyện này dựa nhiều vào các giá trị của Scale về tinh thần làm chủ và khả năng đi nhanh khi mọi thứ xung quanh đang thay đổi.
Tin tuyển dụng cho thấy vì sao các vòng khớp với công việc. Tin tuyển FDE GenAI của Scale yêu cầu thử nghiệm nhanh, lặp liên tục để đáp ứng nhu cầu khách hàng, và truyền đạt được khái niệm kỹ thuật phức tạp cho cả người kỹ thuật lẫn người không làm kỹ thuật.
Không có vòng giao tiếp, vì vòng nào cũng là vòng giao tiếp
Aced ghi rõ giao tiếp được đánh giá xuyên suốt quy trình và không có vòng riêng cho nó. Một trang khác của Aced khuyên ứng viên trình bày quá trình suy nghĩ và các quyết định của mình trong các vòng kỹ thuật. Techinterview.org nói thẳng hơn: debug trong im lặng trông giống như đoán mò.
Thử hình dung hệ quả. Một ứng viên sửa được ba lỗi trong im lặng có thể gây ấn tượng kém hơn người sửa hai lỗi nhưng nói rõ lỗi thứ ba nằm ở đâu và sẽ xử lý thế nào. Người thứ hai cho thấy đúng hành vi khách hàng cần thấy khi hệ thống của họ đang hỏng.
Thử hình dung 45 phút với một codebase lạ
Giả sử đề debugging là một script tính tỷ lệ đồng thuận giữa các annotator, loại việc rất gần với dữ liệu gán nhãn. Đoạn sau là ví dụ tự dựng để luyện, không phải đề thật:
def agreement_rate(rows, labels_by_task={}):
    for r in rows:
        labels_by_task.setdefault(r["task_id"], []).append(r["label"])
    agreed = 0
    for task_id, labels in labels_by_task.items():
        if len(set(labels)) == 1:
            agreed += 1
    return agreed / len(rows)
Đừng đọc từng dòng tìm lỗi. Hãy dựng một input ba dòng: task A có hai nhãn “cat”, task B có một nhãn “dog”. Hàm trả về 2/3, khoảng 0,667. Nếu quy ước chỉ tính task có ít nhất hai người gán, đáp án đúng là 1/1; nếu tính mọi task, là 2/2. Không cách hiểu nào cho ra 0,667.
Con số sai đó dẫn thẳng tới ba lỗi. Mẫu số đang đếm số dòng thay vì số task, và task chỉ có một nhãn được tính là đồng thuận. Nguy hiểm nhất, labels_by_task={} là mutable default: gọi hàm lần thứ hai với dữ liệu khác, nhãn của lần trước vẫn còn trong dict và làm lệch kết quả.
Thứ tự sửa cũng là một câu trả lời. Lỗi mutable default làm sai số liệu một cách âm thầm giữa các lần chạy, nên nó đứng đầu. Lỗi mẫu số đứng sau, còn lỗi task một nhãn thực chất là câu hỏi nghiệp vụ, nên hãy hỏi người phỏng vấn quy ước trước khi đoán.
Trong lúc làm, hãy nghĩ thành tiếng theo nhịp: đang chạy input nhỏ để tái hiện, kết quả là 0,667 trong khi kỳ vọng 1,0, nghi mẫu số, sửa rồi chạy lại.
Khi hết giờ mà còn lỗi chưa sửa, hãy nói nó nằm ở đâu và bạn sẽ thêm test nào để chặn. Đó là cách biến “không xong hết” thành bằng chứng về tinh thần làm chủ.
LLM nằm ở đâu trong hạ tầng?
Tin tuyển FDE GenAI của Scale đòi thử nghiệm nhanh cho khách hàng và giải thích được cho cả người không làm kỹ thuật, nên khi tự luyện system design, hợp lý là đặt đề có LLM và tập nói thiết kế cho cả hai kiểu người nghe.
Cái bẫy là vẽ một ô “LLM” ở giữa rồi dừng. Trang hướng dẫn phỏng vấn FDE của Sundeep Teki cho rằng lỗi phổ biến nhất là lao vào giải pháp mà không hỏi câu làm rõ nào.
Thử hình dung đề: khách hàng muốn dùng LLM phân loại ticket hỗ trợ. Trước khi vẽ, hãy hỏi ticket đến theo lô hay theo luồng, sai một nhãn thì tốn bao nhiêu, và ai sẽ dùng kết quả. Khi đã rõ ba điều đó, bạn mới bắt đầu vẽ.
Ticket đi vào hàng đợi, worker gọi model với retry và timeout, câu trả lời có độ tự tin thấp chuyển sang người duyệt. Một bộ eval nhỏ có nhãn chuẩn chạy mỗi lần đổi prompt hay model, đúng tinh thần lặp nhanh mà tin tuyển dụng nhắc tới.
Hãy nói cả phương án dự phòng khi API model sập, vì đó là kiểu sự cố một FDE làm việc trực tiếp với khách hàng sẽ phải gánh.
Tự luyện thế nào trong vài tuần
Final Round AI nhận xét bài HackerRank không thưởng cho người giải chậm rãi và cẩn thận. Vì thế, hãy thay một nửa thời gian ôn LeetCode bằng bài code kiểu dự án có giới hạn 60 phút: đọc một file CSV, gọi một API giả, ghi kết quả ra, kèm test.
Tập debug trên repo lạ, mỗi lần đặt giờ và ghi âm phần giải thích của mình. Nghe lại sẽ thấy ngay những đoạn bạn im lặng quá lâu.
Với vòng behavioral và hiring manager, chuẩn bị câu chuyện về lúc bạn tự nhận phần việc khó và lúc bạn phải làm nhanh khi yêu cầu liên tục đổi, có quyết định cụ thể và kết quả đo được. Chuẩn bị thêm một câu trả lời rõ ràng cho câu hỏi vì sao bạn muốn làm FDE.
CV cũng nên nói cùng ngôn ngữ đó. Một dòng như “tiếp nhận pipeline dữ liệu của team khác, tìm và sửa lỗi làm sai báo cáo, trình bày nguyên nhân cho khách hàng” khớp với tin tuyển dụng hơn mọi danh sách framework. Khi đọc job description FDE ở bất kỳ đâu, hãy tìm cặp yêu cầu “code mạnh” và “truyền đạt” đứng cạnh nhau.
Những cái bẫy khiến ứng viên giỏi vẫn trượt
Một cái bẫy dễ rơi vào là cố sửa hết mọi bug trong vòng debugging rồi hết giờ giữa chừng mà không kịp nói gì. Một bẫy khác là trả lời system design như thể LLM luôn đúng và luôn sống, bỏ qua eval và đường lui. Kể chuyện behavioral bằng “team đã làm” thay vì nói rõ phần việc bạn sở hữu cũng làm loãng câu trả lời.
Bẫy tinh vi hơn cả là coi vòng hiring manager là thủ tục.
Phỏng vấn FDE ở Scale AI, rốt cuộc, là bản thu nhỏ của một tuần ở chỗ khách hàng. Hãy ôn như đang chuẩn bị cho tuần đó, đừng ôn như sắp bước vào phòng thi.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
6 nguồn
- Scale AI Forward Deployed Engineer (FDE) Interview Guide | Sample Questions (2026) - Aced (formerly Exponent)
- Get a Job at Scale AI: Interview Process and Top Questions, Aced (formerly Exponent)
- Forward Deployed Engineer, GenAI @ Scale AI | Accel Job Board
- What the Scale AI interview looks like after the Meta deal · 2026-07-14
- Scale AI Interview Process: What to Expect in Each Round
- The Definitive Guide to Forward Deployed Engineer Interviews in 2026 · 2026-01-15