Phỏng vấn FDE ở Databricks: Spark, Unity Catalog và vòng tách một mục tiêu mơ hồ thành hệ thống
Vòng đáng chuẩn bị kỹ nhất không hỏi bạn thuộc bao nhiêu API: người phỏng vấn đưa ra một mục tiêu kinh doanh mù mờ, rồi xem bạn thiết kế hệ thống từ đó trong khoảng một giờ.

Tóm tắt nhanh
- Tin FDE ở Seoul đòi hiểu sâu Spark, kể cả phần runtime bên trong; tin Sr. FDE (Fullstack) ở Zürich giao cho FDE quyết định kiến trúc an toàn, mở rộng được.
- Vòng decomposition khoảng 60 phút bắt đầu từ một mục tiêu kinh doanh mơ hồ, nên những câu hỏi làm rõ ở đầu buổi quan trọng không kém bản thiết kế.
- Ba tin tuyển dụng FDE của Databricks có trọng tâm khác nhau: Spark và MLOps, kiến trúc production, hoặc GenAI. Hãy chọn tin trước khi viết CV.
Thử hình dung người phỏng vấn mở đầu bằng một câu: “Một chuỗi bán lẻ muốn dùng AI để giữ chân khách hàng. Bạn thiết kế đi.” Không có schema, không có số liệu, cũng không ai nói hạn chót là khi nào.
Theo một hướng dẫn phỏng vấn của Aced.io, vòng decomposition ở Databricks có dạng như vậy: khoảng 60 phút để thiết kế một hệ thống từ một mục tiêu kinh doanh còn mơ hồ.
Vòng này khó vì nó giống công việc thật. Tin tuyển dụng Sr. FDE (Fullstack) của Databricks viết rằng kỹ sư sẽ cùng khách hàng xây dựng và đưa vào production các giải pháp cho bài toán dữ liệu và AI của họ. Mục trách nhiệm ghi rõ FDE dẫn dắt những dự án kỹ thuật tạo ra hệ thống đạt chuẩn production.
Vì vậy, nếu bạn chỉ luyện LeetCode thì sẽ hụt. Ba thứ thực sự được kiểm tra là hiểu sâu Spark, nắm governance qua Unity Catalog, và biến một yêu cầu mù mờ thành kiến trúc. Với mỗi thứ, phần dưới đây có một ví dụ để bạn tự làm lại.
Năm vòng, nhưng chỉ ba năng lực
Hướng dẫn của Aced.io mô tả quy trình gồm năm vòng: 30 phút với recruiter, một vòng technical screen, một vòng viết code trong notebook, vòng decomposition và vòng leadership. Đây là mô tả của bên thứ ba, không phải tài liệu chính thức, nên thứ tự và thời lượng có thể khác tùy đội tuyển.
Điều đáng tin hơn là danh sách yêu cầu trong chính tin tuyển dụng. Tin cho vị trí ở Seoul đòi hỏi nhiều kinh nghiệm với tính toán phân tán bằng Apache Spark và hiểu biết về runtime bên trong Spark.
Tin này cũng yêu cầu ứng viên hiểu và dùng được MLOps, mô hình ML/AI và AI API, cùng khả năng viết code bằng nhiều ngôn ngữ. Tin cho vị trí senior ở Zürich thì giao cho FDE quyền quyết định kiến trúc, với điều kiện giải pháp phải an toàn và mở rộng được.
Ghép hai nguồn lại, vòng notebook sẽ kiểm tra Spark, vòng decomposition kiểm tra kiến trúc và governance, còn vòng leadership kiểm tra cách bạn làm việc với khách. Hãy chuẩn bị theo ba năng lực đó, đừng chia thời gian đều cho năm vòng.
Câu hỏi Spark thật ra hỏi về những gì nằm dưới API
Cụm từ “runtime internals” có nghĩa là người phỏng vấn muốn bạn giải thích vì sao một job chạy chậm, chứ không chỉ viết được lệnh join. Một ví dụ kinh điển là data skew.
Giả sử bạn join bảng orders với bảng customers theo customer_id, và Spark chia dữ liệu sau bước shuffle thành 200 partition. Nếu một khách mua sỉ chiếm 40% số dòng của orders, toàn bộ 40% đó sẽ dồn vào một partition. Kết quả là 199 task xong trong vài giây, còn cả job phải chờ một task gánh gần nửa khối lượng công việc.
Một câu trả lời tốt đi theo ba bước. Bước đầu là cách phát hiện: trong Spark UI, thời gian chạy của một task dài vượt hẳn các task khác ở cùng stage. Tiếp theo là giải thích nguyên nhân: shuffle gom mọi dòng có cùng key về một chỗ.
Cuối cùng là hướng xử lý: broadcast bảng nhỏ để khỏi phải shuffle, thêm “muối” (salting) vào key bị lệch để chia nó ra nhiều partition, hoặc bật adaptive query execution để Spark tự tách partition quá lớn.
Đừng chỉ đọc phần này. Hãy tự tạo bảng dữ liệu lệch trong notebook và đo thời gian trước và sau khi xử lý. Khi phỏng vấn, kể lại bằng con số mình tự đo được thuyết phục hơn nhiều so với việc nhắc lại định nghĩa.
Unity Catalog là câu trả lời cho người lo bảo mật
Tài liệu của Databricks định nghĩa Unity Catalog là lớp governance thống nhất cho dữ liệu và AI, được tích hợp sẵn trong nền tảng. Có hai điểm bạn phải nói được ngay khi được hỏi.
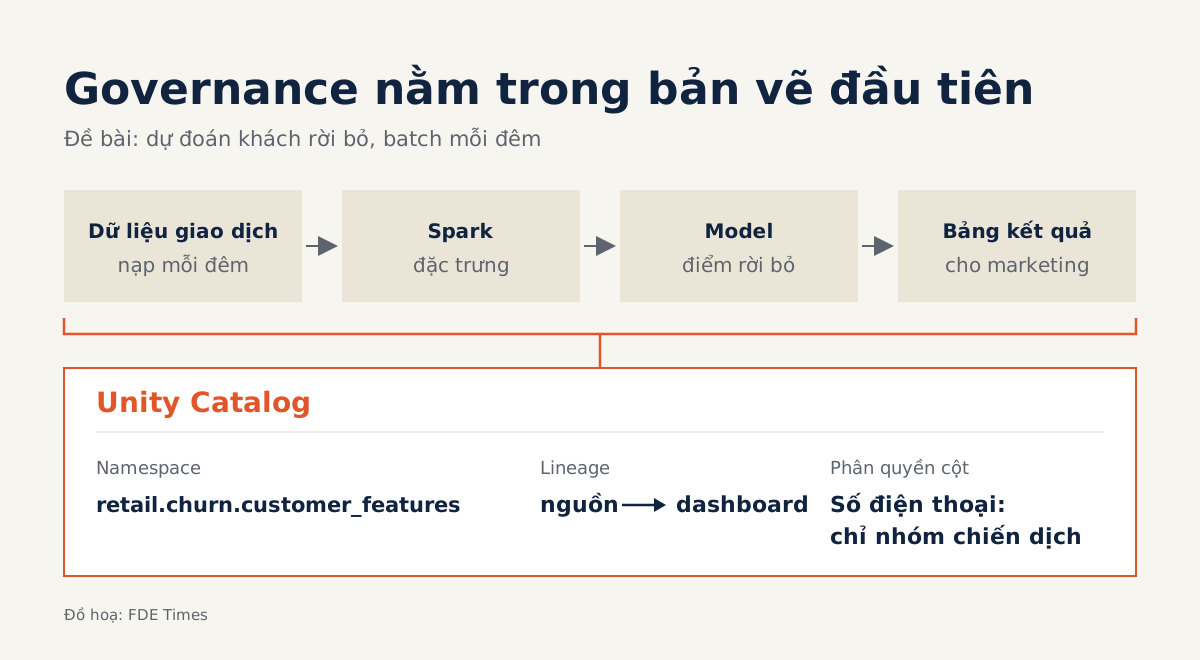
Điểm đầu tiên là namespace ba cấp catalog.schema.object. Trong bài toán bán lẻ ở trên, bảng đặc trưng khách hàng có thể đặt tên là retail.churn.customer_features. Đặt tên rõ ràng như vậy ngay trên bảng vẽ cho thấy bạn đã nghĩ đến chuyện dữ liệu nằm ở đâu và ai được quyền truy cập.
Điểm thứ hai là lineage. Unity Catalog tự động theo dõi cách dữ liệu và các thành phần AI di chuyển và liên kết với nhau, từ dữ liệu nguồn đến model, dịch vụ và dashboard. Lợi ích rất cụ thể: khi giám đốc marketing hỏi con số trên dashboard lấy từ đâu, bạn lần ngược lại được đến bảng gốc mà không phải đi đọc code.
Mười phút đầu quyết định vòng decomposition
Hướng dẫn của Aced.io khuyên dành những phút đầu để làm rõ mục tiêu, vì vòng này thay cho một buổi gặp khách thật. Với đề “giữ chân khách hàng”, bạn có thể hỏi theo trình tự sau:
“Giữ chân được đo bằng gì: tỉ lệ khách quay lại mua trong 90 ngày, hay giá trị đơn hàng trung bình?” “Ai dùng kết quả: đội marketing gửi ưu đãi hàng tuần, hay nhân viên ở cửa hàng?” “Dữ liệu giao dịch hiện nằm ở đâu và bao lâu được cập nhật một lần?” “Có dữ liệu cá nhân nào mà chỉ một số người được xem không?”
Giả sử câu trả lời là: marketing gửi chiến dịch mỗi tuần, dữ liệu cập nhật hằng đêm, và số điện thoại khách là dữ liệu nhạy cảm. Với các điều kiện đó, kiến trúc gần như tự hiện ra.
Dữ liệu được nạp mỗi đêm vào catalog retail, Spark tính đặc trưng, model chấm điểm khả năng rời bỏ, kết quả ghi vào một bảng mà đội marketing đọc được. Cột số điện thoại chỉ mở cho nhóm vận hành chiến dịch.
Bản vẽ chỉ là một nửa; nửa còn lại là bạn giải thích được vì sao chọn cách này mà không chọn cách khác. Chẳng hạn, bạn chọn batch thay vì streaming vì chiến dịch chạy theo tuần, nên chấm điểm theo thời gian thực chỉ làm tăng chi phí mà không thêm giá trị.
Bạn thêm phần giám sát model theo kiểu MLOps vì hành vi mua sắm thay đổi theo mùa. Bạn chỉ vào lineage để chứng minh hệ thống kiểm toán được.
Chọn đúng tin tuyển dụng trước khi nộp hồ sơ
Ba tin tuyển dụng FDE của Databricks đặt trọng tâm khác nhau khá rõ, và CV nên viết riêng cho từng tin.
| FDE (Seoul) | Sr. FDE – Fullstack (Zürich) | AI Engineer – FDE | |
|---|---|---|---|
| Trọng tâm | Tính toán phân tán bằng Spark, runtime internals | Hệ thống production-grade, quyết định kiến trúc | Ứng dụng GenAI |
| Kinh nghiệm cần chứng minh | Spark chuyên sâu; MLOps, mô hình ML/AI, AI API; code nhiều ngôn ngữ | Từ 6 năm trở lên trong data engineering, data platform & analytics hoặc software engineering | RAG, hệ multi-agent, Text2SQL, fine-tuning |
| Nhịp làm việc với khách | — | Dẫn dắt dự án kỹ thuật của khách | Đi gặp khách 4–8 tuần một lần khi cần |
Dù nộp vị trí nào, mỗi gạch đầu dòng trong CV nên nêu được ba thứ: một hệ thống đã đưa lên production, một con số đo được, và cách bạn xử lý phân quyền hoặc truy vết dữ liệu. Ví dụ, “giảm thời gian join từ X xuống Y nhờ xử lý skew” có sức nặng hơn hẳn dòng “thành thạo Spark”.
Những lỗi khiến ứng viên giỏi vẫn trượt
Lỗi phổ biến nhất là vẽ kiến trúc ngay khi vừa nghe đề. Người phỏng vấn đang đóng vai khách hàng, và bỏ qua bước hỏi để làm rõ cũng giống như bỏ qua buổi discovery với khách thật.
Lỗi thứ hai là trả lời về Spark ở mức API trong khi tin ở Seoul ghi rõ yêu cầu hiểu runtime. Lỗi thứ ba là chỉ nhắc đến governance khi bị hỏi, trong khi tin senior Fullstack yêu cầu giải pháp phải an toàn ngay từ khâu thiết kế.
Ở vòng leadership, câu chuyện chung chung kiểu “tôi làm việc nhóm tốt” sẽ thua một câu chuyện có khách hàng cụ thể, một mâu thuẫn cụ thể và một quyết định bạn đã chịu trách nhiệm.
Bạn không cần thuộc hết mọi tính năng của Databricks. Bạn cần cho người phỏng vấn thấy rằng nếu ngày mai họ đưa bạn đến gặp một khách hàng có yêu cầu còn mơ hồ, bạn sẽ hỏi đúng câu, chọn đúng kiến trúc và để lại một hệ thống mà người khác truy vết được.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!