Git bisect cho agent LLM: tìm ra thay đổi làm agent của khách tệ đi chỉ sau vài vòng eval
Khi khách báo "agent dạo này trả lời kém hẳn", phỏng đoán không giúp được bạn; tìm kiếm nhị phân trên lịch sử thay đổi cùng một eval chịu được nhiễu thì có.

Tóm tắt nhanh
- Git bisect dùng tìm kiếm nhị phân để tìm commit gây lỗi đầu tiên: 64 thay đổi chỉ cần khoảng 6 vòng kiểm tra
- Với LLM, bước phán good/bad phải là một eval được chạy nhiều lần rồi lấy trung bình, vì temperature 0 vẫn không tất định
- Nếu lịch sử prompt không tìm ra thủ phạm, nhiều khả năng model đã đổi: hãy bisect trên tích phiên bản prompt và phiên bản model
Thứ Hai, khách nhắn: agent hỗ trợ nội bộ của họ “dạo này hay trả lời lạc đề”. Hai tuần qua team bạn đã merge khoảng 60 thay đổi: sửa system prompt, thêm tool, đổi cách cắt tài liệu cho retrieval, nâng phiên bản model. Ai cũng có một giả thuyết riêng, nhưng không ai chứng minh được giả thuyết của mình.
FDE nào phụ trách agent cho khách rồi cũng sẽ nhận một tin nhắn như thế, và người đoán nhanh nhất chưa chắc là người tìm ra lỗi.
Người xử lý tốt có một quy trình khoanh vùng cơ học, cứ làm theo là ra, không phụ thuộc vào trực giác. Kỹ thuật đó đã có từ lâu trong Git.
Thứ bạn cần thêm là cách điều chỉnh nó cho hành vi của LLM, vốn không tất định.
Tìm kiếm nhị phân rẻ hơn bạn nghĩ
Theo tài liệu chính thức của Git, git bisect dùng thuật toán tìm kiếm nhị phân trên lịch sử commit để tìm commit đầu tiên gây lỗi. Bạn chỉ cần hai mốc: một commit chắc chắn tốt (good) và một commit chắc chắn tệ (bad). Git checkout commit ở giữa, bạn phán commit đó tốt hay tệ, và khoảng tìm kiếm bị chia đôi.
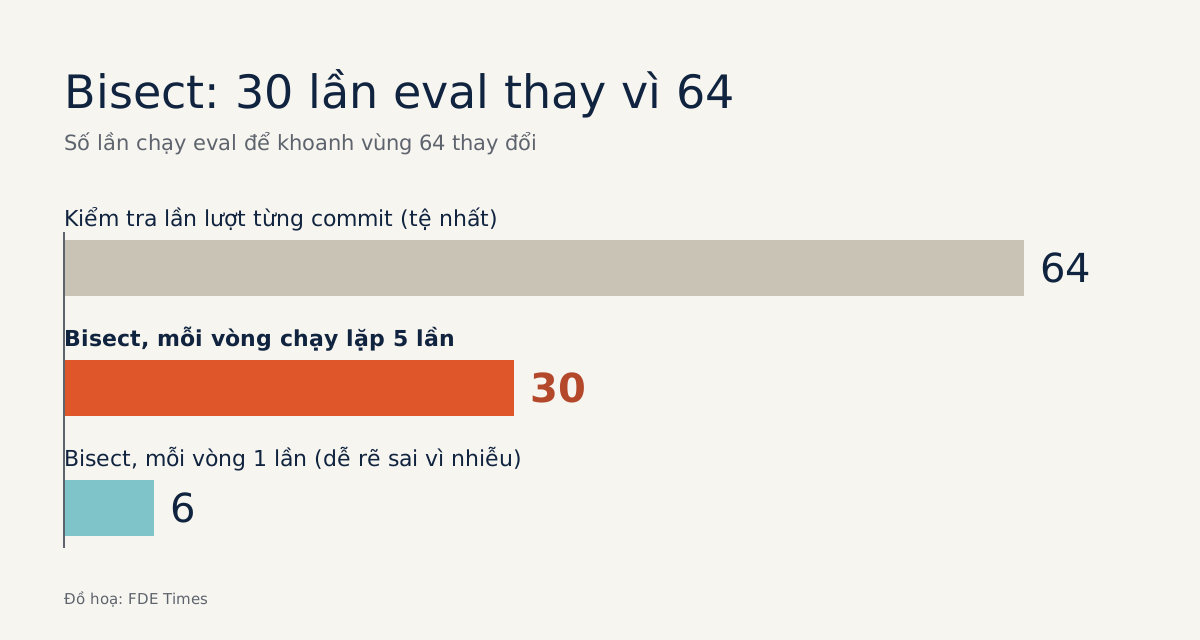
Thử tính với 64 thay đổi. Sau mỗi vòng còn 32, rồi 16, 8, 4, 2, 1, tức là khoảng 6 vòng là tới đích. Kiểm tra lần lượt từng commit thì trường hợp xấu nhất phải chạy 64 lần. Với agent, mỗi lần chạy eval tốn tiền API và thời gian, nên chênh lệch giữa 6 và 64 có ý nghĩa thật.
Tài liệu Git còn cho phép tự động hoá toàn bộ quá trình bằng git bisect run: nếu có một script biết phán mã nguồn hiện tại tốt hay tệ, Git sẽ tự chạy hết các vòng. Với agent, script đó chính là eval của bạn.
LLM phá vỡ hai giả định của bisect
Nhóm tác giả bài báo “Time Travel” trên arXiv chỉ ra rằng bisect truyền thống giả định phép kiểm tra là tất định và trạng thái lỗi là nhị phân. Hành vi LLM thường vi phạm cả hai giả định. Một unit test hoặc pass hoặc fail, còn eval của agent cho ra điểm số, và điểm số đó dao động.
Bài viết về prompt bisect trên blog của Tian Pan nhắc một điều nhiều kỹ sư vẫn quên: temperature bằng 0 thực ra không tất định. Cùng một commit, chạy hai lần có thể ra 0,84 và 0,79. Nếu ngưỡng của bạn nằm giữa hai con số đó, bisect sẽ rẽ sai hướng ngay vòng đầu, và mọi vòng sau đều tìm trong sai nửa.
Cách chữa mà Tian Pan đưa ra là chạy mỗi bước bisect nhiều lần rồi lấy trung bình, để một lần chạy lệch không tự quyết định phán quyết. Cái giá là số lần eval nhân lên đúng bằng số lần chạy lặp: 6 vòng, mỗi vòng 5 lần, là 30 lần eval. Con số đó vẫn rẻ hơn nhiều so với đoán mò cả tuần.
Một ví dụ chạy từ đầu đến cuối
Giả sử bản v1.4 hai tuần trước đạt điểm trung bình 0,91 trên bộ eval 40 ca, còn HEAD hôm nay chỉ đạt 0,72. Ngưỡng hợp lý là một điểm nằm giữa hai mức, chẳng hạn 0,82, đủ xa cả hai để nhiễu không lật kết quả. Script phán quyết có thể trông như sau:
# eval_gate.py — đặt NGOÀI repo đang bisect, ví dụ ~/tools/eval_gate.py
import json, statistics, subprocess, sys

RUNS = 5           # số lần chạy lặp cho mỗi commit
THRESHOLD = 0.82   # nằm giữa điểm good (0.91) và bad (0.72)

def run_once():
    out = subprocess.run(
        ["python", "-m", "evals.run", "--cases", "/frozen/cases.jsonl", "--json"],
        capture_output=True, text=True, timeout=900,
    )
    if out.returncode != 0:
        raise RuntimeError(out.stderr)
    return json.loads(out.stdout)["score"]

try:
    scores = [run_once() for _ in range(RUNS)]
except Exception:
    sys.exit(125)   # commit này không chạy được eval: bỏ qua, đừng phán bad

mean = statistics.mean(scores)
print(f"mean={mean:.3f} scores={scores}")
sys.exit(0 if mean >= THRESHOLD else 1)
Sau đó chạy:
git bisect start
git bisect bad HEAD
git bisect good v1.4
git bisect run python ~/tools/eval_gate.py
git bisect reset
Các exit code trong script tuân theo đúng quy ước của Git. Mã 0 là good, các mã từ 1 đến 127 trừ 125 là bad, 125 nghĩa là commit này không test được và Git sẽ bỏ qua nó, còn các mã khác làm huỷ cả phiên bisect.
Việc trả về 125 khi eval bị crash quan trọng hơn bạn tưởng. Một commit lỗi cú pháp trong file cấu hình không có nghĩa là agent trả lời tệ, và phán nó là bad sẽ làm sai lệch toàn bộ phép tìm kiếm.
Có hai chi tiết nhỏ trong script quyết định kết quả. Bộ ca eval phải được đóng băng ở một đường dẫn cố định ngoài repo, và script cũng phải nằm ngoài repo, vì mỗi lần Git checkout một commit cũ, mọi file trong cây thư mục, kể cả bộ test, sẽ quay về phiên bản cũ.
Khi đó bạn đang đo bằng một cây thước liên tục đổi độ dài.
Bisect chỉ tìm được những gì đã nằm trong lịch sử
Giả sử bisect chạy xong và báo commit a3f9c1 là thủ phạm, nhưng commit đó sửa cùng lúc năm phần của system prompt. Bạn mới đi được nửa đường.
Bước tiếp theo vẫn dùng đúng phép toán của git bisect, chỉ đổi đơn vị. Theo Tian Pan, đơn vị thay đổi của prompt nên là một hunk, tức một sửa đổi liền mạch trong một phần của prompt. Vậy hãy tách commit đó thành từng hunk, áp dụng dần lên phiên bản good, rồi bisect tiếp ở cấp độ này.
Trường hợp khó hơn là bisect không tìm ra gì: mọi commit đều cho điểm như nhau, nhưng hôm nay điểm vẫn thấp hơn tuần trước. Khi đó thủ phạm có thể không nằm trong repo của bạn, vì chính dịch vụ model cũng thay đổi theo thời gian.
Nghiên cứu của nhóm Chen, Zaharia và Zou cho thấy hành vi của “cùng một” dịch vụ LLM có thể đổi đáng kể trong thời gian ngắn.
Độ chính xác của GPT-4 trên bài toán số nguyên tố giảm từ 84.0% vào tháng 3 xuống 51.1% vào tháng 6/2023, còn tỉ lệ model chịu trả lời câu hỏi khảo sát ý kiến giảm từ 97.6% xuống 22.1%.
Với FDE, một cú trượt cỡ đó sẽ kéo điểm eval xuống dù repo không đổi một dòng nào. Chỉ khi có điểm baseline gắn với một phiên bản model được ghim, bạn mới nhận ra điểm giảm đến từ phía nhà cung cấp chứ không phải từ commit của team.
Nếu nhà cung cấp đổi model, lịch sử prompt sẽ không cho bạn manh mối nào. Tian Pan đề xuất chạy trên tích của các phiên bản prompt và phiên bản model. Một bước khởi đầu thực tế là giữ prompt ở bản good rồi đổi sang model hiện tại, sau đó làm ngược lại: bạn sẽ biết lỗi nằm ở trục nào trước khi bisect sâu hơn.
Vì thế, ngay từ ngày đầu ở khách hàng, hãy ghi tên model kèm phiên bản cụ thể vào file cấu hình được commit, không dùng alias kiểu “latest”. Dữ liệu cũng vậy.
Cấu hình chunking, phiên bản index và snapshot tài liệu nên được tham chiếu bằng mã phiên bản trong repo, để thay đổi dữ liệu cũng trở thành một commit có thể bisect.
Những lỗi làm bisect nói dối
Lỗi phổ biến nhất là skip quá tay. Tài liệu Git cảnh báo rằng nếu bạn bỏ qua một commit nằm sát commit thủ phạm, Git sẽ không thể chỉ ra chính xác commit nào là first bad. Vì vậy chỉ trả 125 khi eval thực sự không chạy được; một commit cho điểm khó hiểu không phải lý do để skip.
Một cái bẫy khác là chọn ngưỡng quá sát một trong hai mốc, khiến nhiễu tự quyết định kết quả. Hãy chạy cả mốc good và mốc bad năm lần trước khi bắt đầu. Nếu khoảng dao động của hai mốc chồng lên nhau, bộ eval quá nhỏ hoặc quá ồn để bisect, và bạn cần sửa bộ eval trước.
Thử hình dung: mốc good cho từ 0,89 đến 0,93, mốc bad cho từ 0,70 đến 0,74, nên ngưỡng 0,82 nằm gọn trong khoảng trống ở giữa. Nhưng nếu mốc good dao động từ 0,78 đến 0,90, ngưỡng 0,82 rơi vào vùng nhiễu và mỗi vòng bisect gần như tung đồng xu.
Cuối cùng, đừng quên rằng bisect giả định regression đơn điệu. Nếu một commit làm điểm giảm rồi một commit sau lại vô tình kéo điểm lên, kết quả bisect chỉ cho bạn một trong hai điểm chuyển, không phải toàn bộ câu chuyện.
Biến kỹ năng này thành bằng chứng trong CV
Với khách hàng, báo cáo “hunk thứ ba của commit a3f9c1 làm điểm giảm từ 0,91 xuống 0,72, sau đây là bản sửa” thuyết phục hơn hẳn câu “chắc là do prompt”. Với nhà tuyển dụng cũng vậy.
Một dòng CV như “khoanh vùng regression của agent xuống một thay đổi prompt duy nhất bằng bisect tự động có eval chạy lặp” cho thấy bạn hiểu cả Git, cả eval lẫn tính không tất định của LLM. Khi phỏng vấn, hãy kể lại một lần như vậy kèm số vòng bisect và mức điểm trước, sau khi sửa.
Agent nào cũng sẽ có lúc tệ đi. FDE có sẵn một script phán good/bad và lịch sử được ghim phiên bản sẽ trả lời câu hỏi “vì sao” sau chừng sáu vòng eval. Người thiếu hai thứ đó chỉ còn cách đoán.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!