Bản ghi lỗi của khách đi đâu khi pipeline không được phép dừng
Dead letter queue giữ được dữ liệu hỏng, nhưng chỉ khi retry, retention và người trực được cấu hình đúng.
Tóm tắt nhanh
- Mặc định Kafka Connect dừng khi gặp lỗi. Còn với errors.tolerance=all, connector bỏ bản ghi hỏng mà không ghi log. Cả hai cách đều nguy hiểm với dữ liệu của khách.
- DLQ chỉ an toàn khi số lần retry đủ rộng cho lỗi tạm thời, DLQ được giữ lâu hơn hàng đợi gốc, và topic DLQ có subscription.
- DLQ là công cụ debug: luôn ghi lý do lỗi vào message, phải có người đọc nó, và chỉ redrive sau khi đã sửa lỗi.
Thử hình dung tình huống này: hai giờ sáng, một khách hàng bán lẻ gọi điện báo bảng đơn hàng trong data warehouse đã đứng yên từ tối. Nguyên nhân chỉ là một bản ghi có trường ngày tháng sai định dạng. Connector gặp nó thì dừng, và hàng chục nghìn bản ghi lành phía sau cũng phải chờ theo.
Phản xạ đầu tiên của nhiều kỹ sư là bật chế độ bỏ qua lỗi để pipeline chạy tiếp. Lúc đó vấn đề thứ hai xuất hiện: một tháng sau, bộ phận tài chính của khách thấy doanh thu lệch mà không ai giải thích được, vì không còn dấu vết nào cho thấy bản ghi kia từng tồn tại.
Làm FDE ở chỗ khách, bạn sẽ gặp thế kẹt này nhiều lần: pipeline không được dừng, mà dữ liệu cũng không được mất. Dead letter queue (DLQ) gỡ được thế kẹt đó, với điều kiện bạn biết nó có thể hỏng ở những chỗ nào.
Dừng hay bỏ qua, khách đều chịu thiệt
Khi một message không xử lý được, hệ thống chỉ có ba cách: dừng lại, bỏ qua, hoặc đưa message ra chỗ khác. Kafka Connect mặc định chọn dừng. Nếu đặt errors.tolerance=all, connector bỏ qua bản ghi hỏng, và một bài phân tích của Confluent gọi kiểu bỏ qua lặng lẽ này là “YOLO”.
Chữ “lặng lẽ” ở đây đúng theo nghĩa đen. Theo Confluent, khi đã bật chế độ chịu lỗi, mặc định connector không ghi log việc nó đang làm rơi message. Không cấu hình DLQ hay logging thì bạn mất dữ liệu mà không có cách nào biết.
Cách thứ ba là đưa bản ghi vào một hàng đợi riêng. Tài liệu của AWS về SQS mô tả DLQ trước hết là công cụ debug: message không tiêu thụ được sẽ bị cách ly để bạn tìm hiểu vì sao nó xử lý thất bại. Hãy coi DLQ như một khu cách ly có người khám bệnh, đừng coi nó là thùng rác.
Một pipeline đơn hàng, cấu hình từng dòng
Quay lại khách hàng bán lẻ ở trên: đơn hàng đi qua Kafka Connect vào warehouse. Với connector đó, một cấu hình hợp lý sẽ trông như sau:
errors.tolerance=all
errors.deadletterqueue.topic.name=dlq-orders-sink
errors.deadletterqueue.context.headers.enable=true
errors.log.enable=true
Dòng thứ ba đáng giá nhất. Kafka Connect có thể ghi lý do một message bị từ chối vào header của chính message đó. Sáng hôm sau mở DLQ ra, bạn biết ngay bản ghi nào lỗi và lỗi gì, không phải chạy lại để đoán.
Như đã nói, khi bật tolerance thì mặc định connector không ghi log việc làm rơi message. Dòng này cho bạn thêm một dấu vết trong log, bên cạnh DLQ, để việc mất dữ liệu không thể diễn ra trong im lặng.
Trên Confluent Cloud, lỗi serde (serialize/deserialize) cũng không làm connector dừng: connector vẫn chạy tiếp và đưa bản ghi lỗi sang một topic DLQ.
Giả sử phần đơn hàng của khách lại chạy trên SQS. Khi đó con số then chốt là maxReceiveCount trong redrive policy, tức số lần consumer được nhận một message trước khi message bị chuyển sang DLQ:
{
  "deadLetterTargetArn": "arn:aws:sqs:...:orders-dlq",
  "maxReceiveCount": 5
}
AWS khuyên chừa đủ chỗ cho retry. Nếu đặt giá trị này là 1, chỉ một lần thất bại, chẳng hạn do database chập chờn vài giây, cũng đủ đẩy message vào DLQ. Khi đó DLQ đầy những đơn hàng hoàn toàn hợp lệ, và vài bản ghi hỏng thật bị lẫn mất trong đó.
Phép tính retention làm mất message
Bẫy khó thấy nhất nằm ở retention. Với hàng đợi standard của SQS, message chuyển sang DLQ vẫn giữ timestamp lúc nó vào hàng đợi gốc. Vì vậy AWS khuyên luôn đặt retention của DLQ dài hơn retention của hàng đợi gốc.
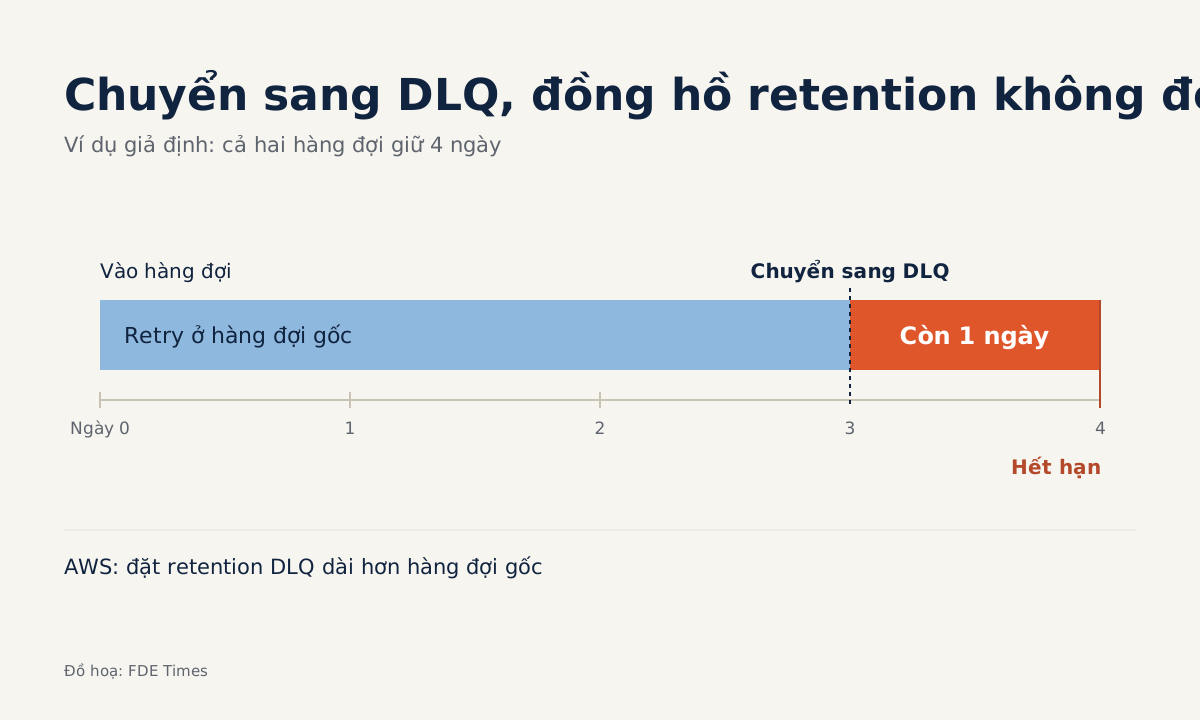
Lấy một ví dụ giả định cho dễ thấy: cả hai hàng đợi cùng giữ message 4 ngày. Một đơn hàng vào hàng đợi ở ngày 0, retry mãi đến ngày 3 mới bị chuyển sang DLQ.
Đồng hồ không đếm lại từ đầu, nên bạn chỉ còn 1 ngày để điều tra. Nếu hôm đó rơi vào cuối tuần, message có thể hết hạn trước khi có ai mở ra xem.
Google Pub/Sub có một bẫy khác. Số lần gửi tối đa trước khi message bị chuyển sang dead-letter topic phải là một số nguyên từ 5 đến 100. Nhưng nếu dead-letter topic chưa có subscription thì các message chuyển sang đó sẽ mất, nên tài liệu của Google nhắc bạn phải thêm subscription cho topic này.
| Nền tảng | Thiết lập cần chỉnh | Chỗ dễ mất dữ liệu |
|---|---|---|
| SQS | maxReceiveCount, retention của DLQ |
DLQ có retention bằng hoặc ngắn hơn hàng đợi gốc |
| Kafka Connect | errors.tolerance, topic DLQ, header ghi lý do |
Bật tolerance mà không có DLQ hay log |
| Pub/Sub | Số lần gửi tối đa, từ 5 đến 100 | Dead-letter topic chưa có subscription |
Triển khai tại chỗ khách theo thứ tự nào?
Trước hết hãy hỏi khách một câu: thứ tự message có quan trọng với họ không. AWS cảnh báo không nên gắn DLQ vào hàng đợi FIFO nếu bạn không muốn phá thứ tự chính xác của message hay thao tác. Một chuỗi cập nhật số dư tài khoản khác hẳn một luồng log sự kiện, và câu trả lời này quyết định cả thiết kế.
Tiếp theo, chọn số lần retry theo loại lỗi tạm thời mà hệ thống của khách hay gặp. Đặt retention của DLQ dài hơn hàng đợi gốc, bật ghi lý do lỗi, và kiểm tra rằng DLQ đã có subscription hoặc consumer. Sau đó đặt cảnh báo khi DLQ có message mới, và thống nhất với khách ai là người nhận cảnh báo đó.
Bước cuối là runbook. Với SQS, điều tra xong thì có thể đưa message trở lại bằng DLQ redrive. Thứ tự đúng là đọc lý do, sửa code hoặc dữ liệu, rồi mới redrive. Làm ngược lại thì message chỉ chạy thêm một vòng rồi quay về DLQ.
Những lỗi gặp lại ở nhiều dự án
Lỗi phổ biến nhất là coi DLQ như thứ dựng lên cho có: có cấu hình nhưng không có cảnh báo, không ai chịu trách nhiệm, và nhiều tuần liền không ai mở ra.
Kế đến là đặt retry quá thấp, khiến DLQ đầy lỗi tạm thời. Rồi đến hai phép tính retention và subscription đã nói ở trên, vì cả hai đều làm mất message mà không báo gì.
Còn một lỗi về giao tiếp: không cho khách biết DLQ tồn tại. Hãy đưa số bản ghi trong DLQ vào báo cáo định kỳ. Khách sẽ tin hệ thống hơn khi đọc thấy “12 bản ghi lỗi định dạng ngày, đã sửa và chạy lại” thay vì gặp một con số doanh thu lệch mà không ai giải thích được.
Về nghề nghiệp, đây là kỹ năng nên ghi rõ trong CV. Thay vì viết “xây pipeline dữ liệu”, hãy viết rằng bạn đã thiết kế xử lý lỗi bằng DLQ, kèm runbook redrive, cho một hệ thống chạy production. Trong phỏng vấn thiết kế hệ thống, khi bị hỏi “nếu một bản ghi hỏng thì sao”, đừng chỉ nói “thì retry”.
Hãy kể đủ ba thiết lập: số lần retry đủ rộng cho lỗi tạm thời, retention của DLQ dài hơn hàng đợi gốc, và lý do lỗi ghi vào header cùng một subscription để DLQ thực sự có người đọc.
Bài tập cho tuần này
Dựng một hàng đợi test có DLQ, rồi gửi vào một message cố tình sai schema. Theo nó qua từng lần retry, đọc lý do lỗi trong DLQ, sửa consumer, rồi redrive và xác nhận message đã tới đích.
Làm xong một vòng như vậy, lần tới khách gọi lúc hai giờ sáng, bạn sẽ chỉ ngay được cho họ từng bản ghi lỗi đang nằm ở đâu.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!