Khách hỏi dữ liệu xử lý ở đâu? Region lưu trữ chưa trả lời được
Nơi lưu dữ liệu và nơi mô hình suy luận là hai cài đặt riêng, và khách cần bằng chứng cho cả hai.
Tóm tắt nhanh
- Region của workspace hay resource chỉ cho biết dữ liệu nằm yên ở đâu. Nơi mô hình chạy suy luận là một cài đặt khác.
- Ở Anthropic, inference_geo mặc định là "global". Deployment Global của Azure và profile global của Bedrock cũng có thể định tuyến ra khắp thế giới, nên phải chọn đúng loại.
- Khách không cần lời hứa. Họ cần config được ghim trong code, log ghi vùng suy luận thật và danh sách những gì cam kết không bao phủ.
Trang tài liệu data residency của OpenAI có một câu mà FDE nào cũng nên thuộc lòng: có lưu trữ theo vùng không có nghĩa là có xử lý theo vùng. Câu đó chỉ ra đúng khe hở mà một buổi review bảo mật dễ vướng vào nhất.
Đội pháp chế của khách hỏi “dữ liệu xử lý ở vùng nào?”, và câu trả lời dễ nhất là chỉ vào region của workspace hay resource. Câu đó đúng với dữ liệu nằm trên đĩa. Nó chưa nói gì về chuyện prompt được gửi tới máy chủ nào để mô hình sinh câu trả lời.
Trả lời sai câu này thì dự án có thể kẹt ở khâu phê duyệt. Tệ hơn, hệ thống có thể lên production dựa trên một cam kết mà bạn không giữ được.
Thật ra khách đang hỏi hai câu
Câu đầu tiên là dữ liệu nằm yên (at rest) ở đâu: file đã upload, lịch sử hội thoại, kết quả được lưu lại. Câu còn lại là prompt và phản hồi được xử lý ở đâu trong lúc suy luận. Hai câu có hai đáp án khác nhau, và nhà cung cấp cũng đặt chúng ở hai chỗ cấu hình khác nhau.
Anthropic tách hẳn thành hai cài đặt độc lập. Workspace geo quyết định nơi lưu dữ liệu at rest và nơi chạy các endpoint phụ trợ như chuyển mã ảnh hay thực thi code. Inference geo quyết định nơi mô hình chạy suy luận, và được đặt riêng cho từng request.
Microsoft Foundry trên Azure cũng nói rõ điều này cho mọi loại deployment. Dữ liệu at rest ở lại trong geography Azure bạn đã chọn. Còn nơi xử lý suy luận thì tùy loại deployment.
Bốn nhà cung cấp, bốn cách gọi tên
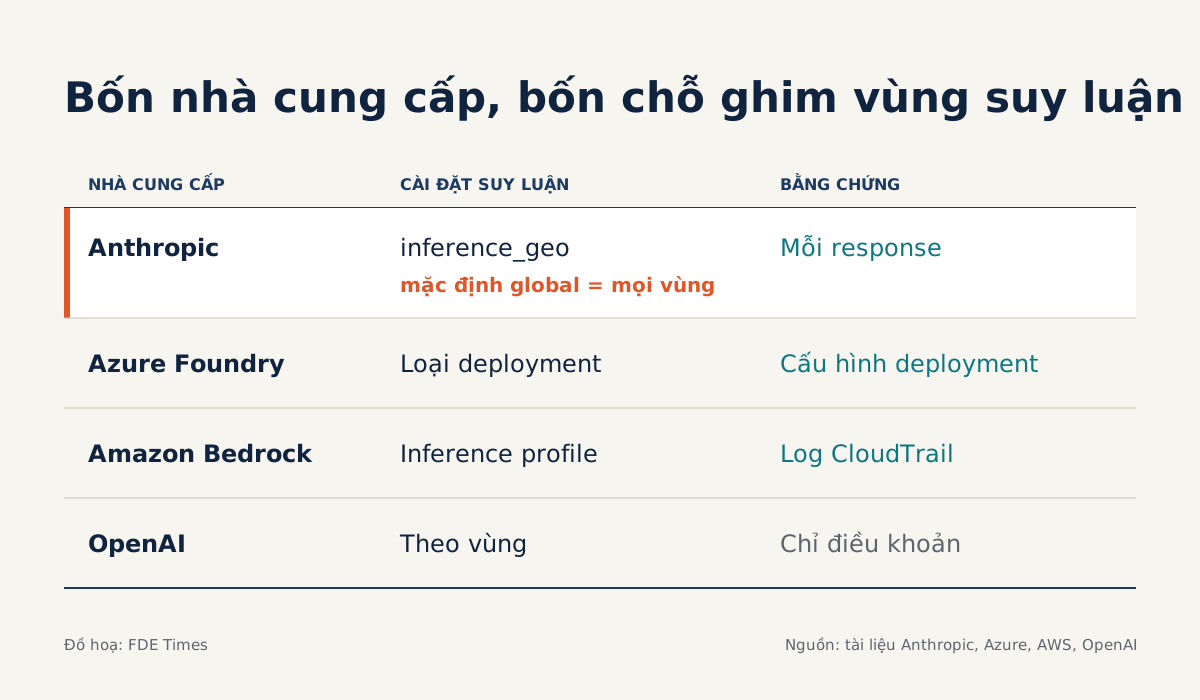
Nên bắt đầu từ Anthropic, vì giá trị mặc định ở đây cho thấy rủi ro rõ nhất. Giá trị mặc định của inference_geo là “global”, tức suy luận có thể chạy ở bất kỳ vùng nào để tối ưu hiệu năng và độ sẵn sàng. Nếu không ai chủ động đổi, câu trả lời thật cho khách là “ở đâu cũng có thể”.
| Nhà cung cấp | Lưu trữ at rest | Suy luận | Bằng chứng |
|---|---|---|---|
| Anthropic | Workspace geo, chọn lúc tạo workspace, không đổi được | inference_geo theo request: “global” hoặc “us” | usage.inference_geo trong response |
| Azure Foundry | Geography đã chọn | Global: mọi region. Data Zone: US, EU hoặc APAC. Standard: trong geography đã chọn | Loại deployment |
| Amazon Bedrock | Cần kiểm tra riêng với AWS | Cross-Region có thể rời Region nguồn. Profile geographic giữ trong một vùng địa lý | additionalEventData.inferenceRegion trong CloudTrail |
| OpenAI | Có lưu trữ theo vùng | Xử lý theo vùng ở Mỹ và châu Âu (EEA và Thụy Sĩ), vài model ở Úc, Ấn Độ, Nhật | Đọc điều khoản: system data không thuộc phạm vi |
Mỗi dòng có một chi tiết dễ bị bỏ sót. Với Azure, loại Standard và Regional Provisioned xử lý trong geography khách chọn, nhưng vẫn có thể chuyển giữa các region trong geography đó vì lý do vận hành. Nếu hợp đồng của khách ghi đích danh một region, bạn phải nói rõ điểm này trước.
Với Bedrock, AWS khuyên dùng inference profile theo địa lý khi khách có yêu cầu data residency. Profile global có thể đưa request tới bất kỳ Region thương mại nào trên thế giới. Với OpenAI, system data có thể được lưu và xử lý ngoài vùng đã chọn, và nhà cung cấp có thể tạm lưu nội dung khách hàng ngoài vùng để vận hành dịch vụ.
Làm thử một ca từ đầu đến cuối
Lấy một ví dụ giả định: khách là một công ty bảo hiểm ở Mỹ, yêu cầu dữ liệu hợp đồng không rời nước Mỹ, và bạn dùng Claude qua API của Anthropic. Việc đầu tiên diễn ra trước khi viết dòng code nào. Workspace geo phải chọn lúc tạo workspace và không đổi được sau đó, nên tạo nhầm workspace là phải làm lại từ đầu.
Ở thời điểm viết bài, tùy chọn duy nhất cho workspace geo trên trang tài liệu là “us”, nên phần lưu trữ khớp với yêu cầu. Phần suy luận thì phải ghim trong từng request, và nên ghim trong code thay vì trông vào việc ai đó nhớ bấm đúng nút trên console:
body = {
    "model": MODEL,
    "max_tokens": 1024,
    "inference_geo": "us",   # chỉ chạy suy luận trên hạ tầng ở Mỹ
    "messages": [{"role": "user", "content": prompt}],
}
resp = call_messages_api(body)

geo = resp["usage"].get("inference_geo")
audit_log.write({"request_id": resp["id"], "inference_geo": geo})
if geo != "us":
    alert("Suy luận chạy ngoài vùng cam kết")
Dòng ghi log là thứ biến lời hứa thành bằng chứng. Response có trường usage.inference_geo cho biết suy luận thực sự chạy ở đâu. Ghi trường này cạnh request id, và khi kiểm toán viên của khách hỏi, bạn có dữ liệu để đưa ra thay cho một câu trong slide.
Sau đó tính chi phí cho khách. Với các model Claude 4.6 trở lên, suy luận chỉ chạy ở Mỹ có giá bằng 1,1 lần giá chuẩn, áp cho mọi loại token: input, output, cache write và cache read. Cứ 100 đơn vị chi phí token hôm nay sẽ thành 110, và caching không giúp bạn né phần chênh lệch này.
Nếu sau này khách chuyển sang Bedrock, logic vẫn giữ nguyên, chỉ đổi chỗ cấu hình. Bạn chọn inference profile địa lý cho Mỹ thay vì profile global. Bằng chứng nằm trong CloudTrail ở Region nguồn: mọi request cross-Region đều được ghi log, kèm trường additionalEventData.inferenceRegion.
Quy trình cho dự án của bạn
Bắt đầu bằng việc viết lại yêu cầu của khách thành hai dòng riêng: dữ liệu at rest phải ở đâu, suy luận phải chạy ở đâu. Đến bước này bạn thường phát hiện khách chỉ nghĩ đến dòng đầu. Hỏi lại họ xem yêu cầu dừng ở cấp quốc gia, cấp khu vực như EU, hay đích danh một region.
Tiếp theo, đối chiếu từng dòng với cài đặt cụ thể của nhà cung cấp, ghi cả tên cài đặt lẫn giá trị. Ghim giá trị đó trong code hoặc trong hạ tầng dạng code, rồi thêm một bước kiểm tra lúc chạy, đọc trường bằng chứng như đoạn code ở trên.
Bước cuối nên là một đoạn ngắn ghi những chỗ cam kết không bao phủ hoặc cần kiểm tra riêng. Với OpenAI, đó là system data. Với deployment Standard của Azure, đó là việc chuyển giữa các region trong cùng geography vì lý do vận hành.
Với Anthropic, các endpoint phụ trợ như chuyển mã ảnh hay thực thi code đi theo workspace geo chứ không theo inference_geo, nên cần kiểm tra riêng. Đưa đoạn này cho khách trước khi họ tự tìm ra, vì nói trước bao giờ cũng dễ hơn để nó lộ ra giữa một đợt kiểm toán.
Những lỗi hay gặp
Lỗi dễ mắc nhất là trả lời bằng region của workspace rồi coi như xong, trong khi suy luận vẫn đang ở chế độ global mặc định. Một lỗi khác là nghĩ deployment Standard của Azure nghĩa là đúng một region. Thực ra nó chỉ giữ dữ liệu trong một geography.
Tốn kém hơn cả là tạo workspace trước khi chốt yêu cầu residency, trong khi workspace geo không đổi được. Cũng đừng quên báo phần giá tăng thêm cho khách, kẻo hóa đơn tháng đầu trở thành một cuộc họp không ai muốn dự.
Bài tập: một khách ở EU dùng Azure
Hãy tự điền bảng hai cột Lưu trữ / Suy luận cho một khách yêu cầu dữ liệu không rời EU và đang dùng Microsoft Foundry. Cột Lưu trữ khá dễ, vì dữ liệu at rest ở trong geography Azure đã chọn. Cột Suy luận mới là phần cần nghĩ.
Viết ra loại deployment nào bị loại ngay (Global, vì có thể xử lý ở bất kỳ region nào), loại nào giữ xử lý trong EU (Data Zone EU), và câu bạn sẽ nói nếu khách đòi đích danh một region. Nếu trả lời được cả ba ô mà không mở lại tài liệu, bạn đã sẵn sàng cho buổi review thật.
Kỹ năng này nằm ở đâu trên CV
Khi tin tuyển dụng FDE nhắc đến khách hàng trong ngành có quản lý chặt, như tài chính, y tế hay khu vực công, bạn nên chuẩn bị sẵn cho câu hỏi về residency trong phỏng vấn. Câu trả lời nên tách bạch lưu trữ với suy luận và kể được tên cài đặt của ít nhất hai nhà cung cấp.
Trên CV, một dòng như “thiết kế cấu hình residency và log kiểm toán vùng suy luận cho lời gọi LLM” có sức nặng hơn hẳn chữ “compliance” chung chung. Nó cho người tuyển biết bạn từng ngồi cùng phòng với đội bảo mật của khách và vượt qua được buổi đó.
Người đặt câu hỏi “dữ liệu xử lý ở vùng nào?” muốn biết bạn có thật sự nắm rõ hệ thống của mình hay không. Một câu trả lời có hai phần, kèm một dòng log làm bằng chứng, là cách nhanh nhất để họ tin bạn.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!