Agent đóng vai FDE hỏi khách khá giỏi, nhưng chỉ 25% lượt chạy qua nghiệm thu
Một nhóm nghiên cứu để LLM agent đi lại con đường mà một kỹ sư thật mất bốn tháng mới đi hết. Họ thấy rằng ghi lại yêu cầu của khách vẫn chưa phải là hiểu đúng yêu cầu đó.
Tóm tắt nhanh
- Mô hình mạnh nhất tìm ra hơn 80% yêu cầu bị giấu, mô hình open-weight chỉ tìm được 40–50%.
- Qua tám cấu hình coding agent, chỉ 25% lượt chạy đạt mọi tiêu chí nghiệm thu; 40% yêu cầu bị giấu bị thiếu hoặc diễn đạt sai.
- FDE-Bench của Baidu cũng thấy khoảng cách này: điểm bàn giao trung bình cao nhất chỉ 0,5510/1,0.
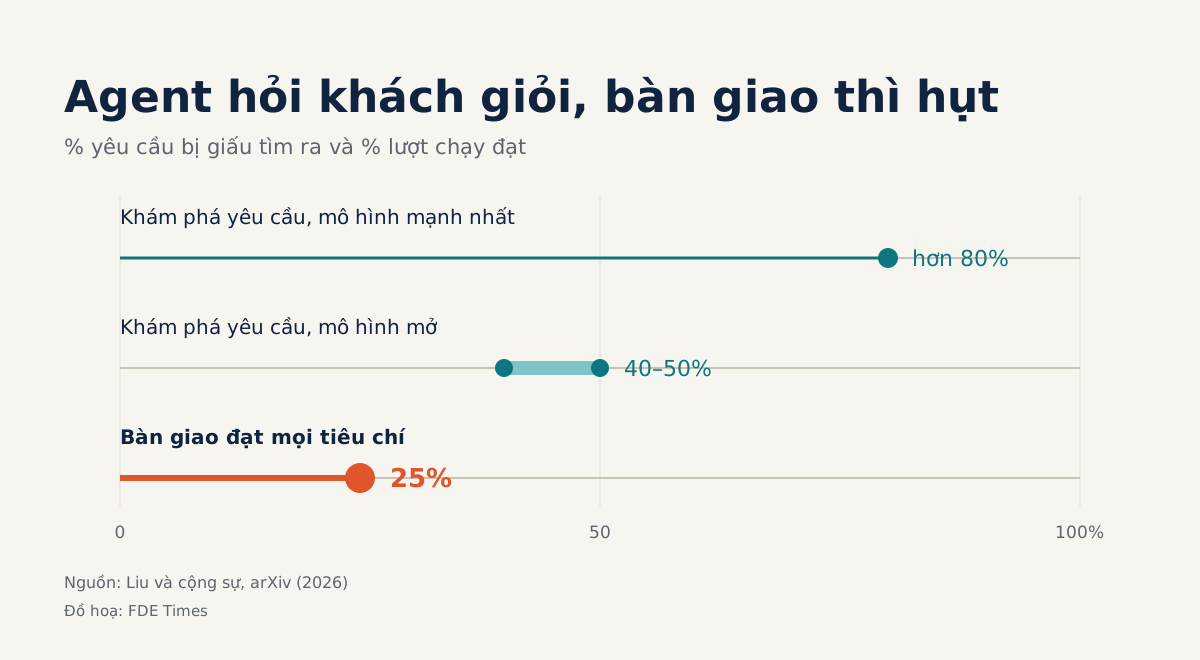
Khi được giao đi hỏi chuyện một khách hàng doanh nghiệp, LLM agent làm tốt hơn nhiều người nghĩ: mô hình mạnh nhất tìm ra hơn 80% số yêu cầu bị cố tình giấu đi. Đến lúc phải bàn giao một hệ thống chạy được, kết quả lại khác hẳn. Chỉ 25% lượt chạy qua được toàn bộ tiêu chí nghiệm thu.
Đó là hai con số trong nghiên cứu “Can LLM Agents Be Forward-Deployed Engineers?”, về khám phá yêu cầu và bàn giao hệ thống text-to-SQL cho doanh nghiệp, nộp lên arXiv ngày 2/11/2026. Marianne Menglin Liu là tác giả đầu, cùng các đồng tác giả trong đó có Dan Roth và Sujith Ravi.
Với ai đang làm FDE hoặc muốn chuyển sang vai trò này, nghiên cứu chỉ ra một điểm rất thực tế: khâu hỏi khách chưa xong chỉ vì danh sách yêu cầu đã dài. Một yêu cầu được ghi lại sai nghĩa vẫn sẽ làm hỏng bản bàn giao.
Thước đo là bốn tháng làm việc của một người
Nhóm tác giả không dựng một bài toán đồ chơi. Mốc so sánh là một ca triển khai có thật: một FDE mất bốn tháng để đưa mô hình text-to-SQL viết theo dialect Oracle vào một doanh nghiệp lớn.
Agent phải đi lại hai chặng mà người kỹ sư đó đã đi, gồm khám phá yêu cầu với khách rồi bàn giao một hệ thống qua được nghiệm thu.
Ở chặng đầu, nhóm thử 15 mô hình. Mô hình mạnh nhất vượt mốc 80%, còn các mô hình open-weight chỉ tìm ra 40–50% yêu cầu bị giấu. Nếu chỉ nhìn con số tốt nhất, dễ tưởng customer discovery, phần “con người” nhất của nghề, đã gần được tự động hóa.
Vì sao 80% không thành 80%?
Sang chặng bàn giao, bức tranh khác đi rõ rệt. Qua tám cấu hình coding agent, chỉ một phần tư số lượt chạy đạt mọi tiêu chí. Theo nhóm tác giả, nút thắt đầu tiên chính là discovery chưa đủ: 40% yêu cầu bị giấu bị bỏ sót hoặc bị diễn đạt sai.
Hai con số này không mâu thuẫn. Mốc hơn 80% là của mô hình giỏi nhất, trong khi các mô hình open-weight dừng ở 40–50%. Quan trọng hơn, chữ “diễn đạt sai” cho thấy một yêu cầu có thể được tính là đã tìm ra mà vẫn không đúng với ý khách.
Thử hình dung một ví dụ giả định. Khách nói “doanh thu theo quý”, nhưng ở công ty họ, doanh thu phải trừ hàng trả lại và quý tài chính bắt đầu từ tháng 4. Agent ghi được “doanh thu theo quý”, nhưng câu SQL nó viết ra vẫn sai ở cả hai chỗ, và chỗ hiểu sai đó đi theo đến tận bài test nghiệm thu.
Một benchmark khác cũng ra kết quả tương tự
Kết quả này không đứng một mình. FDE-Bench, do nhóm Baidu AI Cloud công bố riêng và không chung tác giả, gồm 49 ca lấy từ dự án khách hàng thật, trong đó agent phải tự khơi ra những yêu cầu ban đầu không ai nói.
Trên 18 cấu hình agent, điểm bàn giao trung bình cao nhất chỉ đạt 0,5510 trên thang 1,0. Nhóm Baidu kết luận rằng các agent được thử chưa thể bàn giao đầu-cuối ở mức FDE một cách đáng tin cậy.
Hai nghiên cứu độc lập, dùng hai bộ dữ liệu khác nhau, đều thấy agent hụt hơi ở khâu bàn giao. Vì vậy, khó coi con số 25% là chuyện riêng của một thí nghiệm.
Con người vẫn phải giữ hai việc
Lời khuyên của Liu và cộng sự khá cụ thể: con người rà soát danh sách yêu cầu agent đã tìm ra, và theo dõi kế hoạch của agent trong lúc nó thực thi. Theo cách nhìn này, FDE chuyển sang vai trò giám sát chứ chưa bị thay thế.
Với bạn, việc nên luyện từ bây giờ là đi theo một yêu cầu từ cuộc họp với khách đến tận bài test nghiệm thu, và ghi lại định nghĩa nghiệp vụ đằng sau mỗi thuật ngữ khách dùng. Đó cũng chính là chỗ con người phải rà soát mà nhóm tác giả nhắc tới.
Khi đọc job description, hãy để ý những cụm như “requirements gathering” hay “acceptance criteria” đứng cạnh “LLM agents”. Trên CV, một dự án ghi rõ bao nhiêu yêu cầu đã khám phá, bao nhiêu tiêu chí nghiệm thu và bao nhiêu tiêu chí đã đạt sẽ thuyết phục hơn mọi tính từ.
Agent đã biết đặt câu hỏi. Việc kiểm tra xem câu trả lời được hiểu đúng hay chưa vẫn là việc của kỹ sư.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
3 nguồn
- [2611.03551] Can LLM Agents Be Forward-Deployed Engineers? Requirement Discovery and Delivery for Enterprise Text-to-SQL · 2026-11-02
- Can LLM Agents Be Forward-Deployed Engineers? Requirement Discovery and Delivery for Enterprise Text-to-SQL · 2026-11-02
- FDE-Bench: Evaluating End-to-End Delivery from Underspecified Real-World Business Requests · 2026-10-20