Observability Engineering: cuốn sách giúp FDE trả lời “vì sao hệ thống chậm?” mà không phải đoán
Khi khách hàng kêu chậm, bạn cần biết hỏi dữ liệu thế nào để tìm ra nguyên nhân, và ba kỹ sư của Honeycomb đã viết hẳn một cuốn sách về chuyện đó.
Tóm tắt nhanh
- Sách do Charity Majors, Liz Fong-Jones và George Miranda viết, O'Reilly xuất bản năm 2022; ấn bản 2 được viết lại gần như toàn bộ.
- Ba ý nên giữ: structured event là nền móng, debug theo giả thuyết thay vì nhờ người kỳ cựu, và cảnh báo theo SLO.
- Với FDE, phần đáng đọc nhất là vòng phân tích cốt lõi (chương 8, 15, 16 ở ấn bản 1).
Thử hình dung khách hàng báo “hệ thống chậm quá”. Dashboard thì xanh, CPU bình thường, vậy mà người dùng cuối vẫn phải chờ. Đến lúc đó, nhiều nhóm lại đi tìm người kỹ sư lâu năm nhất, vì chỉ người đó “biết hệ thống”.
Observability Engineering: Achieving Production Excellence được viết ra để bỏ thói quen ấy. Ba tác giả Charity Majors, Liz Fong-Jones và George Miranda đều đến từ Honeycomb; O’Reilly Media phát hành ấn bản đầu ngày 6/5/2022. Nếu việc của bạn là bước vào một hệ thống lạ và tìm ra lý do nó chậm trong vài ngày, đây là cuốn nên đọc.
Sách nói gì, và nên đọc ấn bản nào?
Goodreads giới thiệu ngắn gọn rằng observability là điều kiện để xây dựng, vận hành và cải thiện những hệ thống phức tạp, trọng yếu với hoạt động kinh doanh. Theo loạt tóm tắt của chính các tác giả, các nhóm chương xoay quanh structured event, vòng phân tích để debug, cảnh báo theo SLO và cách cả nhóm làm việc.
Cần biết một điều trước khi mua: Honeycomb đã công bố ấn bản 2, được viết lại gần như toàn bộ và dài gấp đôi, với 27 chương hoàn toàn mới.
Ấn bản này có thêm một phần về quản trị observability cho người ra quyết định kỹ thuật, và danh sách tác giả cũng đổi, có thêm Austin Parker, đồng sáng lập OpenTelemetry. Ngày phát hành ấn bản 2 không đi kèm thông báo ấy, nên hãy kiểm tra ấn bản nào đang được bán trước khi đặt mua.
Số chương nhắc đến dưới đây là của ấn bản 1, vì loạt bài tóm tắt của chính các tác giả dựa trên ấn bản đó. Nếu bạn mua ấn bản 2, cách đánh số sẽ khác.
Nếu chưa muốn mua ngay, bạn có một lối tắt. Loạt bài “Authors’ Cut” trên blog Honeycomb lấy các khái niệm chính của từng nhóm chương và viết lại cho dễ đọc. Các bài không xếp theo thứ tự chương, nên bạn có thể chọn đúng phần mình cần.
Ý thứ nhất: mỗi request phải tự kể chuyện của nó
Nền móng của cả cuốn sách là structured event. Trong một buổi chia sẻ về sách, Honeycomb mô tả việc nối các event có cấu trúc lại với nhau để lần theo một request đi qua distributed trace, nhờ đó thấy được các thành phần phụ thuộc vào nhau thế nào.
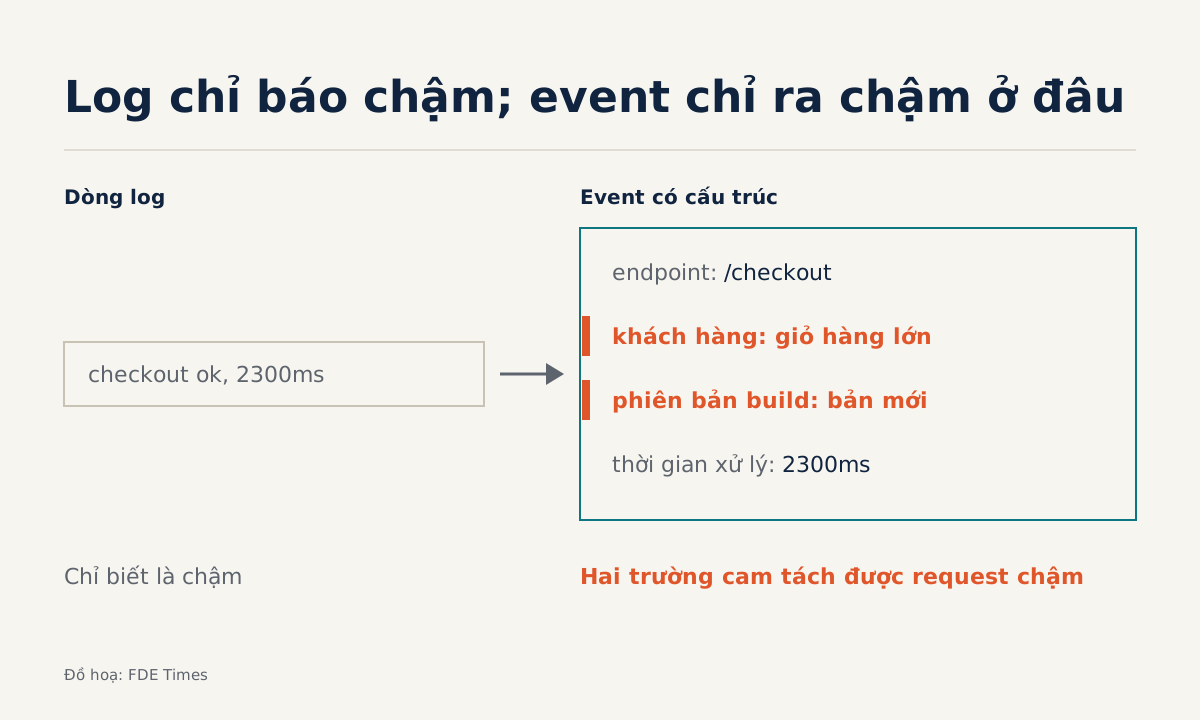
Thử hình dung luồng checkout của một khách hàng bán lẻ. Mỗi request phát ra một event mang theo endpoint, mã khách hàng, vùng, phiên bản build, tên cơ sở dữ liệu được gọi và thời gian xử lý. Một dòng log kiểu “checkout ok, 2300ms” chỉ cho bạn biết là nó chậm. Một event đủ trường cho bạn biết nó chậm ở đâu và cho ai.
Lỗi dễ mắc nhất ở bước này là instrument quá ít trường. Nếu event checkout thiếu phiên bản build hay mã khách hàng, sau này bạn không thể tách nhóm request chậm theo hai chiều đó, dù dữ liệu có nhiều đến đâu. Lỗi thứ hai là chỉ ghi lỗi mà bỏ qua request thành công, trong khi request “thành công nhưng chậm” mới là thứ khách hàng đang kêu.
Vì thế, việc đầu tiên nên làm ở chỗ khách hàng là đọc lại log của một request chậm và tự hỏi: dữ liệu này có đủ để tách request chậm khỏi request bình thường không? Nếu không đủ, hãy sửa instrument trước rồi mới tính chuyện tối ưu.
Ý thứ hai: debug bằng giả thuyết chứ không bằng trí nhớ
Các chương 8, 15 và 16 nói về vòng phân tích cốt lõi (core analysis loop) và chuyện nên tự xây hay mua công cụ. Với câu hỏi “vì sao chậm?”, đây là phần đáng đọc nhất. Các tác giả mô tả vòng phân tích này là một công cụ mạnh và dễ tiếp cận với nhiều người.
Áp vào ví dụ checkout, cách làm sẽ như sau. Bạn tách nhóm request chậm, đặt nó cạnh nhóm request bình thường, rồi tìm xem trường nào khác nhau rõ rệt.
Có thể toàn bộ request chậm đều chạy trên một phiên bản build mới, hoặc đều đến từ một khách hàng có giỏ hàng rất lớn. Giả thuyết lúc này đến từ dữ liệu, và bạn kiểm chứng được nó bằng một truy vấn tiếp theo, thay vì dựa vào trí nhớ của ai đó về lần sự cố trước.
Một kỹ sư của Classmethod ở Nhật, khi đánh giá sách, cho rằng lợi ích lớn nhất là nhóm có thể debug mà không phải dựa vào những kỹ sư được ví như “cuốn từ điển sống”.
Người đánh giá này cũng nói rõ cuốn sách không phủ nhận monitoring truyền thống. Nó là cách tiếp cận mới cho lúc độ phức tạp và quy mô của hệ thống bắt đầu vượt quá những gì monitoring làm được.
Ý thứ ba: cảnh báo theo điều khách hàng thực sự quan tâm
Các chương 12 và 13 nói về cảnh báo dựa trên SLO. Bản tóm tắt của các tác giả viết rằng cách này giúp nhóm phản ứng với điều quan trọng nhất đối với khách hàng và doanh nghiệp. Với FDE, ý này rất thực tế: thứ khách hàng quan tâm là đơn hàng có đi qua được hay không, chứ không phải CPU đang ở mức 80%.
Đó cũng là lỗi phổ biến thứ ba khi bàn giao: đặt cảnh báo theo CPU hay bộ nhớ. Ở ví dụ checkout, CPU có thể vẫn thấp trong khi request chờ một truy vấn cơ sở dữ liệu chậm, nên người trực không nhận được cảnh báo nào dù khách hàng đã thấy chậm.
Sách cũng nhắc rằng triển khai observability không chỉ là chuyện instrument ứng dụng mà còn là cách cả nhóm làm việc với nhau. Vậy khi bàn giao, bạn để lại cho khách hàng cả một thói quen: SLO được viết ra, cảnh báo gắn vào SLO, và ai trực cũng biết cách hỏi dữ liệu.
Ai nên đọc, và đọc theo thứ tự nào?
Nếu bạn là FDE hoặc kỹ sư backend muốn chuyển sang làm FDE, hãy đọc phần structured event và trace trước, sau đó đến vòng phân tích cốt lõi, rồi mới tới SLO. Phần về quản trị trong ấn bản 2 hợp hơn với người đang phải thuyết phục ban lãnh đạo phía khách hàng đầu tư vào công cụ.
Về nghề nghiệp, nếu JD bạn nhắm tới nhắc OpenTelemetry, distributed tracing hay SLO, thì các chương trên chính là phần nên ôn trước.
Trong CV, thay vì chỉ ghi “dùng Grafana”, hãy thử kể một lần bạn instrument một luồng bằng structured event, tách nhóm request chậm và tìm ra nguyên nhân: một câu chuyện cụ thể cho thấy cách bạn suy luận rõ hơn một danh sách công cụ.
Lần tới khách hàng nói “chậm quá”, bạn không cần là người hiểu hệ thống lâu nhất trong phòng, mà là người biết đặt câu hỏi gì cho dữ liệu.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
7 nguồn
- Observability Engineering: Achieving Production Excellence (Goodreads) · 2022-05-06
- Observability Engineering (Bookshare) · 2022
- Honeycomb’s O’Reilly Book Observability Engineering, 2nd Ed.
- Honeycomb’s O’Reilly Book Observability Engineering, 2nd Ed.
- Authors' Cut Spark Notes Edition: Jumpstart Your Observability Journey · 2023-01-12
- Structured Events Are The Basis of Observability | Honeycomb
- 【書評】オブザーバビリティ・エンジニアリング | DevelopersIO · 2023-02-25