Building LLMs for Production: FDE nên đọc chương nào, theo thứ tự nào
Một FDE sắp ra hiện trường không cần đọc hết hơn bốn trăm trang, nhưng nên đọc phần chuẩn bị dữ liệu trước khi nghĩ đến fine-tuning.

Tóm tắt nhanh
- Sách hợp với người biết Python, không cần nền AI hay NLP; ấn bản 2 đổi tên thành Building AI for Production.
- FDE nên ưu tiên RAG, chương index và retriever, Advanced RAG, Deployment; Agents và Fine-Tuning để sau.
- Giá trị lớn nhất nằm ở việc tự dựng và đo một pipeline, không phải ở việc đọc hết sách.
Bổ sung lớn trong bản cập nhật tháng 10/2024 của một cuốn sách về LLM dày khoảng 470 trang lại là chuyện dữ liệu: một chương hoàn toàn mới về index, retriever và chuẩn bị dữ liệu.
Chi tiết ấy gợi ý luôn cách đọc Building LLMs for Production, cuốn sách do Towards AI phát hành, với Louis-François Bouchard là đồng tác giả. Nếu bạn là FDE, hãy xem kỹ tài liệu của khách hàng trước khi bàn đến chọn mô hình, vì RAG chỉ trả lời đúng khi tìm được đúng đoạn văn.
Vì thế câu hỏi đáng đặt không phải là sách có hay không, mà là đọc gì trước khi ra hiện trường. Câu trả lời ngắn: sáu phần, đọc theo một thứ tự khác với mục lục.
Mua đúng cuốn trước đã
Sách đang mang hai tên. Ấn bản đầu là Building LLMs for Production, phụ đề nêu prompting, fine-tuning và RAG. Ấn bản 2 trên trang của Towards AI đổi thành Building AI for Production, gồm 12 chương, và phụ đề chỉ còn fine-tuning và RAG.
Nếu đang giữ bản cũ, bạn chưa cần mua lại chỉ vì Agents hay Fine-Tuning. Bảng so sánh của Towards AI cho biết hai chương này chủ yếu được chỉnh cấu trúc, còn Deployment được đào sâu hơn; đó mới là lý do để nâng cấp, cùng với chương dữ liệu mới nếu bản của bạn chưa có.
Yêu cầu đầu vào rất thấp: Towards AI viết sách cho người chưa biết gì về AI hay NLP, và Bouchard chỉ đòi hỏi một ít Python. Nếu đã làm backend vài năm, bạn có thể lướt phần nền tảng LLM và NLP, đọc kỹ khi gặp thuật ngữ lạ.
Jerry Liu, đồng sáng lập kiêm CEO LlamaIndex, gọi đây là giáo trình toàn diện nhất về ứng dụng LLM vào thời điểm ông nhận xét, nhưng toàn diện cũng là lý do bạn không nên đọc tuần tự.
Thứ tự đọc gắn với tiến độ deployment
Số chương dưới đây theo ấn bản 2. Thứ tự và cột bên phải là lời khuyên dành cho FDE, không lấy từ sách.
Riêng chương index và retriever không có số vì tên chương đến từ bản cập nhật tháng 10/2024 và chưa đối chiếu được với số chương ở ấn bản 2. Hãy tìm theo chủ đề trong mục lục của cuốn bạn đang có.
| Thứ tự | Phần đọc | Việc tại khách hàng |
|---|---|---|
| 1 | Chương V: RAG | Trước khi đến: nắm các mắt xích, dựng thử trên tài liệu công khai |
| 2 | Index, retriever, chuẩn bị dữ liệu | Buổi đầu: xin 50 câu hỏi thật, xử lý tài liệu lộn xộn, đo tìm kiếm |
| 3 | Chương IX: Advanced RAG | Sửa đúng lỗi đã đo được |
| 4 | Chương XII: Deployment | Chốt nơi chạy mô hình, độ trễ, chi phí |
| 5 | Chương X: Agents | Mở rộng khi phần tìm kiếm đã đáng tin |
| 6 | Chương XI: Fine-Tuning | Cân nhắc khi các bước trên chưa đủ |
Fine-Tuning đứng cuối là quan điểm, không phải quy tắc của sách. Nó tốn dữ liệu đã gán nhãn và công bảo trì, trong khi lỗi ở giai đoạn đầu của một dự án RAG thường có thể sửa rẻ hơn ở phía dữ liệu. Agents đứng trước nó vì nhiều khách hàng sẽ hỏi đến agent sớm, nhưng một agent dựa trên retriever kém chỉ sai nhanh hơn.
Dựng tay pipeline RAG một lần trước khi dùng framework
Bản cập nhật có hướng dẫn từng bước dựng pipeline RAG cơ bản từ đầu, và sách đi kèm các notebook Colab chạy được ngay cùng dự án code. Đừng chỉ đọc lướt phần này. Khi demo của bạn trả lời sai trước mặt khách hàng, bạn cần biết lỗi nằm ở bước nào, và người từng ghép tay từng mắt xích tìm ra nhanh hơn nhiều.
Một lưu ý thực tế: ebook trên trang của Towards AI ở dạng tương tác, không phải PDF tải về. Đừng tính chuyện lưu sẵn một file để đọc trên đường đến khách hàng.
Đo retriever trước khi trách mô hình
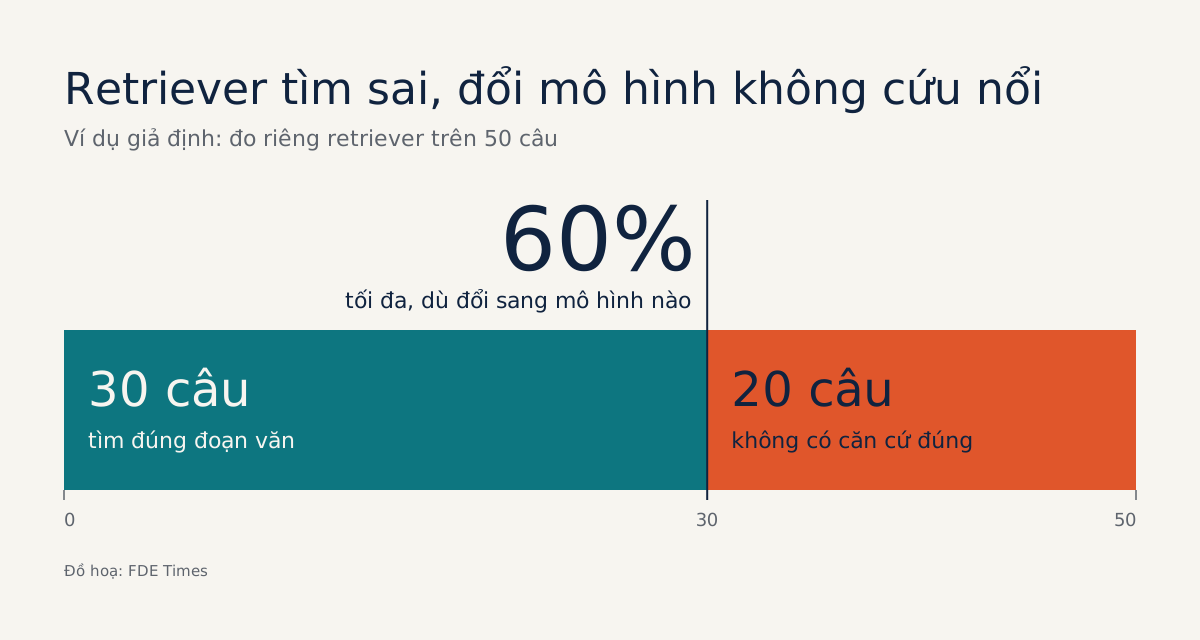
Đây là lý do chương index và retriever xếp thứ hai. Thử hình dung một công ty bảo hiểm đưa bạn kho hợp đồng PDF và muốn chatbot trả lời nhân viên. Bạn viết 50 câu hỏi thật cùng nhân viên, mỗi câu kèm đoạn văn chứa đáp án, rồi chạy riêng retriever.
Giả sử retriever chỉ tìm đúng đoạn văn cho 30 câu. 20 câu còn lại không có căn cứ đúng để trả lời, nên dù đổi sang mô hình nào, cũng chỉ tối đa 30/50 câu, tức 60%, được trả lời dựa trên đúng tài liệu.
Có con số này, cuộc họp không còn xoay quanh chuyện mô hình có vẻ chưa thông minh. Mọi người sẽ bàn cách cắt và lập chỉ mục lại tài liệu.
Việc nên làm đầu tiên tại khách hàng vì thế không phải là chọn mô hình. Hãy xin 50 câu hỏi thật và người trả lời được chúng, trước khi viết dòng code RAG đầu tiên trên dữ liệu của họ. Chỉ khi biết 20 câu kia hỏng vì sao, chương Advanced RAG mới thành danh sách thuốc cho đúng bệnh.
Tính độ trễ trước khi hứa với khách hàng
Phần triển khai được mở rộng với distillation, kỹ thuật giảm chi phí suy luận và độ trễ, kèm case study Gemma 2 của Google. Sách cũng bàn về triển khai LLM trên Together AI, Groq, Fireworks AI và Replicate. Danh sách nền tảng nào cũng cũ đi nhanh, nên hãy học cách so sánh hơn là học thuộc tên.
Phép tính nên làm rất đơn giản. Giả sử khách hàng cần câu trả lời trong 1,5 giây, retriever mất 300 mili giây và mô hình mất 2 giây: tổng là 2,3 giây, chậm hơn yêu cầu 800 mili giây.
Lúc đó bạn có thể đổi nơi chạy mô hình, dùng mô hình nhỏ hơn, hoặc cân nhắc distillation nếu lưu lượng đủ lớn để đáng công. Đừng nhận mốc thời gian phản hồi với khách hàng trước khi đo những con số này trên hạ tầng thật.
Biến sách thành bằng chứng khi đi xin việc
Đọc xong một cuốn sách chưa chứng minh được điều gì với người tuyển dụng. Nếu một mô tả công việc FDE nhắc đến RAG trên dữ liệu khách hàng, hãy ôn lại chương V và IX; nếu nó nhắc đến production deployment hay tối ưu độ trễ, hãy ôn lại chương XII.
Trong CV, một dự án nhỏ có số đo mạnh hơn một dòng ghi đã đọc sách: tài liệu lộn xộn nào, retriever tìm đúng bao nhiêu trên bao nhiêu câu trước và sau khi sửa, độ trễ thực đo là bao nhiêu.
Trong phỏng vấn, hãy sẵn sàng giải thích vì sao bạn chưa fine-tune. Câu trả lời ấy cho thấy bạn biết khi nào một kỹ thuật chưa đáng làm.
Sách dày khoảng 470 trang, nhưng buổi đầu tại khách hàng có thể chỉ bắt đầu bằng một thư mục PDF và 50 câu hỏi. Ai chuẩn bị cho buổi đó sẽ đọc phần còn lại với câu hỏi rõ ràng hơn nhiều.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!