Khoá function calling 59 phút của DeepLearning.AI và Nexusflow: FDE nên giữ gì, bỏ gì
Bài project cuối khoá biến transcript chăm sóc khách hàng thành câu lệnh SQL rồi ghi vào database, và đó là phần gần nhất với việc dựng pipeline dữ liệu của một FDE.

Tóm tắt nhanh
- Khoá ngắn hợp tác với Nexusflow, khoảng 59 phút video, trình độ Beginner, học miễn phí trong giai đoạn beta
- Phần đáng giá nhất là bài project: transcript chăm sóc khách hàng, sinh SQL, lưu vào database
- Phần extraction chỉ có 7 phút, lại dùng một model mã nguồn mở riêng, nên bạn phải tự chuyển sang API mà khách hàng thật đang dùng
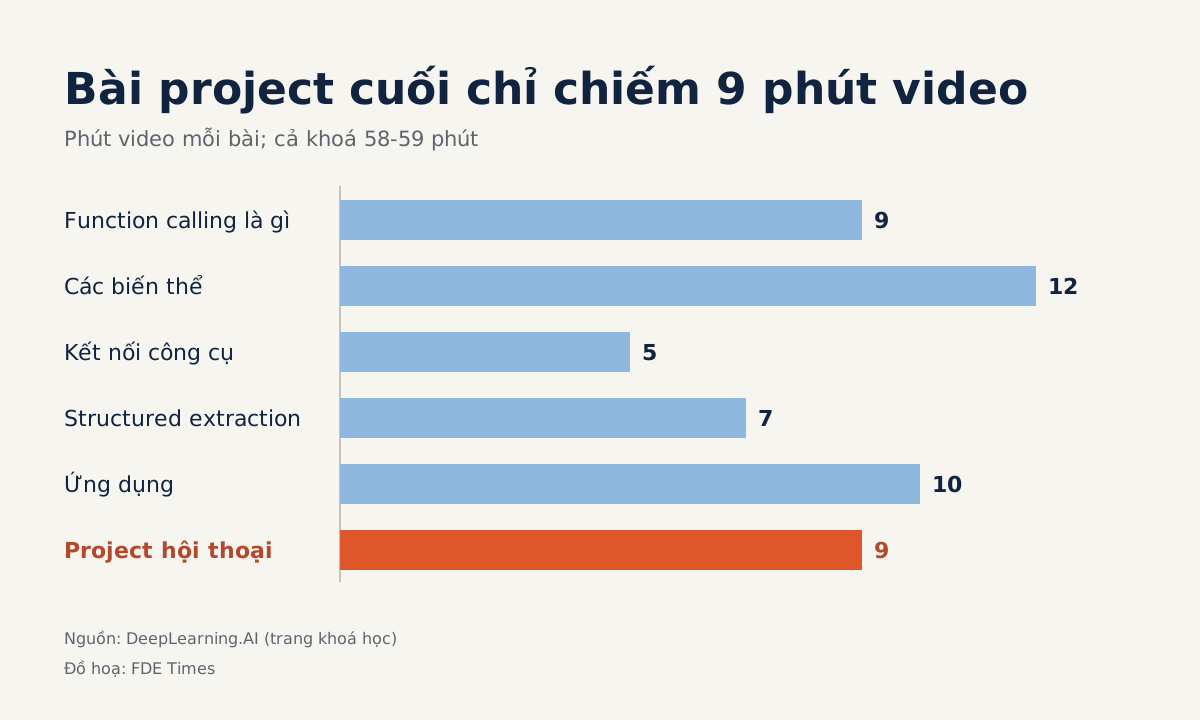
Bài cuối của khoá học này chỉ dài 9 phút, nhưng là phần gần nhất với công việc pipeline dữ liệu của FDE: lấy một đống transcript chăm sóc khách hàng, để LLM sinh lời gọi SQL, rồi ghi kết quả vào database. Đích đến của khoá là một bảng dữ liệu, không phải một chatbot.
Đó là lý do “Function-calling and data extraction with LLMs” của DeepLearning.AI đáng một buổi tối của bạn. Nhưng nó cũng có những chỗ hổng mà nếu không biết trước, bạn sẽ mang nhầm thói quen ra chỗ khách hàng.
Ai làm khoá này, và dạy những gì?
Đây là một short course DeepLearning.AI làm cùng Nexusflow, ra mắt năm 2024. Người dạy là Jiantao Jiao, đồng sáng lập kiêm CEO Nexusflow và trợ lý giáo sư EECS và Thống kê tại UC Berkeley, cùng Venkat Srinivasan, kỹ sư sáng lập của Nexusflow. Trang khoá được cập nhật lần cuối ngày 27/8/2026.
Trang khoá nói thẳng mục tiêu là hai kỹ năng: function calling và trích xuất dữ liệu có cấu trúc từ văn bản tự do. Các video cộng lại khoảng 58-59 phút. Con số 1 giờ 19 phút trên trang hiện tại đã cộng thêm 10 phút bài đọc và 10 phút quiz có chấm điểm.
Các bài chính gồm: function calling là gì (9 phút), các biến thể function calling (12 phút), kết nối công cụ bên ngoài (5 phút), structured extraction (7 phút), ứng dụng (10 phút) và project xử lý hội thoại (9 phút).
Khoá ở mức Beginner, cần biết sơ về LLM và Python cơ bản. Hiện học miễn phí trong giai đoạn beta của nền tảng, còn bài chấm điểm và chứng chỉ thì cần gói PRO.
Ý thứ nhất: model chỉ viết lời gọi, bạn mới là người chạy nó
Khi học phần function calling, cách hiểu đáng mang theo nhất là: model chỉ đọc mô tả các hàm bạn khai báo rồi trả về tên hàm và tham số. Gọi hay không, gọi thế nào, kiểm tra tham số ra sao, là việc của code bạn viết.
Với FDE, đây là ranh giới an toàn quan trọng nhất. Khi khách hàng hỏi “agent có tự xoá dữ liệu được không”, câu trả lời đúng nằm ở lớp thực thi bạn dựng, chứ không ở prompt.
Ngoài lời gọi đơn lẻ, khoá còn đi qua gọi song song và gọi lồng nhau. Nên xem kỹ phần này, vì yêu cầu thật hiếm khi chỉ cần một lời gọi.
Ý thứ hai: extraction là function calling đội lốt
Bài structured extraction chỉ có 7 phút, nên đừng mong nó đi sâu. Dù vậy, có một cách nghĩ đáng giữ lại: muốn rút dữ liệu từ văn bản, bạn khai báo một “hàm” có các tham số chính là những trường bạn cần, rồi để model “gọi” hàm đó.
Thử hình dung một transcript: khách gọi phàn nàn đơn hàng giao trễ ba ngày và đòi hoàn tiền. Bạn khai báo một hàm log_ticket với các tham số mã đơn, loại vấn đề, mức độ bực bội, có yêu cầu hoàn tiền hay không.
Model trả về lời gọi với các giá trị đã điền, code của bạn kiểm tra kiểu dữ liệu rồi chuyển thành câu INSERT. Đó chính là xương sống bài project của khoá.
Bước bạn nên tự thêm vào là đo xem trích xuất đúng tới đâu. Giả sử bạn chạy 200 transcript và tự kiểm 50 cái: nếu trường “có hoàn tiền” sai 6 lần, độ chính xác của trường đó là 88%. Con số ấy mới là thứ khách hàng cần thấy trước khi cho dữ liệu chảy vào hệ thống của họ.
Ý thứ ba: OpenAPI spec là cầu nối tới hệ thống của khách
Khoá có phần dùng OpenAPI specification để dựng lời gọi tới web service. Ở chỗ khách hàng, đây là lối tắt rất thực dụng. Hệ thống nội bộ của họ nhiều khi đã có sẵn spec, và bạn có thể sinh danh sách hàm từ đó thay vì viết tay từng cái.
Lời khuyên khi áp dụng: đừng đưa toàn bộ spec cho model. Hãy chọn vài endpoint mà quy trình thật sự cần, viết lại phần mô tả cho rõ nghĩa, và chặn các endpoint ghi hay xoá ở lớp thực thi.
Nên bỏ qua gì?
Phần thực hành dùng NexusRavenV2-13B, một model mã nguồn mở fine-tune từ CodeLlama-13B, chạy được trên máy của bạn. Trang Hugging Face của model nói nó vượt GPT-4 7% về tỉ lệ gọi hàm thành công với các lời gọi lồng nhau và kết hợp.
Đó là benchmark do chính nhà cung cấp tự công bố, trên một loại lời gọi cụ thể, nên đừng mang con số này đi thuyết phục khách hàng.
Vì thế, hãy học khái niệm nhưng đừng học thuộc cú pháp prompt riêng của model này. Khi làm thật, bạn sẽ phải chuyển mọi thứ sang tool use theo kiểu OpenAI hay Anthropic. Bài tập đáng làm nhất là viết lại project bằng chính API mà khách hàng của bạn đang dùng.
Ai nên học, và học theo thứ tự nào?
Khoá hợp với kỹ sư đã gọi API LLM vài lần nhưng chưa từng nối model với hệ thống thật. Nếu bạn đã làm production với tool use rồi, chỉ nên xem bài project và phần OpenAPI.
Thứ tự nên theo: xem bài “What is function calling” để nắm khái niệm, rồi tới “variations”, rồi nhảy thẳng sang project. Sau đó quay lại bài extraction và bài kết nối công cụ. Chứng chỉ không cần thiết. Nhà tuyển dụng FDE sẽ tin một repo hơn.
Trong CV, đừng ghi “hoàn thành khoá function calling”. Hãy ghi bạn đã dựng pipeline từ transcript vào database, trích xuất bao nhiêu trường, đạt độ chính xác bao nhiêu trên tập tự gán nhãn. Khi đọc job description có nhắc tới agent hay tích hợp LLM, đây đúng là loại bằng chứng người phỏng vấn muốn hỏi sâu.
Khoá học cho bạn khoảng một giờ khái niệm. Phần còn lại, đo độ chính xác và chặn những lời gọi nguy hiểm, là việc bạn phải tự làm, và nhà tuyển dụng sẽ trả tiền cho đúng phần đó.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
5 nguồn
- Function-calling and data extraction with LLMs - DeepLearning.AI · 2026-08-27
- New course with Nexusflow: Function-calling and Data Extraction with LLMs · 2024
- function-calling-and-data-extraction-with-llms (course companion repo)
- Function-calling and data extraction with LLMs - DeepLearning.AI · 2026-08-27
- Nexusflow/NexusRaven-V2-13B · Hugging Face