Khoá Evaluating Generative AI dài 47 phút, phần LLM chỉ có 14 phút
Phần còn lại vẫn đáng xem, vì thói quen ghi log và version dữ liệu dùng được ở mọi stack.
Tóm tắt nhanh
- Khoá có khoảng 47 phút video, ra mắt tháng 8/2023, nhưng chỉ một bài 14 phút nói thẳng về đánh giá và tracing LLM.
- Nó là khoá MLOps tooling xây trên W&B, dành cho người đã quen Python và PyTorch, và dừng ở giai đoạn phát triển.
- Thứ đáng mang về là thói quen ghi config, version dữ liệu và trace prompt, chứ không phải giao diện W&B.
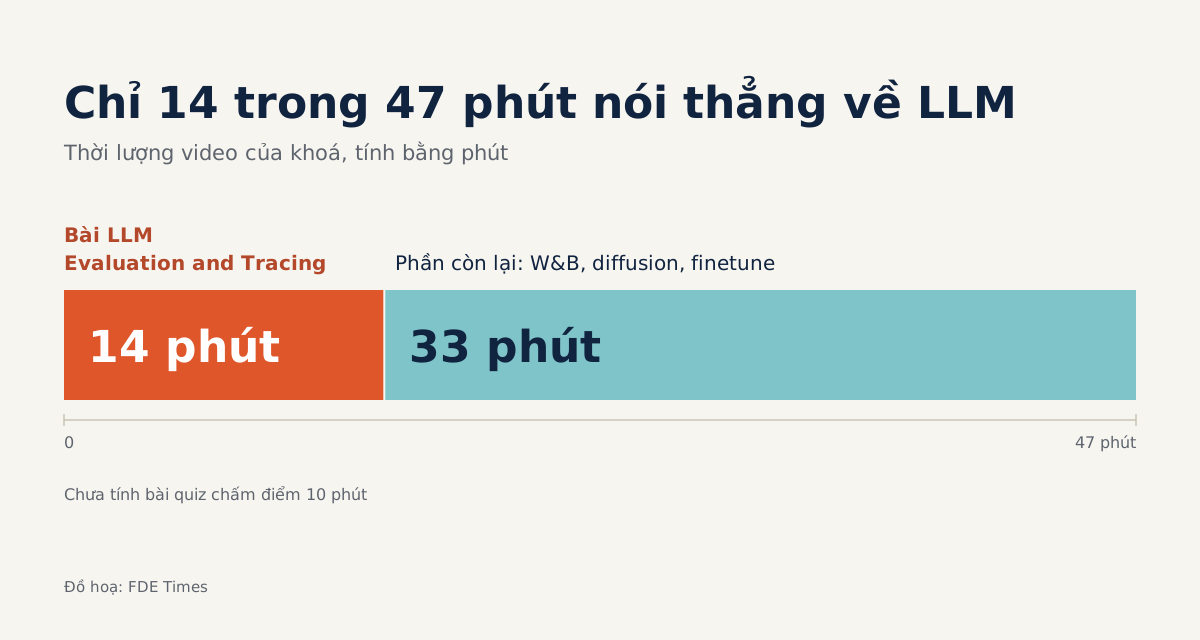
Khoá Evaluating and Debugging Generative AI có khoảng 47 phút video, cộng thêm một bài quiz chấm điểm 10 phút. Phần nói thẳng về đánh giá và tracing LLM gói trọn trong một bài dài 14 phút.
Con số đó không có nghĩa khoá học dở. Nó chỉ cho thấy đây là một khoá MLOps tooling, xây trên nền Weights & Biases. DeepLearning.AI công bố ra mắt khoá vào tháng 8/2023. Nếu bạn là FDE đang phải chứng minh một agent chạy đúng với dữ liệu thật, việc cần làm là chọn đúng bài để xem và mang về đúng thói quen.
Một khoá về công cụ, do người làm công cụ dạy
Người giảng là Carey Phelps, founding product manager của Weights & Biases. Thông báo ra mắt nói rõ người học sẽ dùng nền tảng W&B để theo dõi thí nghiệm, và W&B yêu cầu bạn có tài khoản W&B cùng kiến thức Python, PyTorch hoặc một framework tương tự. Khoá xếp ở mức intermediate.
Trang chính thức thì hứa dạy cách đánh giá chương trình dùng LLM và mô hình sinh ảnh bằng “công cụ không phụ thuộc nền tảng”.
Hai lời mô tả này hơi lệch nhau, và cách đọc hợp lý là: công cụ ở đây là W&B, còn thứ không phụ thuộc nền tảng là phương pháp.
Khoá hiện miễn phí trong thời gian nền tảng học của DeepLearning.AI chạy beta, và điều kiện này có thể thay đổi.
33 phút còn lại dành cho ai?
Bảy bài video xoay quanh bốn mảng: gắn W&B vào code, huấn luyện và đánh giá một mô hình diffusion, đánh giá và tracing LLM, rồi finetune một mô hình ngôn ngữ. Khoá tự giới hạn phạm vi ở việc theo dõi và debug mô hình “trong quá trình phát triển”.
Chi tiết cuối cùng mới là chỗ FDE cần để ý. Phần lớn rắc rối của bạn xảy ra sau giai đoạn đó, khi agent đã chạm vào dữ liệu thật của khách hàng. Khoá học cho bạn đồ nghề để ghi lại mọi thứ, còn việc chọn ghi gì ở production thì bạn phải tự làm.
Vì vậy, nên xem theo thứ tự sau. Bắt đầu với bài gắn W&B để hiểu cách ghi log, rồi sang ngay bài LLM Evaluation and Tracing. Bài finetune chỉ cần xem khi khách hàng thực sự muốn tự tinh chỉnh mô hình. Bài diffusion bạn có thể bỏ, trừ khi dự án của bạn sinh ảnh.
Ba ý đáng mang ra khỏi khoá
Bài viết tổng hợp của MLOps Community rút ra ba thói quen, và cả ba đều dùng được dù bạn có đụng đến W&B hay không. Thói quen đầu tiên là quản lý config: mỗi lần chạy đều ghi lại đầy đủ tham số đã dùng, để không bao giờ phải đoán “lần đó mình chạy với cài đặt gì”.
Thói quen thứ hai là version dataset và model dưới dạng artifact. Bộ eval cũng là dữ liệu. Nếu bạn thêm 20 case khó vào bộ test mà không đánh phiên bản, điểm số tuần này và tuần trước sẽ không còn so được với nhau.
Thói quen thứ ba là trace prompt và response theo thời gian, nhất là trong những chuỗi tương tác phức tạp. Ở bài LLM, giảng viên nhắc rằng đầu ra của mô hình tạo sinh khó đánh giá hơn. Chính vì khó chấm bằng một con số, bạn càng cần giữ lại nguyên văn từng lượt để còn đọc lại và so sánh.
Ba thói quen đó cứu bạn thế nào ở chỗ khách hàng
Thử hình dung một khách hàng bảo hiểm dùng agent tóm tắt hồ sơ bồi thường. Thứ Hai bạn sửa system prompt và thêm một bước gọi tool. Đến thứ Năm, team của khách báo rằng bản tóm tắt “tệ hơn trước”.
Nếu không có trace, cuộc họp hôm đó chỉ còn là tranh luận bằng cảm giác. Nếu có, bạn biết chính xác mỗi output đến từ phiên bản prompt nào và bộ eval nào. Khi đó bạn chạy lại cả hai phiên bản trên cùng 50 hồ sơ mẫu, đặt kết quả cạnh nhau, và chỉ ra bước gọi tool mới làm mất chi tiết ở trường hợp nào.
Kết quả là bạn trả lời khách hàng bằng ví dụ cụ thể chứ không phải bằng lời hứa. Đó là lý do bài 14 phút kia đáng xem lại hai lần: không phải để thuộc giao diện W&B, mà để hình thành phản xạ ghi lại mọi lần chạy trước khi có ai phàn nàn.
Đưa lên CV như thế nào
Khi đọc tin tuyển dụng FDE, hãy để ý những chữ như evals, tracing hay observability. Nếu chúng xuất hiện, đó là chỗ bạn nên đưa ba thói quen trên ra làm bằng chứng.
Đừng ghi “hoàn thành khoá Evaluating and Debugging Generative AI” rồi dừng ở đó.
Hãy tự dựng lại ba thói quen trên một ứng dụng LLM nhỏ bằng stack bạn chọn, rồi viết một dòng kiểu: “Thêm tracing và bộ eval có version cho chatbot nội bộ, phát hiện regression sau một lần sửa prompt.” Nhà tuyển dụng nhìn vào đó sẽ thấy đúng kỹ năng mà khoá học muốn dạy.
Xem 47 phút thì dễ. Thứ phân biệt FDE giỏi là lần đầu tiên khách hàng nói “tệ hơn trước”, họ đã có sẵn bản ghi để mở ra xem.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
6 nguồn
- Evaluating and Debugging Generative AI (DeepLearning.AI)
- Evaluating and Debugging Generative AI – DeepLearning.AI · 2026-05-14
- SHORT COURSE IS LIVE! Evaluating and Debugging Generative AI · 2023-08-02
- Announcing our Brand New Generative AI Course with Andrew Ng and DeepLearning AI (Weights & Biases) · 2023-08-02
- Evaluating and Debugging Generative AI (MLOps Community) · 2023-08-11
- LLM Evaluation and Tracing with W&B (DeepLearning.AI lesson 5)