Forward Deployed Infrastructure Engineer: nhánh FDE dành cho kỹ sư hạ tầng
Palantir và ít nhất một công ty khác đang tuyển một kiểu FDE khác hẳn hình mẫu quen thuộc: người phải giữ cho phần mềm chạy ổn định trong những môi trường mà nhà cung cấp không nhìn vào được.

Tóm tắt nhanh
- Palantir có hẳn chức danh Forward Deployed Infrastructure Engineer, tuyển cả new grad, với nhiệm vụ gồm deploy, migration và on-call ở chỗ khách hàng.
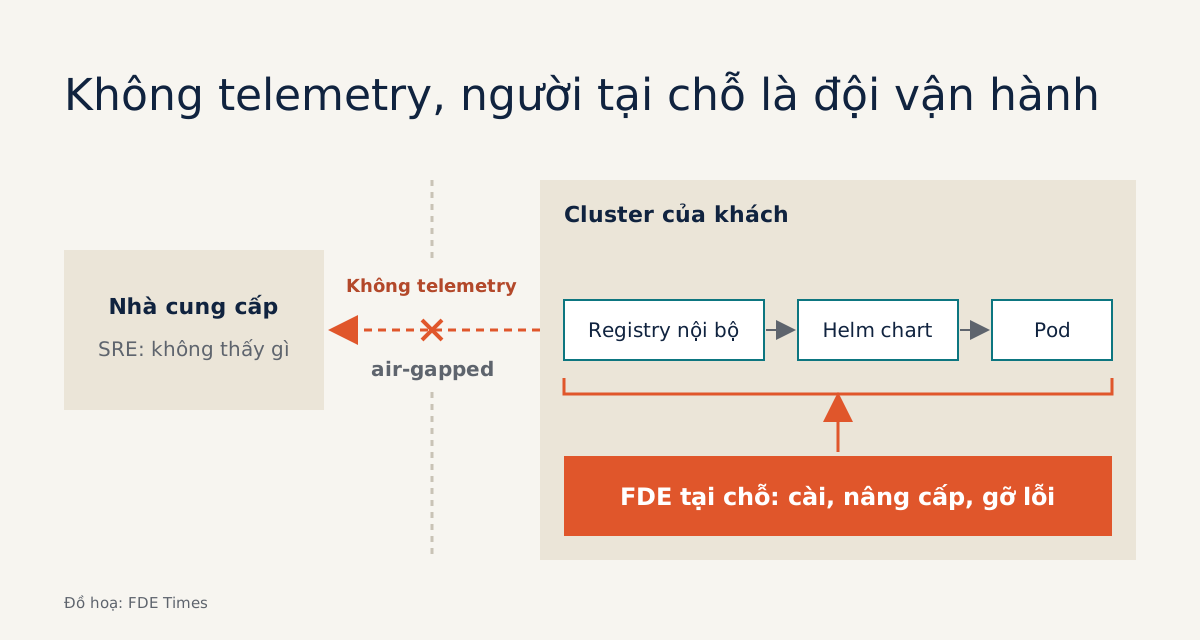
- Ở môi trường air-gapped, cluster không kéo được image từ registry công khai và cũng không gửi telemetry về nhà cung cấp, nên kỹ sư làm tại chỗ chính là đội vận hành.
- Đây không phải DevOps đổi tên: Palantir đòi phải code giỏi, còn tin tuyển FDE của Ultimate Knowledge yêu cầu Kubernetes, CNI, GitOps và kinh nghiệm giao phần mềm vào môi trường air-gapped.
Palantir không dồn mọi FDE vào chung một chức danh. Trên trang tuyển dụng của hãng có hẳn một vị trí tên là “Forward Deployed Infrastructure Engineer”, và mô tả công việc nói rất thẳng: bạn sẽ phát triển phần mềm, đồng thời chịu trách nhiệm về độ tin cậy và vận hành của các hệ thống phần mềm. Vị trí này còn có cả phiên bản tuyển new grad.
Chi tiết đó đáng để ý, vì hình mẫu FDE phổ biến hiện nay là người dựng agent, nối dữ liệu và ngồi làm việc với khách. Nếu thế mạnh của bạn là Kubernetes, Terraform hay mạng, có lẽ bạn chưa bao giờ nghĩ FDE là con đường dành cho mình.
Các tin tuyển dụng lại cho thấy điều ngược lại. Có một nhánh FDE mà kỹ năng hạ tầng là năng lực chính khách hàng cần đến, chứ không phải kỹ năng phụ. Nhánh này tồn tại vì một lý do cụ thể: có những khách hàng mà phần mềm phải chạy ở nơi nhà cung cấp không với tới được.
Môi trường của khách tạo ra chức danh này
Tài liệu về Apollo, nền tảng deployment của Palantir, ghi rằng Apollo hỗ trợ mọi môi trường cloud lớn, on-premises, và cả môi trường bị ngắt kết nối (air-gapped). Một roadmap FDE do cộng đồng tổng hợp trên GitHub mô tả hạ tầng mà FDE thường gặp là “khắc nghiệt, cũ kỹ, air-gapped hoặc hybrid”.
Ở một cluster bị cách ly, những thứ bình thường nhất cũng không còn sẵn. Tài liệu triển khai air-gapped của CoreWeave cảnh báo rằng cluster không thể kéo image từ registry công khai, nên mọi container image cần dùng phải có sẵn trong registry nội bộ của khách trước khi deploy.
Vấn đề thứ hai mới là thứ thay đổi bản chất công việc. TrueFoundry, khi mô tả cách đưa LLM vào các ngành bị quản lý chặt, cho biết cách làm phổ biến là cài bằng Helm vào cluster Kubernetes do khách sở hữu, tắt tự động cập nhật, và không có telemetry nào gửi về control plane của nhà cung cấp.
Không có telemetry thì đội SRE ở trụ sở không thấy gì cả: không dashboard, không cảnh báo, không log. Khi một pod chết lúc hai giờ sáng, người duy nhất có thể nhìn vào hệ thống là người đang có quyền truy cập ở phía khách. Vì thế chức danh này mới phải tồn tại: kỹ sư làm tại chỗ đồng thời là đội vận hành.
Một lần cài đặt không có internet
Thử hình dung bạn mang một Helm chart đến cluster của một khách hàng trong ngành tài chính. Giả sử chart đó tham chiếu chín image: bảy image cho ứng dụng, một image cho sidecar thu log và một image cho init container chạy migration. Bạn đã mirror bảy image chính vào registry nội bộ, nhưng quên hai image còn lại vì chúng nằm trong một subchart.
Trên một cluster có internet, lỗi này gần như không ai nhận ra, vì node sẽ tự kéo image về. Ở môi trường air-gapped, pod sẽ kẹt ở trạng thái ImagePullBackOff. Muốn sửa, bạn phải tìm cách đưa thêm hai image đó vào registry nội bộ, trong khi cluster không hề có đường ra internet.
Bài học ở đây không nằm ở Kubernetes mà ở thói quen làm việc. Trước khi đến chỗ khách, hãy render toàn bộ chart, lấy ra danh sách mọi image được tham chiếu, rồi viết script đối chiếu danh sách đó với registry đích.
Đây chính là kiểu “tự động hóa runbook” mà Palantir ghi trong mô tả công việc, bên cạnh nhiệm vụ deploy sản phẩm mới trên nhiều môi trường production.
Đây không phải DevOps đổi tên
Tin tuyển FDE của Ultimate Knowledge, đăng trên Workable, viết rõ: bạn sẽ làm việc trên cả cloud lẫn on-prem, và đây không phải một vai trò DevOps hay IT truyền thống. Ngay trong tin đó, Kubernetes được ghi là bắt buộc.
Hai câu này nghe có vẻ mâu thuẫn, nhưng thực ra không. Một kỹ sư DevOps thường chăm sóc nền tảng của chính công ty mình, nơi họ chọn công cụ và có toàn quyền truy cập. Kỹ sư hạ tầng forward deployed thì mang một sản phẩm đi qua nhiều môi trường không phải của mình, mỗi nơi một kiểu cấu hình và một bộ quy định riêng.
Vì vậy Palantir đặt yêu cầu về code ngang hàng với yêu cầu clearance của khối chính phủ Mỹ: phải là người code giỏi, thành thạo các ngôn ngữ như Java, Go, Python hoặc JavaScript. Khi chạy tay một runbook trên mười môi trường khác nhau thì kiểu gì cũng có lỗi. Viết nó thành công cụ mới là phần việc của kỹ sư phần mềm.
Đặt các tin tuyển dụng cạnh nhau sẽ thấy rõ chân dung của vai trò này, và thấy mỗi yêu cầu biến thành việc gì khi bạn làm ở chỗ khách.
| Yêu cầu trong tin tuyển dụng | Nơi xuất hiện | Thành việc gì ở chỗ khách |
|---|---|---|
| Code giỏi Java, Go, Python hoặc JavaScript | Palantir | Biến runbook thành công cụ chạy lặp lại được |
| Deploy sản phẩm trên nhiều môi trường production | Palantir | Một bản phát hành phải chạy được trên nhiều cấu hình khác nhau |
| Migration lên loại hạ tầng mới nhất, on-call | Palantir, bản new grad | Nâng cấp hệ thống đang chạy và trực sự cố |
| Kubernetes là bắt buộc | Ultimate Knowledge | Sản phẩm chạy trên cluster của khách, không phải của bạn |
| Quen với CNI như Calico, Cilium, Multus | Ultimate Knowledge | Làm việc được với lớp mạng mà khách đã chọn |
| GitOps, ưu tiên ArgoCD, chấp nhận Flux | Ultimate Knowledge | Trạng thái hệ thống nằm trong repo, không nằm trong trí nhớ |
| Từng giao phần mềm vào môi trường air-gapped hoặc bị quản lý chặt | Ultimate Knowledge | Lo trước image, chart và quy trình chuyển file |
Mạng là chỗ phân biệt người giỏi
Trong bảng trên, dòng về CNI là dòng đáng đọc kỹ nhất. Tin tuyển dụng của Ultimate Knowledge không chọn một plugin mà liệt kê cả ba cái tên Calico, Cilium và Multus. Cách đọc hợp lý là bạn không được chọn: cluster thuộc về khách hàng, và lớp mạng là thứ họ đã quyết từ trước khi bạn đến.
Như vậy, khi một service không gọi được sang service khác, bạn cần phân biệt được lỗi nằm ở ứng dụng, ở network policy hay ở cách CNI của khách xử lý lưu lượng. Người chỉ quen một cấu hình mặc định sẽ bị kẹt ngay ở bước này. Người hiểu mạng sẽ khoanh vùng được lỗi trước khi ca trực kết thúc.
GitOps cũng có vai trò tương tự. Thử hình dung bạn rời dự án và một đồng nghiệp khác vào tiếp quản: khi không có telemetry gửi về, việc lưu trạng thái mong muốn của hệ thống trong repo, rồi để ArgoCD hoặc Flux đồng bộ, giúp người đến sau hiểu được môi trường mà không phải đoán.
New grad cũng có cửa, nếu có bằng chứng
Bản tuyển new grad của Palantir không hạ thấp phạm vi công việc. Nhiệm vụ vẫn là deploy sản phẩm mới tại các deployment của khách, thực hiện migration lên loại hạ tầng mới nhất, và tham gia on-call. Nghĩa là ngay cả người mới ra trường cũng được kỳ vọng sẽ trực tiếp động vào hệ thống production thật.
Cách để chứng minh mình làm được việc đó không phải là một chứng chỉ nữa, mà là một dự án lab cho người khác chạy lại được. Hãy dựng một cluster, chặn đường ra internet, mirror image vào registry nội bộ, cài một chart thật bằng Helm, quản lý bằng ArgoCD và đổi CNI sang Cilium để xem network policy hoạt động khác đi thế nào.
Trên CV, hãy viết về kết quả, đừng chỉ liệt kê công cụ. Một dòng kiểu “cài đặt hệ thống chín image vào cluster không có internet, có script kiểm tra trước khi deploy” có sức nặng hơn hẳn một dòng chỉ ghi “Kubernetes, Helm, ArgoCD”.
Khi đọc tin tuyển dụng, hãy tìm các từ air-gapped, on-call và migrations: đó là dấu hiệu bạn đang nhìn vào nhánh hạ tầng chứ không phải nhánh làm demo.
Với nhiều kỹ sư hạ tầng, FDE từng nghe như một nghề đòi phải học thêm cả một bộ kỹ năng khác. Nhưng ở những nơi không có internet, chính kỹ năng hạ tầng lại là thứ khách hàng cần nhất.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
7 nguồn
- Palantir Technologies - Forward Deployed Infrastructure Engineer - US Government
- Forward Deployed Infrastructure Engineer, New Grad - US Government
- Introduction • Palantir
- Forward Deployed Engineer (Ultimate Knowledge)
- Deploy on Air-Gapped Kubernetes
- Air-Gapped AI: Deploying Enterprise LLMs in Highly Regulated Industries · 2026-05-12
- GitHub - pierpaolo28/Awesome-FDE-Roadmap