Vì sao Tonic.ai cần FDE: dữ liệu nhạy cảm của khách không rời khỏi hạ tầng của khách
Hai tin tuyển FDE của Tonic.ai cho thấy công việc này nặng về kiểm định và chịu trách nhiệm với khách nhiều hơn là triển khai cho xong việc.

Tóm tắt nhanh
- Theo tài liệu của Tonic, phần lớn khách tự host Textual trong VPC riêng và dữ liệu không rời khỏi môi trường của họ, nên kỹ sư phải vào làm ngay trong hạ tầng của khách.
- Một tin tuyển FDE của Tonic mô tả công việc kiểm tra từng lỗi khử định danh và viết phần kỹ thuật trong báo cáo gửi khách.
- Tin chính thức đòi 3-5 năm kinh nghiệm làm kỹ thuật với khách, đi công tác tới 25% thời gian, tham gia định phạm vi Professional Services và đưa phản hồi về cho Product.
Trong tài liệu về dữ liệu mà Tonic.ai thu thập có một câu ngắn: với các bản cài self-host, dữ liệu của khách không rời khỏi môi trường của khách. Câu đó cũng giải thích vì sao một công ty bán phần mềm khử định danh lại đi tuyển Forward Deployed Engineer.
Nếu sản phẩm không được nhìn thấy dữ liệu, kỹ sư của nhà cung cấp phải đi tới chỗ dữ liệu nằm. Ở Tonic, việc đó gồm cài đặt hạ tầng, kiểm tra chất lượng đầu ra, và viết một phần báo cáo gửi khách.
Nếu bạn đang làm hoặc muốn làm FDE, Tonic cho thấy một kiểu vai trò ít được nhắc đến. Ở đây công việc không xoay quanh việc dựng agent hay demo cho đẹp. Khách cần một người chịu trách nhiệm cho câu hỏi: dữ liệu này đã thật sự an toàn chưa?
Dữ liệu không đi, nên kỹ sư phải đi
Tonic mô tả Textual là công cụ xoá PII khỏi văn bản và âm thanh, để dữ liệu dùng được cho việc huấn luyện mô hình và cho các workflow agent chạy thời gian thực.
Một tin tuyển FDE của công ty, đăng trên Remotive, nói thẳng bài toán kinh doanh phía sau. Cả ngành phải tìm cách đưa dữ liệu doanh nghiệp tới các AI lab mà không để lộ những con người có trong dữ liệu đó.
Vướng mắc nằm ở chỗ phần mềm chạy ở đâu và dữ liệu nằm ở đâu. Tài liệu của Tonic cho biết phần lớn khách tự host Textual trong VPC của họ. Trang sản phẩm cũng khuyến khích cài on-premises bằng Kubernetes hoặc Docker, với lý do “an toàn và kiểm soát dữ liệu ở mức cao nhất”.
Hệ quả là nhà cung cấp mất quyền nhìn vào dữ liệu. Đội Tonic không thể mở log ở phía mình để xem mô hình đã bỏ sót tên ai. Muốn biết sản phẩm có chạy đúng trên dữ liệu thật hay không, phải có người ngồi bên trong ranh giới bảo mật của khách. Người đó là FDE.
Tin tuyển chính thức trên trang careers của Tonic cũng đi theo hướng này. FDE được đưa vào đội của khách để “triển khai và vận hành” các ứng dụng Tonic như một phần của giải pháp end-to-end, và đi công tác tới khách tới 25% thời gian. Làm từ xa là chính, nhưng vẫn có lúc phải có mặt tại chỗ.
Hai tin tuyển, hai mặt của cùng một công việc
Đọc riêng từng tin, bạn chỉ thấy một nửa vai trò. Đặt hai tin cạnh nhau mới thấy FDE ở Tonic vừa lo hạ tầng và phạm vi hợp đồng, vừa lo chất lượng từng dòng dữ liệu.
| Khía cạnh | Tin chính thức (tonic.ai) | Tin trên Remotive |
|---|---|---|
| Việc chính | Triển khai, vận hành ứng dụng Tonic trong đội của khách | Chạy dữ liệu của từng khách qua pipeline khử định danh |
| Thứ phải giao | Giải pháp end-to-end đang chạy | Đầu ra đã kiểm tra và phần kỹ thuật trong báo cáo gửi khách |
| Vòng phản hồi | Báo lại Product và Engineering về nền tảng lõi | Biến mỗi lần sửa lẻ thành tài liệu, runbook, cải tiến sản phẩm |
| Phần thương mại | Giúp định các tham số cho mảng Professional Services | Không nhắc |
| Điều tin nhấn mạnh | 3-5 năm làm kỹ thuật với khách, đi công tác tới 25% | Kiểm tra đầu ra theo từng loại lỗi cụ thể |
Bảng này cho thấy hai điều. Tin chính thức coi FDE là người giữ cho bản triển khai sống được và giúp xác định phạm vi công việc dịch vụ, tức là ảnh hưởng đến cách công ty bán và báo giá. Tin trên Remotive cụ thể hơn nhiều: công việc là giao một kết quả đã được kiểm chứng.
Ba lỗi phải soi trên từng bộ dữ liệu
Tin trên Remotive liệt kê đúng những gì FDE phải soi trong đầu ra: thực thể bị bỏ sót, thay thế sai, danh tính bị gộp hoặc bị tách nhầm. Một kỹ sư chưa làm khử định danh dễ nghĩ chỉ có lỗi đầu tiên đáng lo. Hai lỗi sau mới khó.
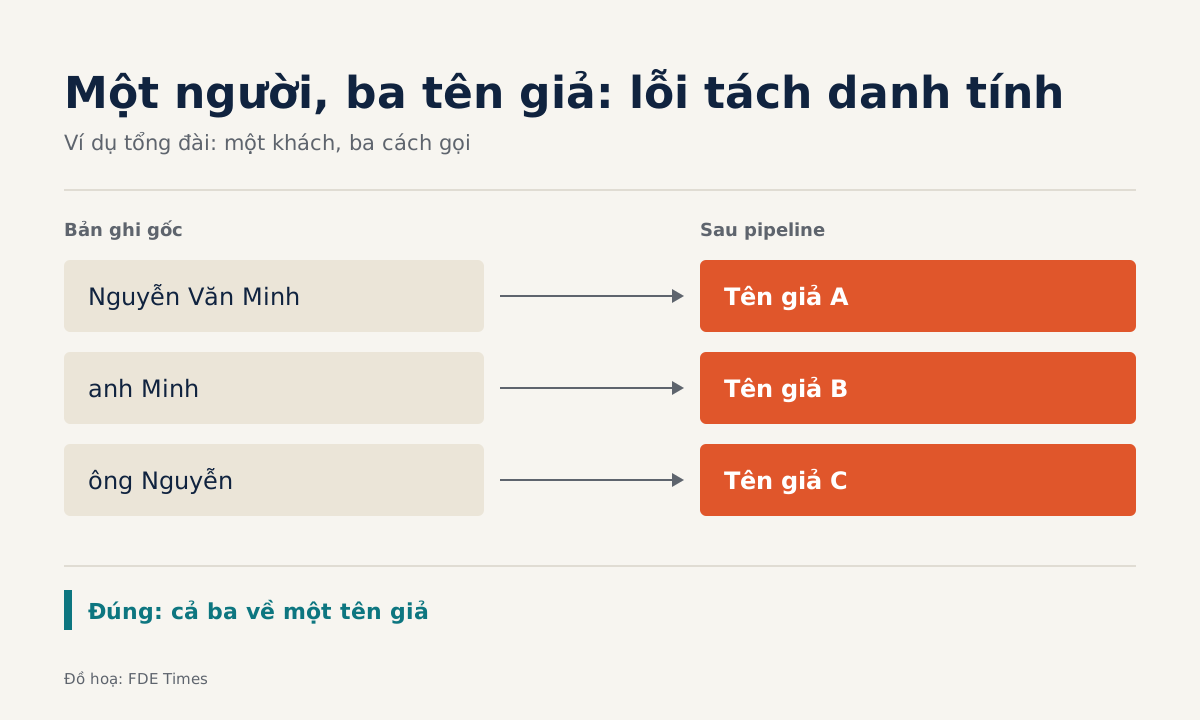
Thử hình dung một khách là tổng đài chăm sóc khách hàng, gửi vào pipeline một lô bản ghi cuộc gọi. Trong cùng một cuộc gọi, khách hàng được gọi là “Nguyễn Văn Minh”, lúc khác là “anh Minh”, lúc khác nữa là “ông Nguyễn”.
Nếu hệ thống thay ba cách gọi này bằng ba tên giả khác nhau, một người đã bị tách thành ba. Mô hình huấn luyện trên dữ liệu đó sẽ học sai cấu trúc hội thoại.
Lỗi ngược lại cũng tệ không kém. Một cuộc gọi khác có hai người cùng tên Minh, một khách hàng và một nhân viên. Nếu cả hai bị thay bằng cùng một tên giả, hai danh tính đã bị gộp thành một.
Còn nếu ở đâu đó tên được đánh vần từng chữ cái qua điện thoại mà hệ thống không nhận ra, đó là thực thể bị bỏ sót, và là PII thật đang rò ra.
Cả ba lỗi đều không hiện lên trong một con số “precision” tổng. Vì thế việc đầu tiên nên làm với một bộ dữ liệu mới là lấy mẫu theo từng loại tài liệu và đọc bằng mắt. Sau đó ghi lỗi theo đúng ba nhóm trên, thay vì gom vào một tỷ lệ chung.
Báo cáo gửi khách là trách nhiệm, không phải thủ tục
Chi tiết đáng chú ý nhất trong tin Remotive là FDE phải viết các phần kỹ thuật trong báo cáo gửi khách. Như vậy cách xử lý dữ liệu nhạy cảm là một thứ phải giao và có người chịu trách nhiệm, chứ không phải một bước nội bộ chạy xong rồi thôi.
Bạn sẽ thấy khác biệt ngay khi bắt tay viết. “Pipeline đã chạy trên toàn bộ dữ liệu” là câu ai cũng viết được.
“Trên mẫu đã kiểm tra, các lỗi tách danh tính tập trung ở bản ghi có xưng hô thân mật, đã xử lý bằng quy tắc bổ sung” là câu chỉ người đã thực sự đọc dữ liệu mới viết được.
Khách trả tiền cho loại câu thứ hai.
Khi dữ liệu nằm yên trong môi trường của khách, nhà cung cấp không thể chỉ vào hệ thống của mình để chứng minh đã làm đúng. Phần kỹ thuật trong báo cáo là chỗ công việc kiểm tra trở nên nhìn thấy được, nên nó đáng được viết cẩn thận như viết code.
Mỗi lần sửa lẻ phải thành tài sản dùng lại
Có một rủi ro quen thuộc ở mọi đội FDE: mỗi khách thành một bản fork riêng, và kỹ sư thành người duy nhất hiểu nó. Tonic chặn rủi ro này ngay trong mô tả công việc.
Tin Remotive yêu cầu biến mọi lần sửa lẻ thành tài liệu, runbook và cải tiến sản phẩm. Tin chính thức yêu cầu FDE làm việc với Product và Engineering để góp ý cho nền tảng lõi.
Quay lại ví dụ tổng đài. Quy tắc gom “anh Minh” và “ông Nguyễn” về cùng một danh tính không nên nằm mãi trong script của một khách. Nó nên được viết thành một mục runbook về dữ liệu hội thoại, và nếu lặp lại ở khách thứ hai thì đề xuất lên đội sản phẩm.
Đó là lý do Tonic cần FDE chứ không chỉ cần kỹ sư hỗ trợ. Hàng ngày các FDE đọc những kiểu lỗi mà đội sản phẩm ngồi trong văn phòng không bao giờ thấy được, chính vì dữ liệu nằm sau VPC của khách.
Kỹ năng nào luyện được trước khi có chức danh?
Yêu cầu 3-5 năm làm kỹ thuật với khách cho thấy Tonic không tuyển người mới ra trường cho vai trò này. Nhưng kỹ năng thì luyện được trước khi có chức danh, và ở các vòng phỏng vấn kiểu này bạn nên chứng minh được ba thứ.
Kỹ năng đầu tiên là cài phần mềm trong một môi trường bạn không kiểm soát: Kubernetes hoặc Docker trên mạng bị khoá, không ra internet, quyền hạn hẹp.
Tiếp theo là đánh giá đầu ra của một hệ thống trích xuất thực thể theo từng loại lỗi, không dừng ở một con số tổng. Cuối cùng là viết cho khách đọc, bằng câu cụ thể có số liệu từ mẫu đã kiểm tra.
Khi đọc tin tuyển FDE ở bất kỳ công ty dữ liệu nào, hãy tìm những cụm như “client report”, “runbook”, “self-host” hay “customer VPC”. Chúng cho biết vai trò nặng về chịu trách nhiệm với kết quả hơn là demo.
Trong CV, thay “đã triển khai hệ thống X” bằng “triển khai trong hạ tầng của khách, kiểm tra đầu ra theo từng loại lỗi, để lại runbook đội khác dùng lại được”.
Trang About của Tonic viết rằng công ty tin quyền riêng tư dữ liệu là một quyền con người. Câu đó có thể in trên bất kỳ trang web nào. Ở Tonic, người phải thực hiện nó trên từng bản ghi cụ thể, bên trong hạ tầng của khách, là FDE.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!