Chọn OpenAI, Anthropic, Gemini hay open-weight cho khách: dữ liệu đi đâu quan trọng hơn bảng xếp hạng
Ở công ty khách, model "tốt nhất" thường không phải model được chọn. Model được chọn là model mà bộ phận compliance chịu ký, và hệ thống của bạn đổi được chỉ bằng cách sửa cấu hình.
Tóm tắt nhanh
- Theo khảo sát giữa năm 2025 của Menlo Ventures, Anthropic chiếm 32% lượng dùng LLM trong doanh nghiệp, OpenAI 25%, Google 20%. Dù vậy, thị phần không phải lý do để chọn model cho một khách cụ thể.
- Với từng khách, nhà cung cấp thường được quyết định bởi cách giữ dữ liệu, vùng xử lý và hợp đồng cloud họ đang có.
- Đặt model sau một lớp abstraction để lựa chọn model đổi lại được, thay vì trở thành cam kết lâu dài.
Giữa năm 2025, Menlo Ventures công bố một con số làm nhiều người bất ngờ: Anthropic chiếm 32% lượng sử dụng LLM trong doanh nghiệp, vượt OpenAI và Google (20%). OpenAI chỉ còn 25%, bằng một nửa mức của chính họ hai năm trước.
Nhiều kỹ sư đọc số liệu này sẽ rút ra một kết luận đơn giản: cứ chọn nhà cung cấp đang dẫn đầu. Kết luận đó không sai hoàn toàn. Nhưng nó trả lời câu hỏi “thị trường đang dùng gì”, trong khi câu hỏi thật ở công ty khách là model nào được phép chạy trên dữ liệu của họ.
Nếu bạn muốn làm FDE, đây là điều cần nắm sớm. Ở công ty khách, việc chọn model phần lớn bị quyết định bởi dữ liệu nằm ở đâu, được giữ bao lâu và đi qua hợp đồng nào, nhiều hơn là bởi benchmark. Ai hiểu rõ các ràng buộc này sẽ dẫn dắt được cuộc họp.
Ai chỉ thuộc bảng xếp hạng thì thường phải ngồi nghe bộ phận pháp chế giải thích.
Thị phần cho biết điều gì, và không cho biết điều gì?
Dữ liệu của Menlo vẫn có giá trị. Nó cho thấy doanh nghiệp chọn model theo hiệu năng chứ không theo giá, và builder thường chọn frontier model thay vì các model rẻ hơn, nhanh hơn. Vì vậy, lựa chọn mặc định của bạn nên là một frontier model, không phải model rẻ nhất.
Cũng theo Menlo, model open-source (open-weight) chỉ chiếm 13% khối lượng công việc AI trong doanh nghiệp, giảm từ 19% sáu tháng trước đó. Chỉ nhìn con số này, bạn sẽ nghĩ open-weight đang mất chỗ đứng.
Nhưng một tỷ lệ trung bình toàn thị trường không nói gì về khách hàng bạn đang ngồi cùng. Câu hỏi đáng hỏi là khách đó có ràng buộc nào buộc phải dùng open-weight hay không.
Cũng cần nhớ khảo sát này có từ tháng 7/2025, nên đến cuối 2026 các tỷ lệ có thể đã khác. Bạn có thể dùng nó để hiểu xu hướng, nhưng đừng đem nó ra làm lý do khi đề xuất model cho một khách cụ thể.
Câu hỏi đầu tiên: dữ liệu được giữ bao lâu?
Thử hình dung bạn đang triển khai một agent đọc hồ sơ bồi thường cho một công ty bảo hiểm. Câu đầu tiên bộ phận compliance hỏi gần như chắc chắn là nhà cung cấp lưu prompt của họ bao lâu, chứ không phải model nào thông minh hơn.
OpenAI và Anthropic đều có một con số 30 ngày, nhưng đó không phải cùng một cơ chế. OpenAI tạo log giám sát lạm dụng cho mọi tính năng API và mặc định giữ log này tối đa 30 ngày. Còn với API tiêu chuẩn của Anthropic, chính input và output được tự động xoá trong vòng 30 ngày kể từ khi nhận hoặc tạo ra.
Hai câu này mô tả hai thứ khác nhau, nên đừng chép “30 ngày” vào tài liệu gửi compliance như thể hai bên giống hệt. Hãy ghi rõ thứ gì được giữ. Riêng zero data retention ở Anthropic là một thỏa thuận ký riêng, không tự có khi bạn chỉ tạo API key.
Chi tiết này ảnh hưởng thẳng đến tiến độ. Nếu khách yêu cầu không lưu dữ liệu ngày nào, bạn không thể hứa điều đó ngay tuần đầu, vì còn phải chờ thỏa thuận được ký. Hãy đưa yêu cầu này vào kế hoạch từ đầu để không bị kẹt lúc chuẩn bị lên production.
Dữ liệu được xử lý ở đâu?
Câu hỏi thứ hai là vùng xử lý. OpenAI cho phép đặt vùng lưu trữ dữ liệu cho từng project mới, với các lựa chọn gồm Mỹ, châu Âu (EEA và Thụy Sĩ) và UAE. Vì cài đặt này áp dụng cho project mới, bạn nên tạo project ở đúng vùng ngay từ đầu thay vì để sau mới tính chuyện chuyển.
Cloud khách đang dùng thường đã chọn sẵn cho bạn
Đây là điều nhiều kỹ sư mới làm FDE hay bỏ qua: kênh mua model đôi khi quan trọng hơn chính model. Claude được bán qua Google Cloud, Amazon Bedrock, Microsoft Foundry và một số kênh khác. Nếu khách đã có hợp đồng với một hyperscaler, họ có thể dùng Claude theo hợp đồng đó mà không phải thêm một nhà cung cấp mới.
Với bộ phận mua sắm, việc này có thể rút ngắn quy trình đáng kể. Đổi lại, quy tắc xử lý dữ liệu cũng đổi theo kênh mua: khi dùng Claude trên Google Cloud, việc xử lý dữ liệu do Google Cloud quản lý. Vì thế, tài liệu bạn đưa cho compliance phải là tài liệu của Google Cloud, không phải trang privacy của Anthropic.
Tiếp theo là chuyện endpoint. Trên Google Cloud, endpoint regional và multi-region của Claude đắt hơn endpoint global 10%, và endpoint global được khuyến nghị làm mặc định. Giả sử hoá đơn của khách trên endpoint global là 1.000 USD mỗi tháng, chuyển sang regional sẽ thành 1.100 USD. Khoản này không lớn, nhưng khách cần biết trước để không bất ngờ khi nhận hoá đơn.
Gemini trên Google Cloud cũng vận hành theo cách tương tự. Request gửi tới endpoint global có thể được xử lý ở bất kỳ vị trí nào của Google Cloud trên thế giới, còn endpoint theo khu vực pháp lý giữ phần xử lý ML trong vùng đó.
Nếu bạn để endpoint global chỉ vì nó là mặc định, có thể bạn đã vô tình làm trái cam kết lưu trữ dữ liệu trong vùng mà khách đã ký với người dùng của họ.
Bảng dưới gom các ràng buộc này lại. Đây là những câu hỏi bạn nên trả lời trước khi chạy bất kỳ benchmark nào; ô nào ghi “cần kiểm tra” là phần bạn phải tự đọc tài liệu trước buổi họp.
| Câu hỏi của khách | OpenAI API | Claude (API trực tiếp hoặc qua cloud) | Gemini trên Google Cloud | Open-weight tự host (gpt-oss-120b) |
|---|---|---|---|---|
| Dữ liệu được giữ bao lâu? | Log giám sát lạm dụng giữ tối đa 30 ngày | API trực tiếp: input/output xoá trong 30 ngày, zero retention cần thỏa thuận riêng | Cần kiểm tra trong tài liệu Google Cloud | Do khách tự quyết |
| Dữ liệu được xử lý ở đâu? | Chọn vùng theo project: Mỹ, châu Âu, UAE | Trên Google Cloud: global là mặc định, regional đắt hơn 10% | Global có thể xử lý ở bất kỳ đâu, jurisdictional giữ trong vùng | Trên hạ tầng của khách |
| Hợp đồng đi qua đâu? | Ký với OpenAI | Ký với Anthropic hoặc qua Google Cloud, Bedrock, Foundry | Ký với Google Cloud | Giấy phép Apache 2.0 |
| Cái giá phải trả | Thêm một nhà cung cấp mới | Phụ phí nếu cần giữ dữ liệu trong vùng | Phải chọn đúng endpoint | Tự vận hành GPU 80GB |
Khi nào open-weight là lựa chọn đúng?
Có những khách mà mọi cột bên trái của bảng đều không dùng được, chẳng hạn khi dữ liệu không được phép rời hạ tầng nội bộ, hoặc khi vùng họ cần không nằm trong danh sách nhà cung cấp hỗ trợ. Với những khách đó, open-weight là phương án nghiêm túc, dù chỉ chiếm 13% thị trường.
gpt-oss-120b của OpenAI là một ví dụ cụ thể. Model này dùng giấy phép Apache 2.0 và chạy được trên một GPU 80GB như NVIDIA H100 hoặc AMD MI300X. Nói cách khác, khách chỉ cần một máy chủ GPU, không cần cả một cụm máy.
Giấy phép quan trọng không kém phần cứng. Trang model mô tả Apache 2.0 là không có ràng buộc copyleft và không có rủi ro về bằng sáng chế. Đó là một luận điểm cụ thể bạn có thể mang tới bộ phận pháp chế khi khách định triển khai thương mại, dù quyết định duyệt vẫn thuộc về họ.
Phần việc khó còn lại thuộc về bạn: vận hành, giám sát và nâng cấp model, những thứ trước đây nhà cung cấp API làm thay.
Vì vậy, chỉ nên đề xuất open-weight khi ràng buộc dữ liệu thật sự bắt buộc.
Đừng gắn chặt hệ thống vào một nhà cung cấp
Các ràng buộc ở trên có thể thay đổi giữa chừng dự án. Khách có thể ký zero data retention vào tháng thứ ba, chuyển sang cloud khác, hoặc một model mới ra đời và vượt model bạn đang dùng. Nếu tên nhà cung cấp nằm rải rác khắp code, mỗi lần như vậy sẽ thành một đợt refactor.
LiteLLM giải quyết đúng vấn đề này. Nó cho phép gọi hơn 100 LLM, gồm OpenAI, Anthropic, Vertex AI, Bedrock và nhiều nhà cung cấp khác, qua cùng một định dạng của OpenAI. Nó cũng hỗ trợ fallback và theo dõi chi phí theo từng nhóm, nên việc đổi model chỉ còn là sửa cấu hình, không phải sửa code.
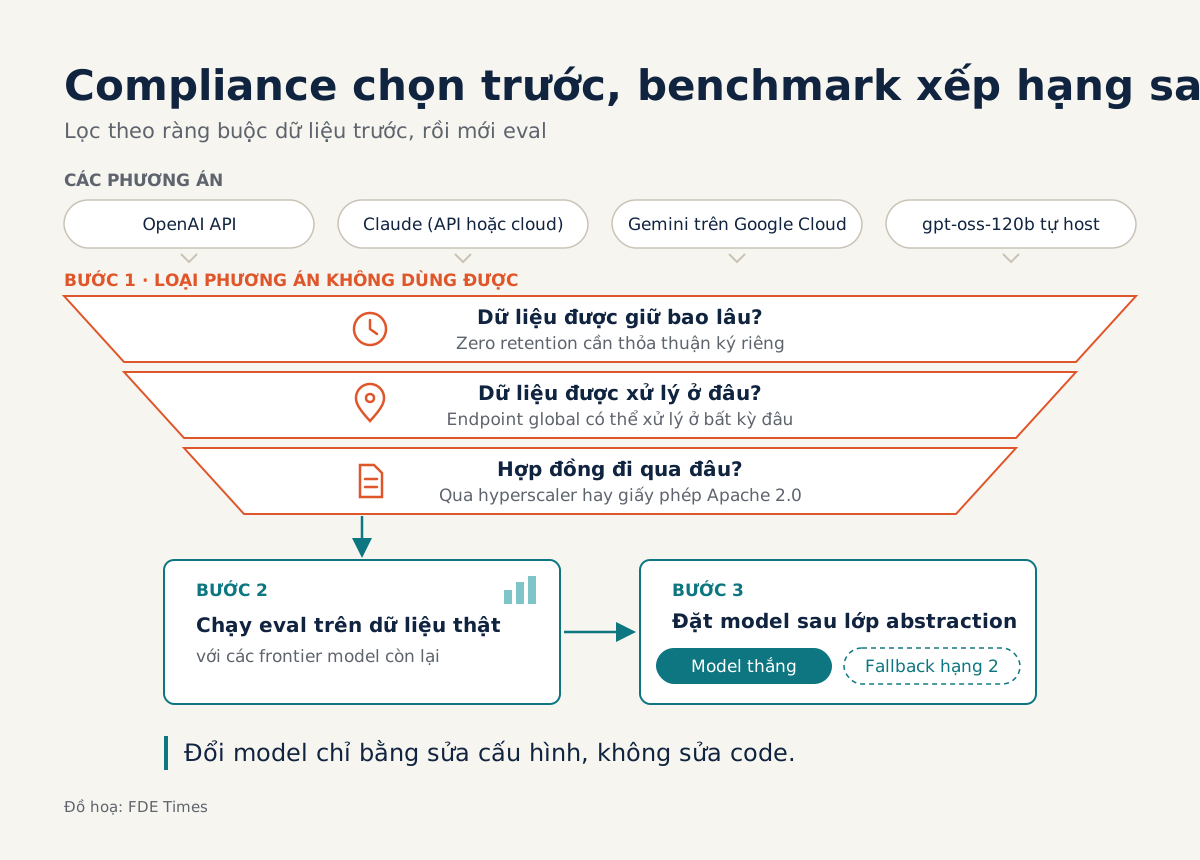
Từ đó, quy trình ở công ty khách nên đi theo ba bước. Đầu tiên, xác định ràng buộc về dữ liệu và hợp đồng để loại những phương án không dùng được. Sau đó, chạy eval trên dữ liệu thật của khách với các frontier model còn lại, rồi đặt model thắng cuộc sau một lớp abstraction, kèm fallback sang model đứng thứ hai.
Developer Việt Nam nên luyện gì?
Với khách hàng hoạt động ở nhiều quốc gia, câu hỏi dữ liệu nằm ở đâu thường xuất hiện ngay buổi họp đầu tiên. Hãy tập trả lời câu hỏi đó trước khi trả lời câu hỏi model nào mạnh hơn. Mỗi khi một nhà cung cấp cập nhật, hãy đọc lại trang data controls của họ và cập nhật bảng so sánh của riêng bạn.
Khi đọc JD các vị trí FDE, hãy để ý những từ như “data residency”, “compliance”, “multi-cloud” hay “Bedrock/Vertex”. Những từ này cho thấy công việc thực tế sẽ xoay quanh đúng các ràng buộc vừa bàn. Trong CV, đừng chỉ ghi “tích hợp GPT-4”.
Hãy viết rằng bạn đã thiết kế lớp gọi model có fallback giữa hai nhà cung cấp và chọn endpoint theo yêu cầu lưu trữ dữ liệu trong vùng của khách.
Một side project tốt cho mục tiêu này là một chatbot nội bộ chạy được với ba cấu hình: API của OpenAI, Claude qua cloud và gpt-oss-120b tự host. Kèm theo là một trang README giải thích khi nào nên dùng cấu hình nào.
Trang README đó cho thấy bạn biết đọc ràng buộc của khách để chọn cấu hình phù hợp, điều mà một bản demo gọi API không thể hiện được.
Các bảng xếp hạng thị phần sẽ còn thay đổi mỗi sáu tháng. Những câu hỏi về thời gian giữ dữ liệu, vùng xử lý và hợp đồng thì sẽ gặp lại ở mọi khách hàng.
7 nguồn
- 2025 Mid-Year LLM Market Update: Foundation Model Landscape + Economics · 2025-07-31
- Data controls in the OpenAI platform
- How long do you store my organization's data?
- Claude on Google Cloud
- Data residency | Gemini Enterprise Agent Platform | Google Cloud Documentation
- openai/gpt-oss-120b · Hugging Face
- Getting Started | liteLLM