Chọn nền tảng ML pipeline theo người sẽ vận hành nó khi bạn rời đi
Microsoft tự xếp Kubeflow ngang Azure ML pipelines, Vertex chạy thẳng mã KFP, nên bảng so tính năng không còn phân định được nền tảng nào hơn.
Tóm tắt nhanh
- Mã pipeline đã gần như dùng chung: Vertex Pipelines chạy mã KFP, Microsoft tự xếp Kubeflow Pipelines là bản tương đương mã nguồn mở của Azure ML pipelines.
- Khác biệt thật nằm ở người vận hành: KFP cần đội khách sở hữu Kubernetes, còn Vertex và SageMaker nhận phần hạ tầng điều phối.
- Hỏi ai sẽ trực khi pipeline hỏng trước, rồi mới chọn công cụ và giao diện cho đúng người đó.
Trong tài liệu chính thức về machine learning pipeline, Microsoft tự kẻ một bảng và đặt Kubeflow Pipelines vào ô “tương đương mã nguồn mở” của chính Azure Machine Learning pipelines. Hai bên cùng phục vụ một persona là data scientist, cùng đi một chặng từ dữ liệu tới model.
Một nhà cung cấp cloud tự nhận dự án mã nguồn mở là bản tương đương của sản phẩm mình. Google thì để Vertex Pipelines chạy thẳng mã viết bằng KFP SDK. Khi ranh giới tính năng mờ tới mức đó, so tính năng gần như vô ích, và câu hỏi quyết định chuyển sang chỗ khác: sau khi bạn rời site khách, ai sẽ vận hành pipeline?
Với một FDE, đây không phải câu hỏi lý thuyết. Bạn thường là người dựng pipeline đầu tiên, nhưng không phải người sống cùng nó. Chọn nền tảng không hợp với người nhận bàn giao thì pipeline đẹp đến đâu cũng sẽ mục dần.
Mã pipeline đã gần như chung một ngôn ngữ
Bắt đầu từ Kubeflow. Theo repo chính thức, Kubeflow Pipelines là các workflow ML end-to-end tái sử dụng được, viết bằng KFP SDK và chạy trên Kubernetes. Bạn khai báo từng bước, nối đầu ra bước này vào đầu vào bước kia, rồi biên dịch thành một bản mô tả pipeline.
Điểm then chốt là bản mô tả đó không bị khóa vào cluster của bạn. Khi công bố Vertex Pipelines bản chính thức vào tháng 11/2021, Google nói rõ dịch vụ hỗ trợ hai thư viện mã nguồn mở là Kubeflow Pipelines và TensorFlow Extended. Pipeline viết bằng KFP vì thế có đường chuyển sang dịch vụ managed của Google mà không phải viết lại logic.
Azure cũng không đứng ngoài xu hướng này. Microsoft cho phép dựng pipeline bằng CLI, Python SDK hoặc Designer UI, và trong chính bảng đối chiếu nói trên, Azure ML pipelines với Kubeflow Pipelines cùng một hàng, cùng nhấn vào phân tán, caching, code-first và tái sử dụng. Các bên đang nói chung một bộ từ vựng.
Ngay cả cách phân biệt phổ biến nhất cũng không còn sắc. Blog của JFrog, một vendor có góc nhìn riêng, tóm rằng Kubeflow tập trung vào orchestration và pipeline, còn SageMaker nghiêng về data science. Đó là khác biệt về trọng tâm sản phẩm, không phải về chuyện pipeline của khách có chạy được hay không.
Khác biệt thật: ai sẽ trực khi pipeline hỏng?
Đọc lại các tài liệu, lần này chỉ chú ý những câu nói về người vận hành. Repo Kubeflow ghi rằng KFP có thể cài như một phần của Kubeflow Platform hoặc triển khai thành dịch vụ độc lập. Cách nào cũng dẫn tới cùng một hệ quả: ai đó phía khách phải sở hữu cluster Kubernetes, nâng cấp nó và nhận cảnh báo khi nó trục trặc.
Phía cloud nói điều ngược lại, và nói rất thẳng. Google viết rằng Vertex AI lo cấp phát và co giãn hạ tầng để chạy pipeline, khách chỉ trả cho tài nguyên dùng trong lúc pipeline chạy, còn data scientist được tập trung vào ML.
AWS mô tả SageMaker Pipelines là dịch vụ orchestration serverless dành riêng cho MLOps và LLMOps, tức khách không phải tự vận hành phần điều phối.
Lời hứa thứ hai nằm ở giao diện. SageMaker Pipelines có giao diện kéo thả trong SageMaker Studio, Azure ML có Designer UI bên cạnh SDK và CLI. Các nhà cung cấp đang thiết kế cho cả những người không muốn đọc YAML, chứ không chỉ cho kỹ sư platform.
Tài liệu Azure ML còn có một câu đáng dán lên tường phòng họp: data engineer, data scientist và ML engineer mỗi nhóm sở hữu các bước của mình. Một pipeline không có một chủ duy nhất. Vì thế câu hỏi “ai vận hành” phải tách thành ba lớp: ai viết bước, ai sửa bước, và ai giữ cho cỗ máy bên dưới còn sống.
Thử hình dung hai khách hàng. Khách A là một công ty thương mại điện tử có ba data scientist, chạy trên AWS và không ai rành Kubernetes. Khách B là một ngân hàng có đội platform đã vận hành Kubernetes nhiều năm và muốn mọi thứ nằm trên hạ tầng của mình.
Về tính năng, cả hai đều dùng được bất kỳ lựa chọn nào. Về người vận hành, A gần như chắc chắn nên đi SageMaker Pipelines, vì không ai trong đội đủ sức gánh một cluster. B có lý do chính đáng để triển khai KFP độc lập, vì đội platform đã quen trực đúng loại hệ thống đó.
AWS quảng bá rằng SageMaker Pipelines có thể chạy hàng chục nghìn workflow ML đồng thời trong production. Con số ấn tượng, nhưng không quyết định gì với khách A, vốn có lẽ chỉ chạy vài pipeline mỗi ngày. Con số đáng hỏi hơn là có bao nhiêu người phía khách đọc được log của một pod lúc nửa đêm.
Bốn lựa chọn, xếp theo người vận hành
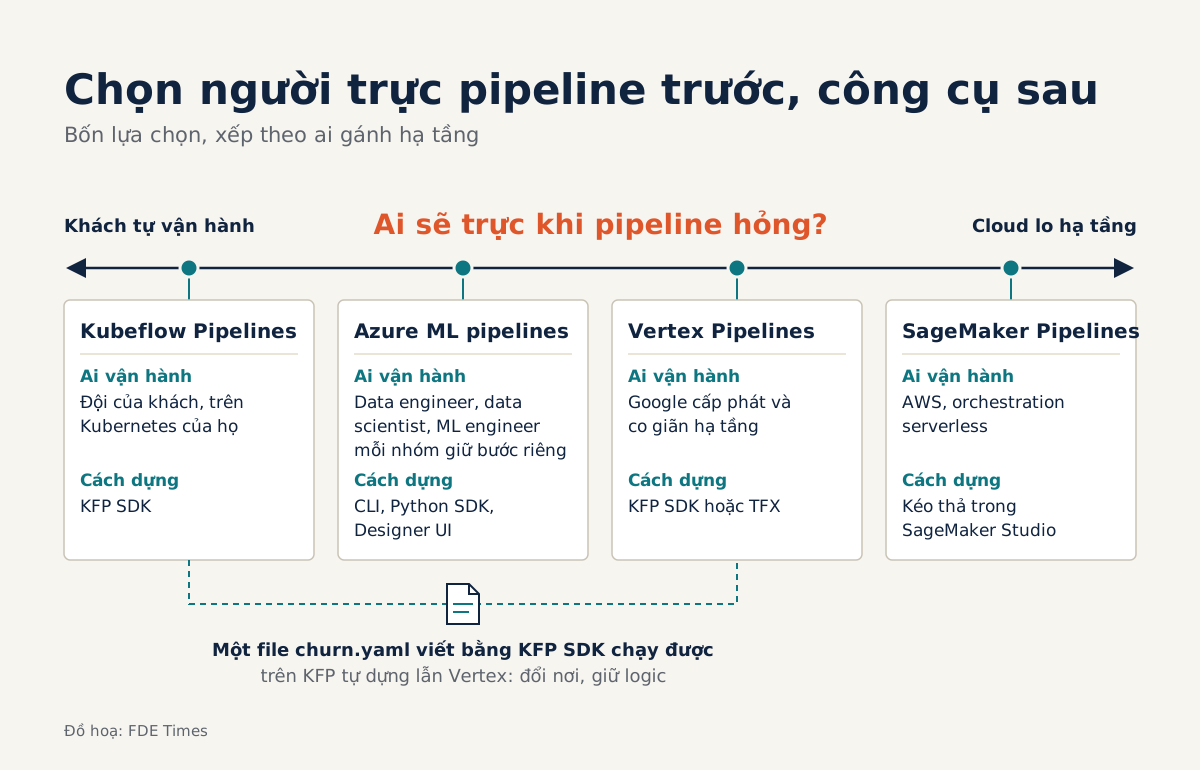
Ghép các tài liệu lại, bức tranh rõ hơn khi đặt cột “ai vận hành” lên đầu thay vì cột tính năng:
| Lựa chọn | Ai vận hành, theo tài liệu | Cách dựng pipeline được nhắc tới | Hợp với đội nào |
|---|---|---|---|
| Kubeflow Pipelines (độc lập hoặc trong Kubeflow Platform) | Đội của khách, trên Kubernetes của họ | KFP SDK | Đã có đội platform quen Kubernetes |
| Vertex Pipelines | Google cấp phát và co giãn hạ tầng | KFP SDK hoặc TFX | Trên GCP, muốn giữ mã KFP mà bỏ gánh cluster |
| SageMaker Pipelines | AWS, dạng orchestration serverless | Có giao diện kéo thả trong SageMaker Studio | Trên AWS, đội nhỏ, ít quen code hạ tầng |
| Azure ML pipelines | Data engineer, data scientist, ML engineer mỗi nhóm sở hữu bước riêng | CLI, Python SDK hoặc Designer UI | Trên Azure, nhiều vai cùng sở hữu các bước |
Nhìn vào cột cuối cùng, bạn thấy quyết định thật ra được đưa ra trước khi mở bất kỳ trang tính năng nào. Cloud mà khách đang dùng và đội mà khách đang có đã loại gần hết các phương án.
Một pipeline “sẵn sàng chuyển nhà” trông thế nào?
Có một nước đi giúp bạn giảm rủi ro khi chưa chắc ai sẽ vận hành: viết pipeline bằng KFP SDK, giữ logic sạch khỏi API riêng của từng cloud. Đoạn mã minh họa dưới đây chỉ có hai bước:
from kfp import dsl, compiler

@dsl.component(base_image="python:3.11")
def lam_sach(du_lieu_vao: str) -> str:
    # chỉ xử lý dữ liệu, không gọi API riêng của cloud nào
    return du_lieu_vao

@dsl.component(base_image="python:3.11")
def huan_luyen(du_lieu: str) -> str:
    return "model-uri"

@dsl.pipeline(name="churn-pipeline")
def churn(du_lieu_vao: str):
    sach = lam_sach(du_lieu_vao=du_lieu_vao)
    huan_luyen(du_lieu=sach.output)

compiler.Compiler().compile(churn, "churn.yaml")
File churn.yaml sinh ra có thể chạy trên KFP mà đội platform của khách tự triển khai, và vì Vertex Pipelines hỗ trợ KFP, cũng có đường chạy trên dịch vụ managed của Google. Nếu sáu tháng sau khách quyết định không muốn trực cluster nữa, bạn đổi nơi chạy chứ không viết lại logic.
Để giữ được lợi thế đó, lời khuyên là tách mọi thứ gắn với môi trường, như đường dẫn lưu trữ hay tên project, thành tham số truyền vào pipeline thay vì viết cứng trong component. Tuần đầu ở site khách, việc nên làm trước tiên là ghi lên bảng tên người sẽ nhận cảnh báo khi pipeline lỗi, rồi mới mở IDE.
Đọc JD để biết ai sẽ trực pager
Kỹ năng này cũng giúp bạn chọn việc. JD nhắc tới Kubernetes, Helm, Kubeflow thường ngầm báo rằng bạn hoặc khách sẽ là người vận hành, nên hãy chuẩn bị nói về nâng cấp cluster và xử lý sự cố.
JD nhấn vào SageMaker Studio, Designer hay làm việc với stakeholder cho thấy bạn sẽ bàn giao cho data scientist, và kỹ năng quan trọng là thiết kế để người khác sửa được.
Với developer Việt Nam đang muốn chuyển sang FDE, cách luyện rẻ nhất là chạy cùng một file KFP ở hai nơi: một cluster local và Vertex Pipelines. Trong CV, đừng chỉ liệt kê “Kubeflow, SageMaker”. Hãy viết rõ bạn đã chọn nền tảng dựa trên đội nào sẽ vận hành, và bàn giao cho ai.
Trong phỏng vấn, khi được hỏi nên chọn công cụ nào, hãy thử đáp bằng một câu hỏi ngược: sau khi FDE rời đi, ai sẽ được gọi dậy khi pipeline hỏng? Nên luyện sẵn phản xạ đó, vì công cụ có thể đổi sau một cuộc họp, còn đội vận hành là thứ bạn phải thiết kế xoay quanh.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
5 nguồn
- GitHub - kubeflow/pipelines: Machine Learning Pipelines for Kubeflow
- Announcing Vertex Pipelines general availability · 2021-11-11
- Amazon SageMaker Pipelines
- What are machine learning pipelines? - Azure Machine Learning | Microsoft Learn · 2026-09-09
- A Brief Comparison of Kubeflow vs. SageMaker · 2022-11-10