Tầng parse đắt gấp 25 lần: khi nào đáng trả cho PDF khó của khách
Fast đủ cho văn bản thuần, còn bảng có ô gộp cần tầng cao hơn, nên hãy thử trang khó nhất trước khi báo giá.
Tóm tắt nhanh
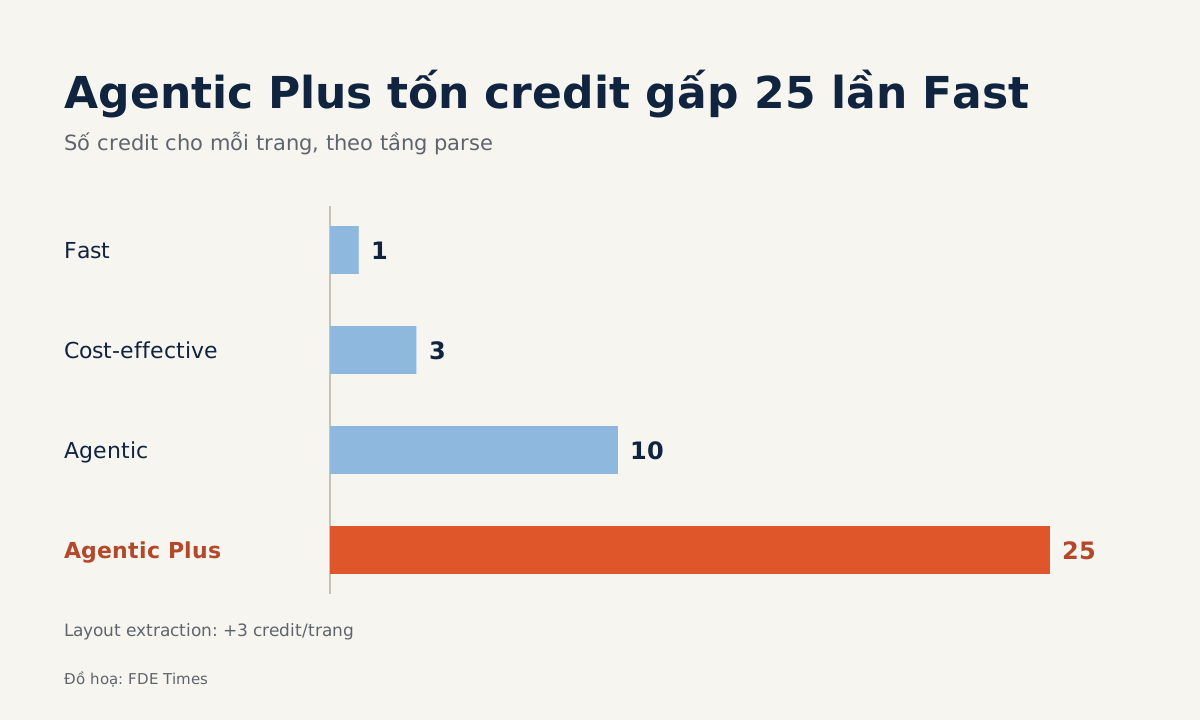
- Parse có bốn tầng là Fast, Cost-effective, Agentic và Agentic Plus, tốn lần lượt 1, 3, 10 và 25 credit mỗi trang.
- Fast không chạy mô hình AI nào, nên không dùng được prompt tùy chỉnh, không đọc được form hay biểu đồ. Docs gọi Agentic là lựa chọn mặc định tốt cho đa số workload.
- Pipe table không biểu diễn được ô gộp. Báo cáo tài chính dày đặc nên chạy Agentic Plus và xuất bảng ra HTML.
Thử hình dung khách đưa bạn một báo cáo tài chính có bảng doanh thu, trong đó tiêu đề “Quý 3” là một ô gộp phủ ba cột. Nếu parser làm phẳng bảng đó thành pipe table, ô gộp sẽ biến mất. Chatbot RAG của bạn khi đó trả lời trơn tru, nhưng số liệu lại gán nhầm cột.
Ví dụ đó cho thấy một câu trả lời sai có thể bắt nguồn từ bước đầu tiên, khi PDF được biến thành text, trước khi mô hình hay vector store kịp làm gì.
LlamaParse là một trong những công cụ được làm riêng cho bước này. Với FDE, câu hỏi đáng hỏi không phải là có nên dùng nó hay không, mà là nên dùng tầng nào cho loại tài liệu nào.
LlamaParse thực ra là gì?
LlamaParse là nền tảng tài liệu dạng hosted do đội LlamaIndex vận hành. Đây là tên mới của LlamaCloud, nhưng package llama-cloud, client và biến môi trường vẫn giữ tên cũ. Chi tiết này nhỏ nhưng dễ làm mất nửa buổi sáng khi bạn đọc docs một đằng còn code import một nẻo.
Trên nền tảng này, Parse là sản phẩm parse tài liệu, được thiết kế cho pipeline LLM. Nó nhận PDF, bản scan, bảng, biểu đồ và trả ra markdown, text hoặc JSON.
Docs ghi Parse hỗ trợ hơn 130 loại file, gồm Office, HTML, ảnh và EPUB. LlamaIndex ra mắt LlamaParse ngày 13/3/2024 và giới thiệu JSON mode là đầu vào cho những ai muốn tự xây chiến lược RAG riêng.
Trang marketing của hãng nói LlamaParse xử lý được chữ viết tay, checkbox, biểu đồ và layout phức tạp. Đó là lời của nhà cung cấp, nên hãy kiểm chứng trên tài liệu thật của khách trước khi hứa với ai.
Bốn tầng, chênh nhau 25 lần
Parse có bốn tầng. Fast rẻ nhất và nhanh nhất, dành cho tài liệu chỉ có chữ với khối lượng lớn. Fast không chạy mô hình AI nào, nên prompt tùy chỉnh, form và trích xuất biểu đồ đều không áp dụng. Docs gọi Agentic là lựa chọn mặc định tốt cho đa số workload, còn Agentic Plus dành cho những tài liệu khó nhất.
Theo bảng giá chính thức, mỗi trang tốn 1 credit ở Fast, 3 ở Cost-effective, 10 ở Agentic và 25 ở Agentic Plus. Bật layout extraction thì cộng thêm 3 credit mỗi trang, ở tầng nào cũng vậy.
Gói pay-as-you-go tính $1,50 cho 1.000 credit, gói miễn phí cho 10.000 credit mỗi tháng. Gói Pro giá $500 mỗi tháng, có sẵn 400.000 credit, dùng quá thì tính $1,25 cho 1.000 credit.
Áp vào một ví dụ: khách có 20.000 trang hợp đồng và báo cáo. Chạy toàn bộ bằng Fast hết 20.000 credit, khoảng $30 theo pay-as-you-go. Chạy toàn bộ bằng Agentic hết 200.000 credit, khoảng $300. Chạy Agentic Plus hết 500.000 credit, khoảng $750.
Ở mức 500.000 credit, gói Pro lại rẻ hơn: $500 cho 400.000 credit đầu, cộng $125 cho 100.000 credit còn lại, tổng khoảng $625. Tính nhẩm, nếu khối lượng của khách lặp lại hằng tháng và vượt khoảng 333.000 credit, Pro bắt đầu rẻ hơn pay-as-you-go, nên hãy đưa cả hai phương án vào bảng báo giá.
Khoảng cách giữa các con số mới là điều cần nhớ. Chạy cả kho bằng một tầng nghĩa là trả giá của trang khó nhất cho cả những trang dễ nhất.
Thử trên trang khó trước, chốt tầng sau
Docs khuyên chọn tầng theo độ khó của bảng: bảng đơn giản thì dùng cost_effective, báo cáo tài chính dày đặc và bảng phức tạp thì dùng agentic_plus. Một cách làm thực tế ở site khách là chia kho tài liệu thành các nhóm, chẳng hạn email và văn bản thuần, hợp đồng nhiều trang, phụ lục tài chính. Nhóm thứ nhất chạy Fast, nhóm cuối chạy Agentic Plus.
Muốn chia nhóm có căn cứ, hãy lấy mẫu. Chọn khoảng 20 trang khó nhất, chạy qua Fast, Agentic và Agentic Plus rồi so output với bản gốc. Phép thử này tốn 20 × (1 + 10 + 25) = 720 credit, chưa tới một phần mười gói miễn phí 10.000 credit mỗi tháng, nên bạn làm được trước khi khách ký bất cứ thứ gì.
Khi so, nhìn thẳng vào bảng. Parse giữ được cấu trúc ô và có thể xuất bảng ra HTML, vì theo docs pipe table đơn giản hơn nhưng không biểu diễn được ô gộp. Nếu bảng của khách có ô gộp, hãy yêu cầu output HTML và kiểm tra lại câu trả lời của RAG trên chính những ô đó.
Những lỗi nào hay làm hỏng báo giá?
Lỗi phổ biến nhất là báo giá theo Fast rồi hứa đọc được biểu đồ. Fast không chạy mô hình AI, nên biểu đồ, form và prompt tùy chỉnh nằm ngoài khả năng của nó; muốn có những thứ đó, bảng giá phải tính theo tầng cao hơn ngay từ đầu.
Lỗi thứ hai nằm trong bảng tính: quên 3 credit mỗi trang khi bật layout extraction. Với Fast, khoản cộng thêm này làm chi phí mỗi trang tăng từ 1 lên 4 credit, tức gấp bốn lần con số bạn đã báo.
Lỗi thứ ba là coi lời marketing như thông số đã kiểm chứng. Khả năng đọc chữ viết tay hay checkbox do hãng tự công bố, nên chỉ đưa vào đề xuất sau khi đã thử trên tài liệu thật của khách.
Còn một câu hỏi không thuộc về kỹ thuật. Đây là nền tảng hosted, nên bạn phải hỏi đội bảo mật của khách xem tài liệu có được phép gửi ra một dịch vụ bên ngoài hay không. Câu hỏi đó nên có mặt ngay trong buổi discovery đầu tiên, đừng để đến tuần thứ ba.
Nên học gì trước?
Hãy học cách đánh giá output parse trước khi học API. Một bộ câu hỏi nhỏ, mỗi câu phụ thuộc vào đúng một ô trong bảng, sẽ cho bạn biết parser có giữ được dữ liệu hay không. Kỹ năng này dùng được với mọi công cụ, không riêng LlamaParse.
Khi đọc tin tuyển dụng FDE, những cụm như “document ingestion” hay “unstructured data” cho thấy công việc sẽ đụng đến đúng bài toán này. Trong CV, đừng chỉ ghi “xây RAG”. Hãy ghi bạn đã chia kho tài liệu theo độ khó, chọn tầng parse cho từng nhóm và đo độ chính xác trên bảng trước và sau khi chọn.
Khách hiếm khi nhớ bạn đã dùng parser nào. Thứ họ nhớ là con số trong câu trả lời có đúng cột hay không.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
7 nguồn
- LlamaParse (formerly LlamaCloud) | Developer Documentation
- Overview of Parse | Developer Documentation
- Parse Getting Started | LlamaParse Developer Documentation
- LlamaIndex Pricing
- Tables | Developer Documentation
- Launching the first GenAI-native document parsing platform · 2024-03-13
- AI Parsing Tool for AI-Ready Document Data | LlamaIndex