Dagster: điều phối pipeline theo bảng dữ liệu tạo ra, không theo bước chạy
Ngày 13/7/2026, Dagster Labs thông báo được Prefect mua lại, nhưng lối nghĩ theo asset mà Dagster theo đuổi vẫn là thứ FDE nên mang theo khi xuống làm ở khách hàng, dù sau này bạn dùng công cụ nào.

Tóm tắt nhanh
- Dagster lấy asset làm trung tâm: mỗi asset được định nghĩa bằng một hàm Python, hàm đó tính ra nội dung của một bảng hoặc một file.
- Lập luận chính của Dagster: orchestrator theo task cho biết pipeline chạy tới đâu, nhưng không cho biết dữ liệu đang ở trạng thái nào.
- Prefect đang mua lại Dagster Labs. Tin tuyển FDE của ServiceNow ghi tên Airflow và Prefect, không ghi Dagster.
Ngày 13/7/2026, Nick Schrock, nhà sáng lập Dagster, viết trên blog công ty rằng Prefect sẽ mua lại Dagster Labs. Hai công cụ vẫn thường được đem ra so sánh với Airflow nay về chung một nhà.
Lúc này đáng hỏi lại: Dagster mang đến ý tưởng gì mà một FDE cần hiểu, dù công cụ đó có còn tồn tại riêng hay không?
Câu trả lời ngắn nằm ở một chữ: asset. Theo tài liệu chính thức, Dagster là một data orchestrator được xây dựng dành cho kỹ sư dữ liệu, có sẵn lineage và observability. Điểm khác không nằm ở danh sách tính năng. Nó nằm ở đơn vị mà công cụ dùng để nhìn pipeline.
Với FDE, chuyện này rất thực tế. Tin tuyển Applied AI FDE của ServiceNow, đăng ngày 21/10/2026, mô tả công việc là xây ứng dụng LLM trải rộng từ backend logic, data orchestration đến giao diện front-end. Orchestration nằm ngay trong phần việc của bạn, không phải việc của một đội nào khác.
Pipeline chạy xanh không có nghĩa là dữ liệu đúng
Blog của Dagster lập luận rằng các orchestrator truyền thống làm việc ở cấp task. Nhờ vậy chúng cho thấy trạng thái pipeline, nhưng không cho thấy trạng thái của những asset bên dưới, tức thứ mà người dùng thật sự quan tâm.
Bài so sánh Dagster với Airflow do chính Dagster viết nói thẳng hơn: Airflow tập trung vào việc chạy task, còn Dagster tập trung vào asset mà các task đó tạo ra.
Bạn cần nhớ đây là góc nhìn của nhà cung cấp, không phải đánh giá trung lập. Theo tài liệu Apache Airflow, Airflow là nền tảng mã nguồn mở để phát triển, lập lịch và giám sát workflow, và nó làm đúng việc đó. Hai cách tiếp cận trả lời hai câu hỏi khác nhau.
Thử hình dung bạn đang deploy một trợ lý LLM cho bộ phận chăm sóc khách hàng của một chuỗi bán lẻ. Trợ lý trả lời dựa trên một bảng tóm tắt đơn hàng được làm mới mỗi đêm.
Một buổi sáng, quản lý hỏi vì sao trợ lý báo sai trạng thái đơn. Trên UI theo task, mọi task đều xanh. Nhưng câu hỏi bạn phải trả lời lại là: bảng tóm tắt đơn hàng được cập nhật lần cuối lúc nào, và từ bản dữ liệu nguồn nào?
Một ví dụ: đổi tên pipeline từ động từ sang danh từ
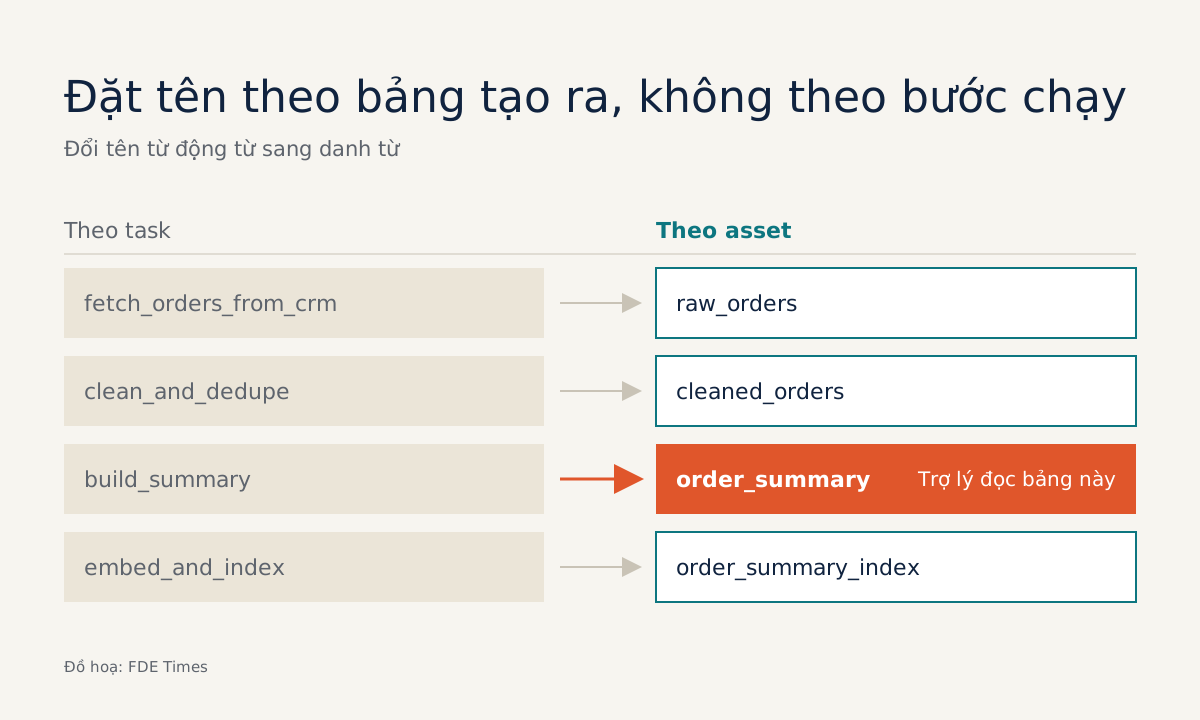
Hướng dẫn “Thinking in Assets” của Dagster khuyên chuyển cách thiết kế từ task sang asset. Quy tắc cụ thể là đặt tên asset theo danh từ, tức đối tượng được tạo ra, chứ không theo bước tính toán. Áp vào pipeline của chuỗi bán lẻ giả định ở trên:
| Tên theo task | Tên theo asset | Câu hỏi mà tên asset giúp trả lời |
|---|---|---|
| fetch_orders_from_crm | raw_orders | Dữ liệu thô về lúc nào? |
| clean_and_dedupe | cleaned_orders | Bảng sạch có mới hơn bảng thô không? |
| build_summary | order_summary | Trợ lý đang đọc phiên bản nào? |
| embed_and_index | order_summary_index | Index có khớp với bảng tóm tắt không? |
Trong Dagster, mỗi dòng ở cột giữa ứng với một hàm Python. Theo tài liệu, hàm này tính ra nội dung của asset, chẳng hạn một bảng trong database hay một file. Nếu một asset cần nhiều bước, decorator @graph_asset cho phép gom một pipeline nhiều bước lại và trình bày nó như một asset duy nhất.
Khi đổi tên như vậy, câu hỏi gỡ lỗi cũng đổi theo. Bạn không còn hỏi “task nào fail” mà hỏi “asset nào cũ hơn asset nó phụ thuộc vào”. Câu thứ hai mới là câu khách hàng thật sự hỏi, dù họ diễn đạt bằng lời khác.
Khi nào nên chọn Dagster ở khách hàng?
Theo logic đó, Dagster phù hợp nhất khi phần lớn công việc là tạo và duy trì bảng: tầng dữ liệu cho RAG, bảng feature, báo cáo mà ứng dụng LLM đọc vào. Nếu khách hàng chủ yếu cần lập lịch các tác vụ không sinh ra dữ liệu, như gọi API, gửi email hay chạy job bảo trì, thì mô hình task của Airflow tự nhiên hơn.
Prefect đi theo hướng thứ ba. Tài liệu của Prefect mô tả nó là orchestration engine mã nguồn mở, biến các hàm Python thông thường thành data pipeline chạy production. Với một FDE cần dựng nhanh một pipeline trong vài tuần ở khách hàng, cách làm ít rào cản này rất đáng giá.
Khác biệt với Dagster nằm ở điểm xuất phát. Theo mô tả của hai bên, với Prefect bạn bắt đầu từ hàm Python có sẵn và biến nó thành pipeline, còn với Dagster bạn bắt đầu từ bảng hay file cần tạo ra rồi viết hàm tính nội dung của nó.
Lời khuyên thực tế: đừng đề xuất đổi orchestrator chỉ vì bạn thích asset. Nếu khách hàng đã chạy Airflow, hãy đặt tên DAG và task theo đầu ra, ghi lại bảng nào phụ thuộc bảng nào, và bạn đã có phần lớn lợi ích của cách nghĩ theo asset mà không phải đụng vào hạ tầng của họ.
Giới hạn và rủi ro cần biết
Rủi ro lớn nhất bây giờ là lộ trình sản phẩm. Khi Prefect mua lại Dagster Labs, bạn nên tìm hiểu kỹ hướng phát triển chính thức trước khi đưa Dagster vào một hệ thống mà khách hàng sẽ phải tự vận hành nhiều năm.
Chỉ báo thứ hai đến từ thị trường việc làm. Tin tuyển FDE của ServiceNow liệt kê Airflow và Prefect bên cạnh MLflow, Kubeflow, SageMaker, Vertex AI, nhưng không có Dagster. Một tin tuyển chỉ là một mẫu nhỏ. Dù vậy, nếu bạn nhắm tới những vị trí tương tự, nên ưu tiên Airflow và Prefect trước.
Nên học gì trước?
Hãy học khái niệm trước, công cụ sau. Nắm chắc Airflow, cái mốc theo task mà cả Dagster lẫn Prefect đều được đem ra so sánh. Viết thử một flow Prefect từ vài hàm Python bạn đã có để thấy cách chúng thành pipeline. Sau đó dựng một dự án Dagster nhỏ với ba hoặc bốn asset để cách nghĩ theo asset thành phản xạ.
Trong CV và khi phỏng vấn, đừng chỉ ghi tên công cụ. Hãy kể pipeline của bạn giữ cho bảng nào luôn mới, ai dùng bảng đó, và bạn phát hiện dữ liệu cũ bằng cách nào. Cách kể như vậy cho thấy bạn nghĩ theo đầu ra mà khách hàng dùng được, chứ không chỉ biết dùng một công cụ.
Bạn đã nghĩ theo asset chưa?
Một bài tự kiểm tra nhanh: mở pipeline gần nhất bạn viết và trả lời trong một phút ba câu. Bảng nào là đầu ra cuối cùng mà người dùng đọc? Nó được cập nhật lần cuối lúc nào? Nó phụ thuộc trực tiếp vào bảng nào?
Nếu phải mở log từng task mới trả lời được, pipeline của bạn vẫn đang được nhìn theo task. Đổi tên theo danh từ và ghi lại quan hệ phụ thuộc là bước đầu tiên để sửa điều đó.
Công cụ có thể đổi chủ, đổi tên hoặc gộp vào nhau. Thói quen hỏi “dữ liệu nào đang đúng” thì bạn mang theo được đến mọi khách hàng.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
9 nguồn
- Overview | Dagster Docs
- Software-Defined Assets Explained · 2025-08-07
- Thinking in Assets When Building Data Pipelines · 2024-02-05
- Dagster vs. Airflow · 2024-09-23
- Defining assets | Dagster Docs
- Apache Airflow Documentation
- Introduction (Prefect docs)
- Prefect is Acquiring Dagster · 2026-07-13
- Forward Deployed Solution Engineer – Applied AI FDE · 2026-10-21