Khách đã chạy Superset? Hãy đo kết quả dự án ngay trên đó
Một metric định nghĩa đúng chỗ giúp con số của bạn đứng vững trong mọi cuộc họp với khách.
Tóm tắt nhanh
- Khách đã chạy Superset thì dashboard đo kết quả nên nằm ở đó, đừng mang thêm công cụ BI mới.
- Định nghĩa metric một lần trong semantic layer, kiểm bằng SQL editor, rồi mới dựng chart no-code.
- Muốn đưa dashboard vào portal của khách thì nhúng bằng iframe, rồi lọc dữ liệu theo người xem bằng guest token có RLS.
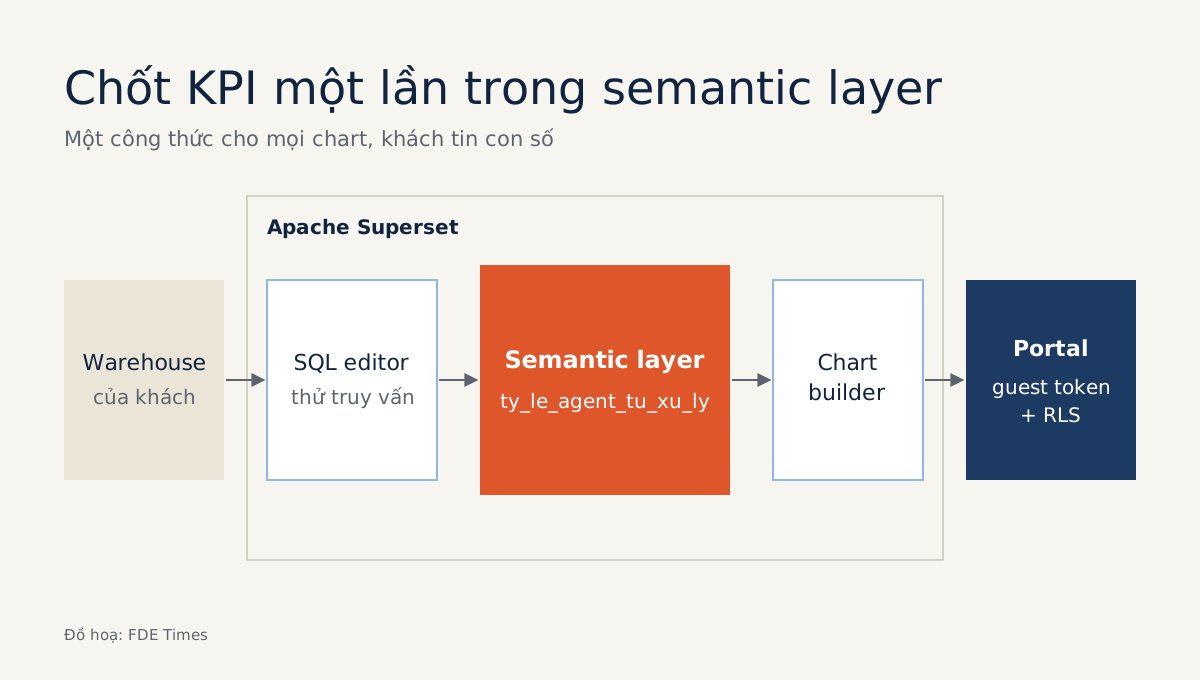
Khi khách hàng đã chạy sẵn Apache Superset, dashboard đo kết quả dự án của bạn nên nằm ngay trên đó. README của dự án viết rằng Superset truy vấn được bất kỳ datastore hay engine nào dùng SQL. Vì thế bạn có thể trỏ nó thẳng vào warehouse khách đang dùng.
Sau khi một agent lên production, khách sẽ muốn biết nó giúp được bao nhiêu. Nếu bạn dựng thêm một công cụ BI thứ hai chỉ để trình bày số của mình, người nghe dễ quay sang hỏi con số đó lấy từ đâu thay vì bàn về kết quả.
Khi dashboard nằm cạnh các báo cáo quen thuộc mà khách mở mỗi sáng, nó được tin hơn ngay từ đầu. Đó là lý do nên học Superset trước khi bước vào một khách hàng đã dùng nó.
Superset cũng không phải công cụ mới toanh. Theo Preset, nó bắt đầu từ một hackathon ở Airbnb mùa hè 2015, và Apache Software Foundation công nhận nó là Top-Level Project ngày 21/1/2021. README hiện gọi nó là một ứng dụng web BI “hiện đại, sẵn sàng cho doanh nghiệp”, phát hành theo giấy phép Apache 2.0.
Superset có những gì đáng để FDE dùng?
Theo README, Superset có chart builder no-code để đội của khách tự dựng biểu đồ, có SQL editor chạy trên web cho những truy vấn phức tạp, và có một semantic layer “nhẹ” để định nghĩa dimension và metric dùng chung. Cả ba đều khớp với việc hằng ngày ở chỗ khách.
Về nguồn dữ liệu, mỗi engine cần có driver Python DB-API và SQLAlchemy dialect. Có những thứ đó rồi, bạn trỏ thẳng vào warehouse sẵn có của khách mà không phải chép dữ liệu đi nơi khác. Dự án cũng có security role cấu hình được, nhiều lựa chọn xác thực và một API để tuỳ biến bằng code.
Ở chỗ khách, nên dùng ba tính năng kia theo thứ tự khác với cách README liệt kê. Dùng SQL editor để kiểm số trước, rồi semantic layer để chốt công thức, và chart builder sau cùng.
Một KPI đi từ SQL đến dashboard
Lấy một ví dụ giả định. Agent của bạn phân loại và tự xử lý ticket hỗ trợ, và khách muốn biết “tỷ lệ ticket agent tự giải quyết”. Bảng tickets trong warehouse có cột resolved_by, nhận giá trị agent hoặc human.
Bắt đầu từ SQL editor: SELECT SUM(CASE WHEN resolved_by = 'agent' THEN 1 ELSE 0 END) * 1.0 / COUNT(*) FROM tickets. Nếu tuần đầu có 1.200 ticket và agent xử lý 420 ticket, kết quả phải ra 0,35, tức 35%. Trước khi tin con số này, hãy lấy 10 dòng ra và đếm tay.
Khi công thức đã đúng, đưa nó vào semantic layer thành một metric có tên rõ ràng, ví dụ ty_le_agent_tu_xu_ly. Từ đó mọi chart đều dùng cùng một định nghĩa, dù bạn dựng hay analyst của khách dựng bằng giao diện no-code.
Chuyện hay gặp ở khâu này: người quản lý lọc bỏ ticket spam, mẫu số thay đổi, và hai dashboard báo hai con số khác nhau.
Vì vậy, việc đầu tiên ở chỗ khách là ngồi với người chủ KPI và chốt ticket nào được tính vào mẫu số. Sau đó ghi đúng điều đó vào metric.
Đưa dashboard vào portal của khách
Nhiều khi khách muốn người dùng của họ xem kết quả ngay trong ứng dụng nội bộ hay portal, không phải đăng nhập Superset. Embedded SDK làm việc này bằng cách chèn một iframe chứa trang Superset vào ứng dụng chủ.
Phần đáng giá nằm ở xác thực. Người xem dashboard nhúng được xác thực bằng guest token, và token có thể mang quy tắc row-level security để lọc dữ liệu theo người cầm nó. Nhờ vậy cả công ty dùng chung một dashboard, nhưng quản lý chi nhánh A chỉ thấy ticket của chi nhánh A.
Một lỗi dễ mắc là chỉ thử dashboard nhúng bằng tài khoản của chính mình, vốn thấy mọi dòng, rồi kết luận RLS đã chạy.
Bài kiểm tra nên làm: phát hai guest token, một cho chi nhánh A và một cho chi nhánh B, mở cùng dashboard bằng từng token.
Sau đó so tổng ticket mỗi bên thấy với truy vấn có điều kiện lọc theo chi nhánh trong SQL editor.
Hãy thiết kế quy tắc RLS cùng đội bảo mật của khách ngay từ đầu. Một dashboard để lộ dữ liệu của chi nhánh khác có thể làm mất niềm tin nhanh hơn một KPI xấu.
Những chỗ Superset không gánh thay bạn
Superset chỉ làm việc với nguồn dữ liệu SQL có driver DB-API và SQLAlchemy dialect. Nếu log của agent đang nằm trong file hoặc trong một hệ thống không dùng SQL, bạn phải đưa chúng vào warehouse trước. Phần pipeline đó là việc của bạn.
Chính dự án gọi semantic layer của mình là “nhẹ”. Vì thế, logic nghiệp vụ phức tạp như loại bỏ ticket trùng hay gán ticket cho đúng phiên bản agent nên được xử lý sẵn trong warehouse thành bảng sạch. Khi đó Superset chỉ còn việc tính tỷ lệ và vẽ chart.
Embedding cũng cần ứng dụng của khách tham gia: phải có chỗ chèn iframe và có cơ chế cấp guest token cho đúng người. Hãy tính phần việc này vào kế hoạch triển khai, đừng hứa “nhúng xong trong một buổi chiều”.
Học gì trước, và ghi gì vào CV
Học theo đúng thứ tự công việc. Trước hết là SQL, đủ chắc để viết công thức tỷ lệ và phép join không bị nhân dòng. Sau đó đến semantic layer, rồi embedding và RLS, còn chart builder học nhanh nhất nên để sau cùng.
Trong CV và khi phỏng vấn, hãy viết cụ thể, ví dụ: “định nghĩa KPI tỷ lệ tự xử lý trong semantic layer của Superset, nhúng dashboard có row-level security vào portal của khách”. Một dòng như vậy cho thấy bạn hiểu cả dữ liệu lẫn khách hàng.
Dự án của bạn chỉ thật sự thành công khi người chủ KPI của khách mở dashboard quen thuộc và thấy một con số tính theo đúng cách họ đã đồng ý.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!