Khách không có Kubernetes, Docker Compose vẫn tự rollback bản lỗi
Một health check, cờ --wait và một nhánh else trong deploy.sh đủ để đưa image cũ lên lại khi bản mới không khỏe kịp hạn.
Tóm tắt nhanh
- --wait chặn lệnh cho tới khi service khỏe, còn --wait-timeout khiến bản lỗi làm lệnh thất bại thay vì treo.
- Health check trả 0 là khỏe, 1 là hỏng; mã 2 bị dành riêng, đừng dùng.
- Muốn không downtime, bạn cần reverse proxy và bỏ container_name, ports khỏi service.
Rất nhiều khách hàng không có Kubernetes. Họ có một con VM, một file compose.yaml, và một người vận hành chỉ biết gõ docker compose up. Khi bản mới hỏng lúc 6 giờ chiều, thứ cứu bạn không phải là một platform, mà là một lệnh deploy biết tự nói “không” rồi tự quay lại bản cũ.
Hướng dẫn này dựng đúng thứ đó. Bạn sẽ có một service app có health check, một job migration chạy trước, và một script deploy.sh nhận hai phiên bản: bản mới và bản cũ. Nếu bản mới không khỏe trong thời hạn, script tự đưa bản cũ lên lại.
Bạn cần Docker có plugin Compose, một ứng dụng web nhỏ có endpoint /health, và hai tag image khác nhau của nó, ví dụ v1 và v2. Mọi lệnh bên dưới đều chạy được trên laptop trước khi bạn mang tới máy khách hàng.
Health check phải nói đúng ngôn ngữ của Docker
Docker đọc mã thoát của lệnh kiểm tra: 0 nghĩa là container khỏe và sẵn sàng, 1 nghĩa là không khỏe, còn 2 được dành riêng. Theo mặc định, --retries bằng 3, tức container chỉ bị đánh dấu unhealthy sau ba lần thất bại liên tiếp.
Bước 1. Thêm vào Dockerfile của ứng dụng:
# Giả định image có curl và app lắng nghe cổng 8080
HEALTHCHECK --retries=3 CMD curl -f http://localhost:8080/health || exit 1
Đoạn || exit 1 không phải trang trí. Nhiều công cụ trả về mã lỗi tùy ý khi thất bại; ép về 1 giúp bạn không bao giờ vô tình trả mã 2, mã mà Docker không coi là trạng thái hợp lệ.
Kiểm tra: build image, chạy container, rồi xem cột STATUS trong docker ps. Sau đó thử tắt endpoint /health và chờ: container phải chuyển sang unhealthy sau ba lần kiểm tra hỏng.
Một điểm hay bị bỏ qua: endpoint /health nên kiểm tra thứ mà ứng dụng thực sự cần, như kết nối database. Một /health lúc nào cũng trả 200 sẽ để bản lỗi lọt qua cổng mà không ai hay.
Thứ tự khởi động là một phần của deploy
Compose có thể giữ một service lại cho tới khi health check của service phụ thuộc vượt qua, bằng depends_on với condition: service_healthy. Với job chạy một lần như migration, điều kiện service_completed_successfully yêu cầu job đó chạy xong thành công rồi service sau mới được khởi động.
Bước 2. Một compose.yaml rút gọn:
services:
  db:
    image: postgres:16
    healthcheck:
      test: ["CMD", "pg_isready"]   # rút gọn, chỉnh theo DB của bạn
  migrate:
    image: myapp:${APP_VERSION}
    command: ["./migrate"]
    depends_on:
      db:
        condition: service_healthy
  app:
    image: myapp:${APP_VERSION}
    depends_on:
      migrate:
        condition: service_completed_successfully
Phần ${APP_VERSION} là giả định đơn giản hóa: tag image được truyền qua biến môi trường. Lệnh ./migrate cũng là tên minh họa, bạn thay bằng lệnh migration thật.
Kiểm tra: chạy APP_VERSION=v1 docker compose up và quan sát log. migrate chỉ chạy sau khi db khỏe, còn app chỉ lên sau khi migrate thoát thành công. Nếu bạn sửa migrate cho thoát lỗi, app sẽ không được khởi động.
Cổng deploy nằm trong hai cờ
Cờ --wait khiến docker compose up chặn lại cho tới khi các service ở trạng thái running hoặc healthy, và nó ngầm bật chế độ detached, nên bạn không cần thêm -d. Cờ --wait-timeout đặt số giây tối đa phải chờ, nhờ vậy một bản lỗi làm lệnh thất bại thay vì treo vô hạn.
Hai cờ này biến một lệnh khởi động thành câu hỏi có/không mà shell hiểu được qua mã thoát. Thêm --no-deps để chỉ cập nhật app mà không động tới các service liên kết như db.
Bước 3. Tạo deploy.sh:
#!/usr/bin/env bash
set -u
NEW="$1"   # ví dụ v2
OLD="$2"   # ví dụ v1

if APP_VERSION="$NEW" docker compose up --wait --wait-timeout 90 --no-deps app; then
  echo "Deployed $NEW"
else
  echo "$NEW unhealthy, rolling back to $OLD"
  APP_VERSION="$OLD" docker compose up --wait --wait-timeout 90 --no-deps app
fi
Rollback giờ đúng là một lệnh: ./deploy.sh v2 v1. Bạn không cần nhớ gì lúc nửa đêm, chỉ cần biết tag nào đang chạy ổn.
Kiểm tra: build một tag v2-broken có /health luôn hỏng, rồi chạy ./deploy.sh v2-broken v1. Lệnh đầu phải thất bại sau tối đa 90 giây, dòng rollback phải in ra, và docker ps phải cho thấy app chạy lại image v1 ở trạng thái healthy.
Con số 90 giây không nên chọn bừa
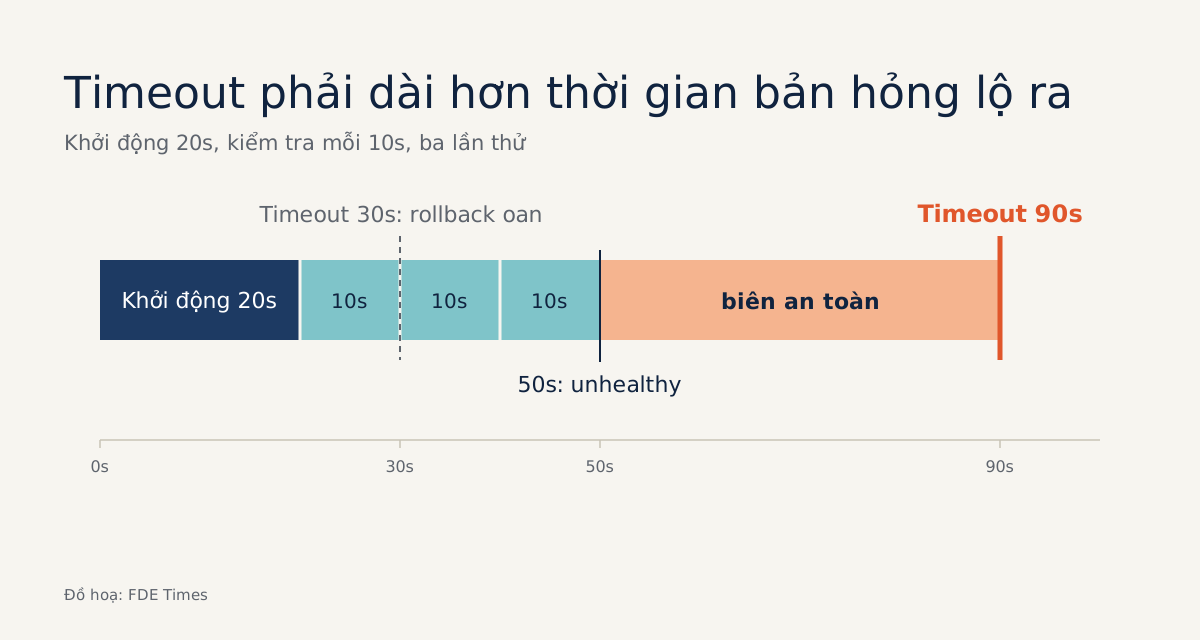
Thử làm một phép tính. Giả sử ứng dụng mất khoảng 20 giây để khởi động và mỗi lần kiểm tra cách nhau 10 giây. Với ba lần thử mặc định, bản hỏng cần khoảng 20 + 3 × 10 = 50 giây để bị đánh dấu unhealthy.
Nếu bạn đặt --wait-timeout 30, cả bản tốt khởi động chậm cũng có thể bị coi là lỗi và bị rollback oan. Nếu đặt 600, mỗi lần deploy hỏng khách hàng phải chờ mười phút mới thấy bản cũ quay lại. Hãy đo thời gian khởi động thật trên máy của khách, rồi đặt timeout cao hơn tổng ở trên một khoảng an toàn.
Còn một bẫy nữa ở --no-deps: vì nó không động tới service liên kết, migrate sẽ không chạy trong script này. Hãy chạy migration như một bước riêng trước khi deploy, và viết migration tương thích ngược, vì rollback image không tự rollback schema. Bản v1 phải chạy được trên database mà v2 đã migrate.
Muốn không downtime thì phải có hai bản cùng chạy
Script trên chỉ trả lời câu hỏi bản mới có khỏe hay không; nó không hứa rằng bản cũ vẫn phục vụ trong lúc bản mới khởi động.
Đặc tả deploy của Compose phân biệt hai thứ tự cập nhật: stop-first dừng bản cũ trước, còn start-first cho bản mới lên trước để hai bản chạy chồng nhau một lúc.
Muốn người dùng không thấy khoảng trống nào, bạn cần kiểu thứ hai: hai container cùng sống trong lúc chuyển giao.
Cờ --scale ghi đè thiết lập scale trong file Compose, cho phép chạy nhiều instance của một service cạnh nhau. Công cụ cộng đồng docker-rollout, một plugin CLI cho Docker, tự động hóa đúng ý tưởng đó: nó tăng gấp đôi số instance, chờ bản mới lên, rồi gỡ các bản cũ.
Nhưng nó đi kèm ràng buộc: service không được khai báo container_name hay ports trong file Compose, và bạn cần một reverse proxy để chia traffic giữa container cũ và mới.
Ràng buộc này có lý do: hai container không thể cùng giữ một cổng cố định trên host, cũng không thể cùng mang một tên. Vì thế proxy giữ cổng công khai, còn container phía sau được tạo mới hay gỡ đi mà người dùng không hề hay biết.
Đặc tả Compose còn có rollback dạng khai báo
Đặc tả deploy của Compose mô tả sẵn hành vi này theo kiểu khai báo. Khối rollback_config định nghĩa cách service được rollback khi một lần cập nhật thất bại. Trong update_config, failure_action nhận một trong ba giá trị continue, rollback hoặc pause, còn order chọn giữa stop-first và start-first như đã nói ở trên.
services:
  app:
    deploy:
      update_config:
        failure_action: rollback
        order: start-first
Đây là cấu hình rút gọn. Trước khi dựa vào nó, hãy kiểm tra công cụ đang chạy file Compose ở máy khách có thực thi các khối deploy này hay không. Nếu không chắc, script deploy.sh ở trên là phương án minh bạch hơn, vì bạn nhìn thấy từng bước nó làm.
Mang quy trình này tới máy của khách hàng
Tình huống điển hình của một FDE là một server on-prem hoặc một VM trong cloud của khách, nơi đội IT không cho cài thêm orchestrator. Bạn giao một repo có compose.yaml, một deploy.sh, và một trang README ghi rõ: tag nào đang chạy, cách deploy, và lệnh rollback. Người vận hành của khách phải tự làm được mà không cần gọi bạn.
Việc đầu tiên nên làm ở khách hàng là hỏi xem /health của ứng dụng kiểm tra những gì, rồi đo thời gian khởi động thật trên máy của họ. Hai thông tin đó quyết định bản lỗi có bị chặn hay lọt qua cổng.
Nếu bạn đang ứng tuyển vị trí FDE, đừng ghi “biết Docker” trong CV. Hãy viết một dòng cụ thể hơn, chẳng hạn: dựng quy trình deploy bằng Compose với health check, timeout và tự rollback cho môi trường không có Kubernetes. Kèm một repo nhỏ có kịch bản v2-broken để nhà tuyển dụng tự chạy và thấy rollback hoạt động.
Khách hàng hiếm khi nhớ bản deploy suôn sẻ. Họ sẽ nhớ cái lần bản lỗi lên production và ba phút sau hệ thống đã tự về lại bản cũ.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!