Thực hành: viết script Python biến file OpenAPI của khách thành tool definition cho Claude và OpenAI
Chỉ cần một lệnh là script sinh xong bản nháp bộ tool, còn phần tốn công là chọn endpoint nào đáng đưa cho agent và viết mô tả đủ rõ để model gọi đúng.
Tóm tắt nhanh
- operationId là ứng viên tự nhiên cho tên tool, nhưng script vẫn phải tự đặt tên khi spec thiếu hoặc trùng operationId.
- Mô tả là yếu tố quan trọng nhất với hiệu năng tool, nên script phải lấy cả summary lẫn description và đánh dấu những tool còn trống mô tả.
- Sinh tự động chỉ là bản nháp: cần lọc xuống ít tool và gộp các thao tác liên quan trước khi đưa cho agent.
Ngày đầu tại khách hàng, thứ bạn thường nhận được là đường link tới một file openapi.json có vài trăm endpoint, kèm yêu cầu “cho agent dùng được hệ thống này”. Gõ tay từng tool definition thì mất cả tuần và rất dễ sai. Một script Python khoảng một trăm dòng làm được bản nháp chỉ bằng một lệnh.
Nhưng bản nháp không phải sản phẩm. Bài của Anthropic Engineering cảnh báo một lỗi hay gặp là tool chỉ bọc lại nguyên các endpoint API có sẵn. Vì thế, script trong bài chỉ nhận phần việc lặp đi lặp lại: gỡ $ref, gom tham số, đặt tên tool, để thời gian của bạn dành cho việc chọn endpoint và viết mô tả.
Bạn sẽ xây: script gen_tools.py. Nó đọc spec OpenAPI 3.x dạng JSON và xuất hai danh sách tool, một theo định dạng Claude (name, description, input_schema) và một theo định dạng function calling của OpenAI (type, name, description, parameters). Bạn cần: Python 3 và một file spec. Spec dạng YAML thì chuyển sang JSON trước. Script chỉ dùng thư viện chuẩn.
Bước 1–2: đọc spec và gỡ hết $ref
Theo đặc tả OpenAPI 3.1.0, $ref là một URI trỏ tới giá trị được tham chiếu. LLM không đi theo được con trỏ đó. Schema gửi cho model phải là bản đã “trải phẳng”, nên việc đầu tiên là resolve.
import json, re, sys

HTTP_METHODS = {"get", "post", "put", "patch", "delete"}

def load_spec(path):
    with open(path, encoding="utf-8") as f:
        return json.load(f)

def resolve(node, spec, seen=()):
    # Đơn giản hóa: chỉ xử lý $ref nội bộ dạng "#/components/..."
    if isinstance(node, dict):
        ref = node.get("$ref")
        if isinstance(ref, str) and ref.startswith("#/"):
            if ref in seen:
                return {"description": f"(schema đệ quy tại {ref})"}
            target = spec
            for part in ref[2:].split("/"):
                target = target[part.replace("~1", "/").replace("~0", "~")]
            return resolve(target, spec, seen + (ref,))
        return {k: resolve(v, spec, seen) for k, v in node.items()}
    if isinstance(node, list):
        return [resolve(x, spec, seen) for x in node]
    return node
Kiểm tra: in ra một operation có body phức tạp sau khi resolve. Nếu còn sót chuỗi "$ref" thì đó là tham chiếu tương đối sang file khác. Đặc tả cho phép kiểu tham chiếu này, nhưng phiên bản rút gọn ở đây chưa xử lý.
Biến seen chặn vòng lặp vô hạn khi schema tự trỏ về chính nó, chẳng hạn một Category có danh sách children cũng là Category.
Bước 3: gộp tham số từ nhiều chỗ về một schema
OpenAPI đặt tham số ở bốn vị trí: query, header, path và cookie. Còn dữ liệu gửi lên nằm riêng trong requestBody. Phía Claude chỉ có một input_schema, tức một JSON Schema duy nhất mô tả các tham số mà tool chờ nhận, nên script phải gom tất cả về một object.
SKIP_IN = {"header", "cookie"}  # auth do code của bạn gắn, không để model điền

def build_input_schema(op, path_item):
    props, required = {}, []
    params = path_item.get("parameters", []) + op.get("parameters", [])
    for p in params:
        if p.get("in") in SKIP_IN:
            continue
        schema = dict(p.get("schema", {}))
        if p.get("description"):
            schema["description"] = p["description"]
        props[p["name"]] = schema
        if p.get("required"):
            required.append(p["name"])
    body = op.get("requestBody", {})
    content = body.get("content", {}).get("application/json", {})
    if "schema" in content:
        props["body"] = content["schema"]
        if body.get("required"):
            required.append("body")
    return {"type": "object", "properties": props, "required": required}
Có hai quyết định ở đây đáng cân nhắc lại khi đứng trước hệ thống thật. Bỏ qua header và cookie là có chủ đích: token xác thực nên do code phía bạn gắn vào, đừng để model điền.
Quyết định thứ hai là cách xử lý trùng tên. Thử hình dung endpoint PATCH /orders/{id} có id ở path, và body cũng có một trường id: gói body vào khóa body giúp hai trường không đè nhau. Anthropic Engineering khuyên tên tham số phải rõ ràng, không mơ hồ, nên nếu spec đặt tên kiểu q hay p1, bạn nên đổi tên ngay ở bước này.
Bước 4: tên tool phải hợp lệ, mô tả không được bỏ trống
Claude yêu cầu name khớp regex ^[a-zA-Z0-9_-]{1,128}$. Theo đặc tả OpenAPI 3.1.0, operationId phải duy nhất trong toàn bộ API, nên đây là ứng viên tự nhiên cho tên tool. Tuy vậy, Redocly nhắc rằng công cụ dựa vào operationId để nhận diện operation, và spec ngoài thực tế thường thiếu hoặc trùng trường này, nên script cần phương án dự phòng.
NAME_RE = re.compile(r"^[a-zA-Z0-9_-]{1,128}$")

def tool_name(op, method, path, used, prefix):
    raw = op.get("operationId") or f"{method}_{path}"
    name = (prefix + re.sub(r"[^a-zA-Z0-9_-]+", "_", raw).strip("_"))[:128]
    base, i = name, 2
    while name in used:
        suffix = f"_{i}"
        name = base[:128 - len(suffix)] + suffix
        i += 1
    assert NAME_RE.match(name), name
    used.add(name)
    return name

def tool_description(op, method, path):
    text = " ".join(s.strip() for s in (op.get("summary"), op.get("description")) if s)
    return text or f"Gọi {method.upper()} {path}. CẦN VIẾT MÔ TẢ."
prefix đi theo khuyến nghị của Anthropic: đặt tiền tố theo dịch vụ, ví dụ crm_ hay billing_, để model phân biệt được tool khi agent nối với nhiều hệ thống cùng lúc. Riêng phần mô tả, tài liệu của Anthropic gọi đây là yếu tố quan trọng nhất, bỏ xa mọi thứ khác, với hiệu năng của tool, và khuyên viết tối thiểu 3–4 câu cho mỗi tool.
Spec của khách hiếm khi đạt mức đó. Chuỗi CẦN VIẾT MÔ TẢ được cài vào để bạn grep ra và không gửi nhầm một tool mô tả trống lên production.
Bước 5: một nguồn, hai định dạng đầu ra
Function calling của OpenAI dùng type, name, description, parameters và strict. Cùng một schema đã chuẩn bị ở trên có thể xuất ra cả hai định dạng mà không phải tính lại gì.
def main(spec_path, prefix="", allow=None):
    spec = load_spec(spec_path)
    used, claude, openai, strict_candidates = set(), [], [], []
    for path, item in spec.get("paths", {}).items():
        item = resolve(item, spec)
        for method, op in item.items():
            if method not in HTTP_METHODS:
                continue
            if allow and op.get("operationId") not in allow:
                continue
            name = tool_name(op, method, path, used, prefix)
            desc = tool_description(op, method, path)
            schema = build_input_schema(op, item)
            claude.append({"name": name, "description": desc, "input_schema": schema})
            openai.append({"type": "function", "name": name,
                           "description": desc, "parameters": schema})
            # Kiểm tra một phần: chỉ xét lớp ngoài cùng, chưa xét schema lồng trong body
            if set(schema["required"]) == set(schema["properties"]):
                strict_candidates.append(name)
    json.dump({"claude": claude, "openai": openai}, sys.stdout,
              ensure_ascii=False, indent=2)
    print("Ứng viên strict, cần kiểm tra thêm:", strict_candidates, file=sys.stderr)

if __name__ == "__main__":
    allow = set(sys.argv[3].split(",")) if len(sys.argv) > 3 else None
    main(sys.argv[1], sys.argv[2] if len(sys.argv) > 2 else "", allow)
python3 gen_tools.py openapi.json crm_ listOrders,getOrder,updateOrder > tools.jsonKiểm tra: đếm số tool trong tools.json, số tool bị gắn cờ thiếu mô tả và danh sách ứng viên strict in ra stderr. Bước tiếp theo cho bạn thấy một tool cụ thể trông ra sao.
Bước 6: theo một operation từ spec đến JSON
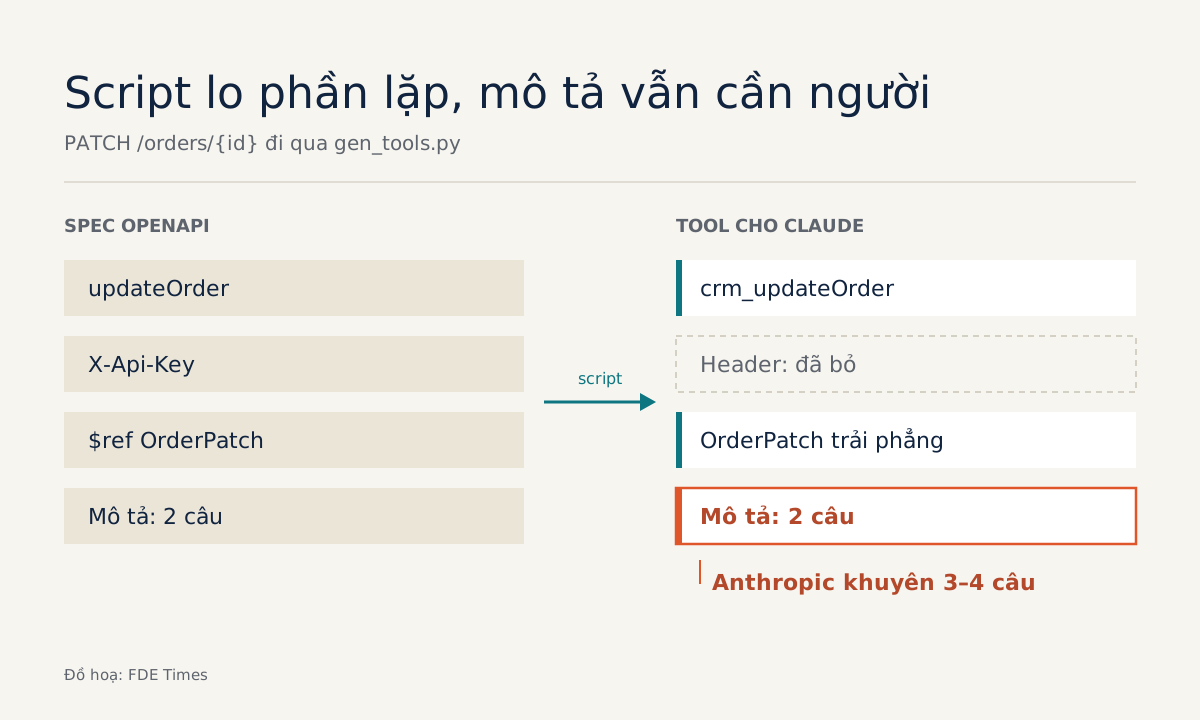
Lấy một spec giả định để thử. Endpoint PATCH /orders/{id} có operationId là updateOrder, một tham số path và body trỏ tới schema OrderPatch:
"/orders/{id}": {
  "patch": {
    "operationId": "updateOrder",
    "summary": "Update an order.",
    "description": "Changes the status or adds an internal note.",
    "parameters": [
      {"name": "id", "in": "path", "required": true,
       "description": "Order ID", "schema": {"type": "string"}},
      {"name": "X-Api-Key", "in": "header", "required": true,
       "schema": {"type": "string"}}
    ],
    "requestBody": {"required": true, "content": {"application/json": {
      "schema": {"$ref": "#/components/schemas/OrderPatch"}}}}
  }
}
Trong components/schemas, giả sử OrderPatch là một object có hai trường không bắt buộc: status (string, enum pending, shipped, refunded) và note (string). Chạy script với tiền tố crm_, phần tử tương ứng trong mảng claude sẽ là:
{
  "name": "crm_updateOrder",
  "description": "Update an order. Changes the status or adds an internal note.",
  "input_schema": {
    "type": "object",
    "properties": {
      "id": {"type": "string", "description": "Order ID"},
      "body": {
        "type": "object",
        "properties": {
          "status": {"type": "string", "enum": ["pending", "shipped", "refunded"]},
          "note": {"type": "string"}
        }
      }
    },
    "required": ["id", "body"]
  }
}
Phần tử trong mảng openai mang cùng name, description và schema, chỉ khác vỏ: có thêm "type": "function" và schema nằm dưới khóa parameters thay vì input_schema.
Đọc output này, bạn kiểm được bốn điều. $ref đã biến mất và OrderPatch được chép thẳng vào body. Header X-Api-Key không xuất hiện, đúng như chủ ý. Mô tả của tham số id đã được chuyển vào schema của nó.
Điều thứ tư là mô tả tool mới có hai câu, thấp hơn mức 3–4 câu Anthropic khuyên. Một bản viết lại tốt sẽ nói khi nào nên gọi tool này, giá trị status nào dẫn tới hệ quả gì và tool không làm được gì.
Vì sao script không tự bật strict
Tool trên lọt vào danh sách ứng viên strict, vì ở lớp ngoài required khớp đúng properties. Nhưng bên trong body, cả status lẫn note đều không có trong required, trong khi strict mode của OpenAI đòi mọi trường trong properties phải được đánh dấu required. Phép so sánh trong code chỉ xét lớp ngoài cùng, nên không thấy được lỗi này.
Vì vậy hãy coi danh sách ứng viên là điểm bắt đầu.
Trường tùy chọn như note thì bạn phải tự chuyển đổi trước khi thêm "strict": true bằng tay.
Phía Claude đơn giản hơn: đặt strict: true trên tool definition để bật kiểm tra schema. Nếu muốn sinh input_examples từ trường example trong spec, hãy validate từng ví dụ với input_schema trước khi gửi, vì ví dụ không hợp lệ khiến API trả lỗi 400.
Bẫy lớn nhất là sinh quá nhiều tool
Chạy không có allowlist trên một spec trăm endpoint, bạn sẽ có trăm tool. OpenAI khuyên nên có dưới 20 function ở đầu mỗi lượt. Đây là hướng dẫn mềm, nhưng có lý do: Anthropic cũng cho rằng ít tool mà mỗi tool làm được nhiều việc hơn thì model ít phân vân khi chọn.
Vì vậy tham số allow không phải tính năng phụ, mà là phần việc chính. Thử hình dung khách cần agent xử lý yêu cầu hoàn tiền: ba operation tra đơn, xem chi tiết và cập nhật đơn là đủ, cộng thêm một tool gộp nếu quy trình luôn đi theo một thứ tự cố định.
Còn vài lỗi khác hay gặp. Có người để header xác thực lọt vào schema. Có người gửi đi tool mô tả trống. Có người tin operationId luôn duy nhất mà không chạy kiểm tra.
Tại khách hàng, trước khi viết dòng code nào, hãy hỏi ai sở hữu spec và spec có khớp với API đang chạy hay không. Chạy linter như Redocly để bắt operationId trùng sẽ cho bạn biết nhanh spec đáng tin đến đâu.
Nếu muốn đưa kỹ năng này vào CV, đừng ghi kiểu “tích hợp OpenAPI với LLM”. Hãy ghi rằng bạn rút một spec từ hàng trăm endpoint xuống một bộ tool nhỏ, kèm mô tả tự viết và bộ kiểm tra schema, rồi đặt script lên GitHub chạy trên một spec công khai.
Khi đi phỏng vấn FDE, hãy kể bạn đã cắt bớt những tool nào và vì sao, thay vì chỉ khoe đã sinh ra bao nhiêu tool.
Chạy script chỉ tốn một lệnh. Phần công việc khách thật sự trả tiền là buổi chiều tiếp theo, khi bạn quyết định giữ lại tool nào.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!