Hỏi năm người dữ liệu nằm ở đâu, nhận về năm câu trả lời
Bảng kiểm kê dựng trong bảy bước ở tuần đầu, chỉ với quyền read-only, ghi rõ chủ sở hữu, lineage và ràng buộc của từng nguồn trước khi viết pipeline hay agent.
Tóm tắt nhanh
- Giai đoạn đầu chỉ cần 7 trường tối thiểu. Riêng cột chủ sở hữu phải ghi tên một người cụ thể.
- Với mỗi nguồn, ghi rõ batch hay stream, có hỗ trợ CDC không và độ nhạy cảm đến đâu, vì đây là ba thứ quyết định cách thiết kế pipeline.
- Bảng kiểm kê cần lịch đối soát định kỳ, tối thiểu mỗi quý ở giai đoạn đầu, kèm tên người phía khách chịu trách nhiệm sau khi bàn giao.
Tuần đầu ở khách hàng, nếu bạn hỏi năm người “dữ liệu khách hàng nằm ở đâu”, rất có thể bạn sẽ nhận về năm câu trả lời khác nhau. Mỗi người đều đúng một phần, nhưng không ai nắm được toàn bộ.
Việc đầu tiên nên làm là gom năm câu trả lời đó vào một file mà cả nhóm khách hàng cùng xác nhận. IBM định nghĩa data ingestion là quá trình thu thập dữ liệu từ nhiều nguồn để lưu trữ, xử lý và phân tích. Không thể thu thập một nguồn mà chưa ai liệt kê ra.
Vì thế, bảng kiểm kê nguồn dữ liệu là nền của mọi thứ xây sau đó, từ pipeline, dashboard cho đến agent. Bảy bước dưới đây dựng bảng từ con số không, và đi theo một khách hàng giả định từ đầu đến cuối để thấy bảng được lấp đầy dần.
Bạn sẽ có gì vào cuối tuần?
Kết quả là một bảng tính, hoặc một file CSV trong repo dự án, mỗi dòng ứng với một nguồn dữ liệu. Hướng dẫn về data discovery của GeekyAnts đặt đích đến là một bảng kiểm kê đầy đủ, đáng tin, trong đó mỗi nguồn có chủ sở hữu, lineage và ràng buộc khi sử dụng.
Bạn chỉ cần chuẩn bị ba thứ: một nơi lưu file mà cả hai bên cùng xem được, danh sách người liên hệ phía khách, và quyền đọc vào các hệ thống được phép xem. Trong tuần đầu, chỉ nên xin quyền read-only: bạn đang đi quan sát, chưa phải lúc sửa gì.
Khách hàng xuyên suốt là một chuỗi bán lẻ giả định, với ba nguồn: hệ thống POS ở cửa hàng, một CRM và một form khảo sát do phòng marketing tự tạo. Mọi dòng dữ liệu bên dưới đều là minh họa.
Bước 1: bắt đầu bằng ít cột
Sáng thứ Hai, giám đốc vận hành của chuỗi bán lẻ gửi bạn danh sách “các hệ thống chính”, gồm đúng hai cái tên: POS và CRM. Bạn sẽ muốn mở sheet và thêm thật nhiều cột ngay, nhưng nên kiềm chế.
Theo IF4IT, bản ghi ban đầu chỉ cần bảy trường: ID, tên hiển thị, mô tả, cấu trúc, loại dữ liệu, domain và phân loại độ nhạy cảm. Ngoài bảy trường đó, hãy thêm vài cột phục vụ trực tiếp công việc triển khai và để trống chúng cho đến khi có thông tin.
id,ten,mo_ta,cau_truc,loai,domain,do_nhay_cam,chu_so_huu,kieu_ingest,ho_tro_cdc,lineage,rang_buoc_su_dung,so_nhom_ingest,ghi_chu_chat_luong,rui_ro_schema_driftSau ngày thứ nhất, bảy cột đầu trông như sau:
id,ten,mo_ta,cau_truc,loai,domain,do_nhay_cam
SRC-001,Đơn hàng POS,Giao dịch tại quầy,bảng quan hệ,giao dịch,bán lẻ,chưa phân loại
SRC-002,CRM khách hàng,Hồ sơ và lịch sử liên hệ,bản ghi có trường tùy chỉnh,khách hàng,marketing,chưa phân loại
Kiểm tra trước khi sang bước sau: sáu cột đầu phải điền được cho mọi dòng, cột độ nhạy cảm tạm ghi “chưa phân loại” đến Bước 5. Nguồn nào không mô tả nổi trong một câu là nguồn bạn chưa hiểu; hãy đánh dấu lại để hỏi.
Bước 2: quét theo nhóm nguồn, đừng chỉ dựa vào trí nhớ
Danh sách hai hệ thống của giám đốc vận hành gần như chắc chắn thiếu. Để không bỏ sót, hãy dùng bốn nhóm nguồn điển hình mà Qlik liệt kê làm checklist khi phỏng vấn: cơ sở dữ liệu, thiết bị IoT, ứng dụng SaaS và data lake. Với mỗi phòng ban, hỏi lần lượt từng nhóm.
Hãy hỏi kỹ nhóm SaaS, vì một công cụ do phòng ban tự đăng ký có thể không nằm trong danh sách hệ thống bạn được cấp quyền quét. Ở chuỗi bán lẻ, form khảo sát chỉ lộ ra khi bạn hỏi phòng marketing “các bạn còn dùng ứng dụng SaaS nào khác không?”, và bảng có thêm dòng SRC-003,Form khảo sát.
Với những hệ thống đã được cấp quyền, đừng gõ tay. GeekyAnts khuyên dùng công cụ để dựng catalog ban đầu, theo tỷ lệ khoảng 80% tự động, 20% thủ công. Công cụ quét lo phần đọc được từ hệ thống, như tên, cấu trúc, loại dữ liệu.
Phần thủ công là những thứ máy không tự biết, như ai chịu trách nhiệm hay nguồn được dùng vào việc gì, và chỉ lấy được qua phỏng vấn.
Bước 3: mỗi dòng phải có tên một người
Hỏi “ai lo CRM?”, bạn nhận được câu trả lời “bên IT”. Đó chưa phải câu trả lời. IF4IT yêu cầu mỗi bản ghi có Owner và Steward riêng, và bản thân bảng kiểm kê cũng phải có một chủ sở hữu có tên. Ghi “phòng IT” hay “team data” thì cũng như chưa ghi gì.
id,chu_so_huu
SRC-001,Nguyễn Văn A
SRC-002,Trần Thị B
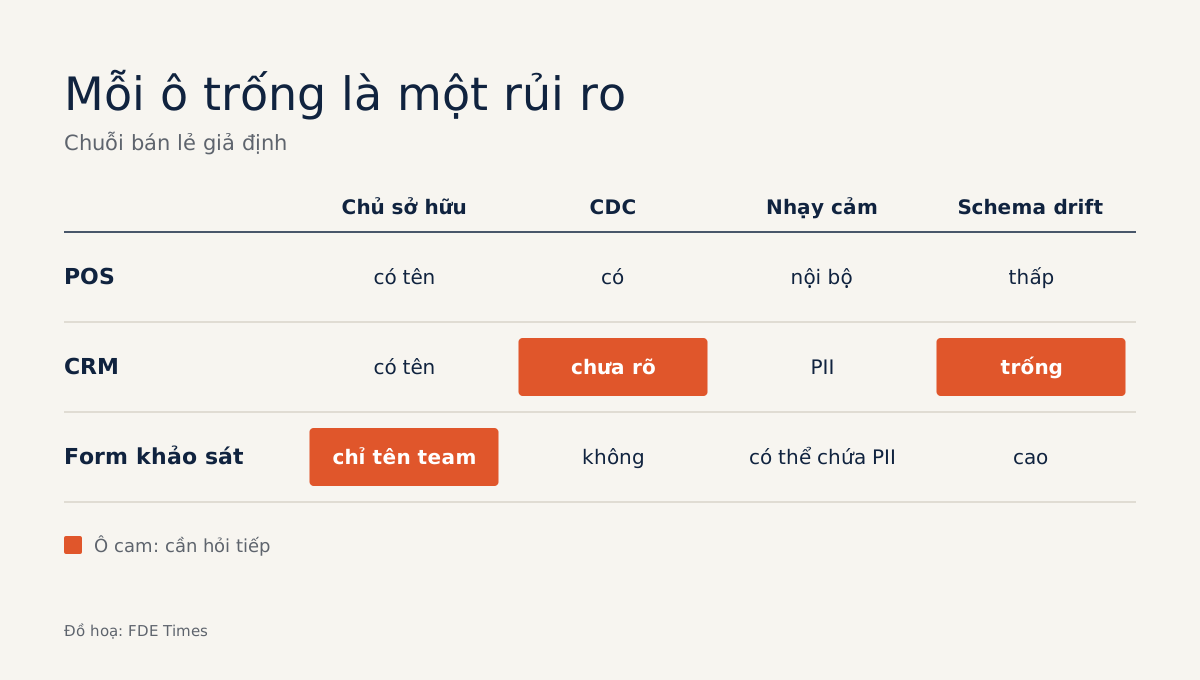
SRC-003,team marketingKiểm tra: lọc cột chu_so_huu và đếm số ô trống hoặc ô chỉ ghi tên nhóm. Ở ví dụ trên, SRC-003 chưa đạt. Biến những dòng như vậy thành danh sách câu hỏi để mang vào buổi họp với người bảo trợ dự án phía khách.
Bước 4: batch hay stream, có CDC không?
POS đẩy giao dịch về kho trung tâm gần như ngay lập tức, còn CRM chỉ xuất file mỗi đêm. Hai nguồn này cần hai kiểu pipeline khác nhau. IBM phân biệt ingest theo lô (batch), gom dữ liệu rồi xử lý một lượt, với ingest thời gian thực, xử lý ngay khi dữ liệu được sinh ra.
Cột kieu_ingest vì thế sẽ quyết định phần lớn thiết kế sau này. Bên cạnh đó, hãy ghi nguồn nào hỗ trợ CDC, tức cơ chế theo dõi transaction log để chỉ chuyển phần dữ liệu thay đổi sang hệ đích, như Qlik mô tả:
id,kieu_ingest,ho_tro_cdc,lineage
SRC-001,stream,có,POS -> kho trung tâm
SRC-002,batch,chưa rõ,CRM -> file xuất hằng đêm
SRC-003,batch,không,form -> file CSV tải tay
Ô “chưa rõ” không phải lỗi. Đó là một câu hỏi nữa cho người có tên ở Bước 3.
Bước 5: gắn nhãn độ nhạy cảm cho mọi nguồn
Đồng nghiệp phía khách đề nghị gửi bạn “một file CRM mẫu để test cho nhanh”. Đừng nhận vội. Theo IBM, dữ liệu càng bị phơi ra nhiều trong quá trình ingest thì nguy cơ lộ dữ liệu nhạy cảm càng cao, nên cột do_nhay_cam là bắt buộc, kể cả với nguồn trông vô hại.
GeekyAnts khuyên gắn nhãn độ nhạy cảm cho mọi dataset và chạy công cụ tự động dò PII/PHI, kèm rà soát thủ công. Ở ví dụ, POS chỉ là “nội bộ”, CRM chứa số điện thoại và email nên là “PII”, còn form khảo sát có ô tự nhập nên tạm xếp “có thể chứa PII”.
Hãy làm bước này trước khi copy bất kỳ dữ liệu nào ra môi trường dev, chứ không phải sau. Đến tuần thứ ba mới phát hiện số điện thoại khách hàng nằm trong file test thì đã quá muộn.
Bước 6: tìm chỗ trùng lặp và chất lượng kém
Trong các buổi phỏng vấn, CRM được nhắc tới ba lần: marketing, chăm sóc khách hàng và BI đều nói “bên mình có kéo dữ liệu CRM về”. Qlik cảnh báo đúng tình huống này: khi nhiều nhóm cùng ingest từ một nguồn, dữ liệu dễ bị phân mảnh và trùng lặp.
Cột so_nhom_ingest ghi số nhóm đang kéo dữ liệu từ nguồn đó. Giá trị từ 2 trở lên là dấu hiệu nhiều nhóm đang giữ những bản sao khác nhau của cùng một dữ liệu. Ô của CRM ghi 3, và đây là rủi ro đáng nêu đầu tiên; tên ba nhóm có thể ghi vào ghi_chu_chat_luong.
Qlik cũng khuyên đưa việc kiểm tra chất lượng và độ đầy đủ dữ liệu vào quy trình quản trị. Ở giai đoạn kiểm kê, chưa cần đo kỹ. Một câu quan sát trong ghi_chu_chat_luong, chẳng hạn “POS thiếu mã cửa hàng ở một số dòng”, là đủ để biết sau này cần đo cái gì.
Bước 7: ghi rủi ro schema drift và đặt lịch đối soát
Phòng marketing kể rằng họ sửa câu hỏi trong form khảo sát gần như mỗi tháng. Đó là nguồn của schema drift: IBM mô tả đây là khi cấu trúc dữ liệu nguồn thay đổi, như thêm, bớt hoặc sửa trường, khiến nguồn và hệ đích lệch nhau.
Hãy xếp mỗi nguồn vào một trong ba mức thấp, trung bình, cao, dựa trên một câu hỏi: nguồn này có hay bị đổi cột mà không ai báo trước không? Form khảo sát đáng xếp mức cao, còn POS có thể xếp thấp.
Bản thân bảng kiểm kê cũng sẽ lỗi thời. IF4IT đề xuất đối soát tối thiểu mỗi quý ở giai đoạn khởi đầu, rồi hằng tháng hoặc mỗi khi có tích hợp mới khi tổ chức trưởng thành hơn. Hãy đưa lịch này vào tài liệu bàn giao và ghi rõ ai phía khách sẽ chịu trách nhiệm.
Những lỗi khiến bảng kiểm kê trở thành file chết
Lỗi hay gặp là ôm quá nhiều cột ngay từ đầu, rồi bỏ dở khi đến nguồn thứ mười. Một lỗi khác là ghi chủ sở hữu bằng tên phòng ban, hoặc để bảng nằm trong laptop của bạn thay vì ở chỗ khách hàng xem và sửa được.
Lỗi nguy hiểm nhất là coi bảng kiểm kê như việc hành chính. Mỗi ô trống trong bảng là một rủi ro của dự án, chỉ là chưa ai gọi tên nó ra.
Bảng kiểm kê giúp gì cho bạn với khách và trong CV?
Hãy mang bảng vào buổi review cuối tuần đầu với khách. Nó cho khách thấy bạn đã hiểu hệ thống của họ đến đâu, và cho bạn căn cứ để nói “phần này chưa làm được vì form khảo sát chưa có người chịu trách nhiệm”.
Khi viết CV, đừng chỉ ghi “làm việc với dữ liệu”. Hãy viết cụ thể: đã kiểm kê bao nhiêu nguồn, phát hiện bao nhiêu nguồn bị ingest trùng, và gắn nhãn độ nhạy cảm trước khi dữ liệu rời hệ thống của khách. Đó cũng là câu chuyện cụ thể để kể khi phỏng vấn.
Pipeline có thể viết lại, agent có thể chỉnh lại. Một nguồn bị bỏ sót trong tuần đầu thì có thể đến tuần thứ mười mới lộ ra.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!