Bản đồ HL7 v2 sang FHIR có sẵn, code chuyển đổi thì bạn tự viết
Từ một bản tin ADT mẫu ra một Patient hợp lệ, kèm cái bẫy R4 với R5 mà người mới hay vấp.
Tóm tắt nhanh
- Bản đồ v2-to-FHIR chỉ nói trường nào đi đâu, phần logic chuyển đổi là bạn tự viết.
- python-hl7 cho phép gọi trường theo số 1-based như trong spec, nên code đọc giống tài liệu.
- IG v2-to-FHIR dựa trên R4, còn fhir.resources mặc định R5, vì vậy phải import từ nhánh R4B.
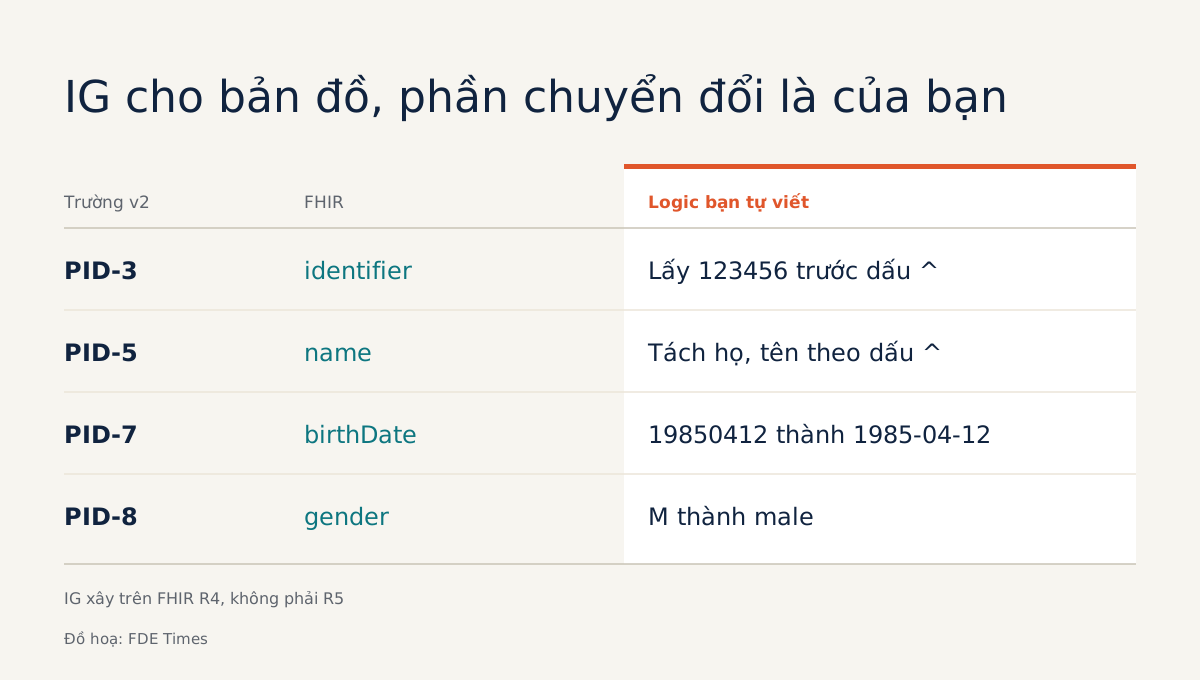
Bộ hướng dẫn chính thức của HL7 để chuyển bản tin v2 sang FHIR nói rõ rằng nội dung của nó chỉ mô tả trường nào ứng với thuộc tính nào, chứ không chỉ cách làm. Nó cho bạn biết PID-8 tương đương với gender, nhưng không có dòng code nào biến chuỗi M thành male. Phần đó bạn phải tự viết.
Nếu bạn làm FDE cho một dự án y tế mà hệ thống nguồn gửi bản tin v2 còn sản phẩm của bạn đọc FHIR, lớp chuyển đổi ở giữa là thứ ai đó phải viết. Người viết được nó, và giải thích được từng trường đi đâu, sẽ là người đội tích hợp của khách tìm đến mỗi khi dữ liệu lệch.
Bài này đi qua toàn bộ quy trình trên laptop: parse một bản tin ADT mẫu, đọc segment PID, map sang tài nguyên Patient theo bản đồ chính thức, rồi validate kết quả. Code chỉ khoảng 40 dòng.
Cần chuẩn bị những gì?
Bạn cần Python 3 và ba thư viện. python-hl7 là thư viện nhẹ, parse bản tin HL7 v2.x thành object Python. hl7apy là thư viện hiểu schema của HL7, hữu ích khi cần đối chiếu. fhir.resources dựng tài nguyên FHIR trên Pydantic v2.
python -m venv .venv && source .venv/bin/activate
pip install hl7 hl7apy fhir.resources
Nên mở sẵn hai trang của HL7 v2-to-FHIR IG: bản đồ bản tin ADT_A01 sang Bundle, và bản đồ segment PID sang Patient.
Bước 1: viết một bản tin mẫu
Bản tin dưới đây được dựng riêng cho bài hướng dẫn, không phải dữ liệu thật.
MSG = "\r".join([
    "MSH|^~\\&|LAB|BV_A|EHR|BV_A|202611190830||ADT^A01|MSG0001|P|2.5",
    "PID|1||123456^^^BV_A^MR||NGUYEN^AN^VAN||19850412|M",
])
Kiểm tra: đếm dấu | trong dòng PID. Trường thứ 3 là 123456^^^BV_A^MR, thứ 5 là tên, thứ 7 là ngày sinh, thứ 8 là M. Nếu đếm lệch một ô, mọi bước sau đều sai mà không báo lỗi.
Bước 2: parse và đọc trường theo số trong spec
Bạn gọi hl7.parse() trên chuỗi bản tin. Kết quả là một cây object có thể truy cập theo hai cách: kiểu list Python đánh số từ 0, hoặc gọi như hàm theo quy ước HL7 đánh số từ 1. Nên dùng cách thứ hai, vì khi đó code khớp với số trường trong tài liệu.
import hl7

h = hl7.parse(MSG)
pid = h.segment("PID")      # PID chỉ xuất hiện một lần
print(pid(3)(1))            # lần lặp đầu tiên của PID-3
print(str(pid(5)), str(pid(7)), str(pid(8)))
segment() là lối tắt dành cho những segment chỉ có một bản trong bản tin, như PID hay MSH. Kiểm tra: dòng đầu in ra mã bệnh nhân kèm các thành phần sau dấu ^, dòng sau in tên, ngày sinh và M.
Bước 3: map PID sang Patient
IG nói rằng khi xử lý PID của một bản tin ADT_A01, bạn tạo ra một Patient mới. Ở mức segment, bản đồ ghép PID-3 với identifier, PID-5 với name, PID-7 với birthDate và PID-8 với gender.
GENDER = {"M": "male", "F": "female", "U": "unknown"}  # bảng rút gọn

def v2_date(s):
    return f"{s[0:4]}-{s[4:6]}-{s[6:8]}"

def pid_to_patient(pid):
    mrn = str(pid(3)(1)).split("^")[0]
    parts = str(pid(5)).split("^")
    return {
        "resourceType": "Patient",
        "identifier": [{"value": mrn}],
        "name": [{"family": parts[0],
                  "given": [p for p in parts[1:3] if p]}],
        "birthDate": v2_date(str(pid(7))),
        "gender": GENDER.get(str(pid(8)), "unknown"),
    }
Đoạn này đã được đơn giản hóa. Nó không xử lý escape sequence, bỏ qua các lần lặp thứ hai của PID-3 và PID-5, và coi ngày sinh luôn có đủ 8 ký tự. Bảng GENDER cũng chỉ là bản rút gọn: ở dự án thật, bạn phải đối chiếu với bảng mã mà hệ thống của khách đang dùng.
Bước 4: validate bằng đúng phiên bản FHIR
Lỗi người mới hay mắc nhất nằm ở bước này. IG v2-to-FHIR là bản 1.0.0 (STU1), xây trên FHIR R4. Trong khi đó fhir.resources mặc định dùng R5 và giữ R4B, STU3 làm phiên bản cũ. Import theo mặc định nghĩa là bạn đang validate dữ liệu R4 bằng schema R5.
from fhir.resources.R4B.patient import Patient

patient = Patient.model_validate(pid_to_patient(pid))
print(patient.model_dump_json(indent=2))
model_validate dựng Patient từ một dict, đúng như README của thư viện hướng dẫn. Cũng đừng coi R4B và R4 là một: chúng mang tên khác nhau vì là hai bản phát hành khác nhau, nên khi map sang những tài nguyên ngoài Patient cơ bản, hãy đối chiếu lại với định nghĩa R4 mà IG dùng.
Kiểm tra: đổi PID-7 thành 19851345 rồi chạy lại, xem bước validate phản ứng thế nào. Nếu nó vẫn cho qua, đừng mặc định dữ liệu đã đúng: hãy tự thêm kiểm tra ngày tháng trong v2_date.
Bước 5: đối chiếu bằng một parser hiểu schema
python-hl7 không biết PID-5 tên là gì, nó chỉ biết vị trí. hl7apy thì parse chuỗi ER7 bằng parse_message và cho phép truy cập các thành phần con theo tên, không phân biệt hoa thường.
from hl7apy.parser import parse_message

m = parse_message(MSG, find_groups=False)
print(m.pid.patient_name.to_er7())
Mặc định hl7apy xếp các segment vào group của HL7. Tham số find_groups=False tắt hành vi đó để bạn gọi thẳng m.pid. Nếu cách gọi trên khác với phiên bản thư viện bạn cài, hãy xem lại tutorial của hl7apy. Kiểm tra: chuỗi in ra phải giống hệt str(pid(5)) ở bước 2.
Hai parser khác nhau mà cho cùng một kết quả thì bạn có thêm một lớp bảo đảm rằng mình không đếm lệch trường.
Bản tin thật sẽ làm vỡ code ở đâu?
Bản tin mẫu chỉ có một PID. Một bản tin có nhiều OBX thì khác: theo hướng dẫn mapping, mỗi lần segment lặp lại phải sinh ra một bản mới của tài nguyên tương ứng, tức là mười OBX thành mười Observation.
Lối tắt segment() sẽ không dùng được ở đây. Bạn phải duyệt qua cả cây, chẳng hạn [s for s in h if str(s[0]) == "OBX"], rồi map từng phần tử.
Chỗ vỡ thứ hai là những trường mà IG không có bản đồ. Hướng dẫn cho phép bạn thêm ánh xạ cục bộ, và khuyến khích đề xuất ngược lại cho HL7 qua JIRA.
Với FDE, mỗi ánh xạ cục bộ nên là một quyết định được ghi lại thành văn bản và được khách xác nhận, thay vì một dòng if lặng lẽ nằm trong code.
Ở chỗ khách hàng, kỹ năng này trông thế nào?
Khi bắt đầu một dự án với bệnh viện, việc nên làm trước tiên là xin khách vài bản tin mẫu đã bỏ thông tin định danh, rồi chạy đúng các bước 2 và 5 với từng loại bản tin.
Kết quả chạy là một bảng đối chiếu trường theo trường, và bạn mang bảng đó vào buổi họp với đội tích hợp của họ.
Bảng này cũng là bằng chứng tốt nhất cho CV. Khi tin tuyển dụng FDE nhắc đến HL7, FHIR hay interface engine, một repo có bộ bản tin kiểm thử, hàm map PID sang Patient ghi rõ “theo IG v2-to-FHIR, R4” và test bắt ngày sinh sai sẽ thuyết phục hơn nhiều so với một dòng “có kinh nghiệm với chuẩn y tế”.
Khó nhất không phải là parse. Khó nhất là ngồi với khách và quyết định chữ U trong PID-8 của bệnh viện họ thực ra có nghĩa là gì.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
7 nguồn
- python-hl7 - Easy HL7 v2.x Parsing
- Getting started — hl7apy tutorial
- Message ADT_A01 to Bundle Map - HL7 Version 2 to FHIR v1.0.0
- Segment PID to Patient Map - HL7 Version 2 to FHIR v1.0.0
- Mapping Guidelines - HL7 Version 2 to FHIR
- Message Maps - HL7 Version 2 to FHIR v1.0.0 · 2025-10-07
- nazrulworld/fhir.resources (GitHub README)