Thực hành: ghép khách hàng trùng CRM–ERP bằng Python, nạp Neo4j không sinh node trùng
Bảy dòng dữ liệu đủ làm lộ ba cái bẫy: số cặp bùng nổ, tên khớp 100 điểm mà có thể vẫn sai, và lần nạp lại sinh node trùng.

Tóm tắt nhanh
- Blocking phải đi trước fuzzy match, và nên có nhiều luật vì một cặp chỉ cần thỏa một luật là được so sánh.
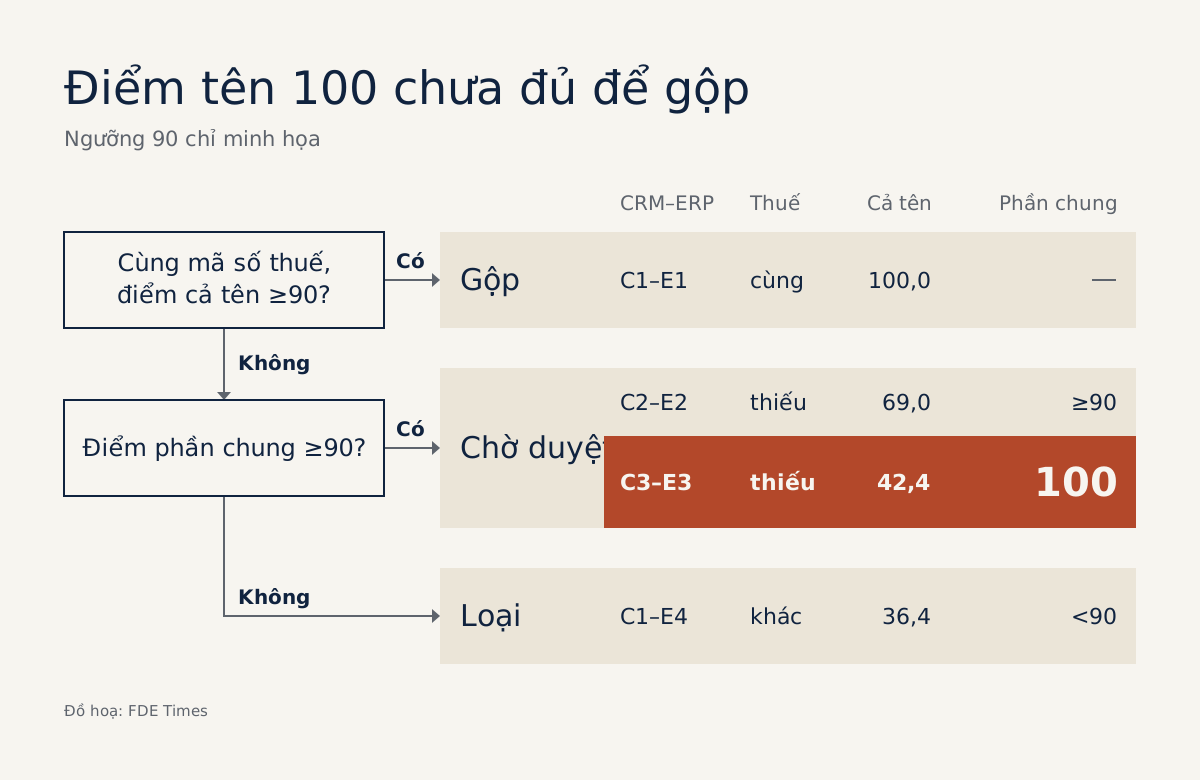
- token_set_ratio trả về 100 khi tên này là tập con của tên kia, nên ca điểm set cao mà điểm token_sort thấp phải qua người duyệt.
- Giữ bản ghi nguồn trong đồ thị và MERGE theo lô trên key constraint; gộp sau khi duyệt cần thêm bước xóa quan hệ cũ.
Một triệu bản ghi khách hàng sinh ra khoảng 500 tỉ cặp so sánh, theo tài liệu của Splink. Vì thế, ghép khách hàng trùng hiếm khi chỉ là chuyện vài dòng fuzzy match.
Thử hình dung CRM có 200.000 khách hàng và ERP có 150.000. So từng dòng với nhau, bạn có 30 tỉ cặp, trong khi hai hệ thống không chung một mã nào. Nếu ghép sai, đồ thị tri thức phía sau vẫn trả lời trôi chảy, chỉ là câu trả lời sai.
Bạn sẽ đụng bài toán này ngay khi dự án ở khách hàng cần gom dữ liệu của cùng một công ty từ nhiều hệ thống về một chỗ. Dưới đây là toàn bộ quy trình, chạy trên một bộ dữ liệu đủ nhỏ để bạn tính tay và kiểm tra từng bước.
Bạn sẽ xây gì?
Script gồm sáu phần: tạo dữ liệu mẫu, lọc cặp ứng viên, chấm điểm tên, gán canonical ID, nạp vào Neo4j và sửa đồ thị sau khi duyệt. Kết quả đúng là 7 bản ghi nguồn, 6 khách hàng và 2 ca chờ người duyệt; duyệt gộp một ca thì còn 5 khách hàng.
Bạn cần Python, gói RapidFuzz, driver Python của Neo4j và một instance Neo4j được phép ghi. Đây là bản rút gọn để học: luật viết tay, ngưỡng minh họa, chưa xử lý chuỗi ghép kiểu A trùng B, B trùng C.
Bước 1: Tạo dữ liệu có sẵn cái bẫy
crm = [
    {"id": "C1", "name": "Acme Co Ltd", "tax": "0101", "zip": "10000"},
    {"id": "C2", "name": "Beta Foods", "tax": None, "zip": "70000"},
    {"id": "C3", "name": "Acme Co", "tax": None, "zip": "20000"},
]
erp = [
    {"id": "E1", "name": "Ltd Acme Co", "tax": "0101", "zip": "10000"},
    {"id": "E2", "name": "Beta Foods Holdings", "tax": "0555", "zip": "70000"},
    {"id": "E3", "name": "Acme Co Logistics Holdings", "tax": "0999", "zip": "20000"},
    {"id": "E4", "name": "Gamma Steel", "tax": "0777", "zip": "10000"},
]
Dữ liệu này là giả định. C1 và E1 là cùng một công ty với tên đảo thứ tự, còn C2 và C3 thiếu mã số thuế, đúng kiểu dòng mà bạn sẽ gặp khi dữ liệu thật đổ về.
Kiểm tra: 3 × 4 = 12 cặp nếu so toàn bộ. Hãy nhớ con số này cho bước sau.
Bước 2: Blocking trước khi so sánh tên
Blocking giảm số cặp mà mô hình phải xét. Tài liệu của Splink nêu rõ rằng khi có nhiều luật, một cặp chỉ cần thỏa một luật là được đưa vào so sánh, và đoạn code dưới đây làm theo logic đó ở dạng thủ công.
from collections import defaultdict

def build_index(rows, field):
    idx = defaultdict(list)
    for row in rows:
        if row[field]:
            idx[row[field]].append(row)
    return idx

def candidate_pairs(crm, erp, fields=("tax", "zip")):
    seen = {}
    for field in fields:
        idx = build_index(erp, field)
        for a in crm:
            for b in idx.get(a[field], []):
                seen[(a["id"], b["id"])] = (a, b)
    return list(seen.values())

pairs = candidate_pairs(crm, erp)
print(len(pairs))  # 4
Kiểm tra: từ 12 cặp còn 4 cặp là C1–E1, C1–E4, C2–E2 và C3–E3. Nếu chỉ dùng luật mã số thuế, bạn còn đúng C1–E1 và mất hai ca khó nhất, vì C2 và C3 không có mã để khớp.
Đổi lại, luật theo mã bưu điện vẫn bỏ sót công ty đã chuyển địa chỉ mà cũng thiếu mã số thuế. Muốn bắt những ca đó, bạn phải thêm luật khác rồi đo lại số cặp sinh ra.
Bước 3: Chấm tên bằng hai thước đo
Theo tài liệu của RapidFuzz, token_set_ratio trả về 100 khi chuỗi này là tập con của chuỗi kia, bất kể chuỗi dài hơn có thêm gì. Script dùng token_sort_ratio làm thước đo thứ hai để đối chiếu, và phần kiểm tra bên dưới cho thấy hai hàm chấm cùng một cặp rất khác nhau.
Vì thế, hãy đọc hai điểm cùng nhau. Điểm set cao mà điểm sort thấp thường có nghĩa là một tên chứa tên còn lại, có thể là cùng công ty viết tắt, cũng có thể là công ty con hay một doanh nghiệp hoàn toàn khác.
from rapidfuzz import fuzz

def decide(a, b):
    name_a, name_b = a["name"].lower(), b["name"].lower()
    sort_score = fuzz.token_sort_ratio(name_a, name_b)
    set_score = fuzz.token_set_ratio(name_a, name_b)
    same_tax = a["tax"] and a["tax"] == b["tax"]

    if same_tax and sort_score >= 90:
        return "match", sort_score
    if set_score >= 90:
        return "review", sort_score
    return "reject", sort_score

results = [(a, b, *decide(a, b)) for a, b in pairs]
for a, b, verdict, score in results:
    print(a["id"], b["id"], round(score, 1), verdict)
Kiểm tra: kết quả nên như sau; cột số là điểm token_sort_ratio.
C1 E1 100.0 match
C1 E4 36.4 reject
C2 E2 69.0 review
C3 E3 42.4 review
Hãy đọc kỹ dòng C3–E3. “Acme Co” nằm trọn trong “Acme Co Logistics Holdings” nên điểm set là 100, dù điểm sort chỉ 42,4. Nếu chỉ dựa vào điểm set để gộp, một công ty sẽ nuốt luôn một công ty có thể khác hẳn.
Ngưỡng 90 ở đây chỉ để minh họa. Với dữ liệu thật, hãy lấy mẫu từng khoảng điểm, đọc bằng mắt, rồi mới chốt ngưỡng cùng người hiểu dữ liệu bên khách hàng.
Bước 4: Gán canonical ID và lưu hàng đợi duyệt
Nếu sinh UUID ngẫu nhiên mỗi lần chạy, MERGE sẽ không tìm thấy node cũ và tạo khách hàng mới. Bản rút gọn này lấy ID từ bản ghi nguồn: bản ghi ERP đã ghép dùng ID theo CRM, bản ghi chưa ghép giữ ID riêng. Nhờ vậy ID giữ nguyên qua các lần chạy, chừng nào quyết định ghép chưa đổi.
Ca chờ duyệt phải được ghi ra đâu đó, không thì chúng biến mất khi script kết thúc. Ở đây review_queue.json là hàng đợi, còn approved.json là sổ quyết định của người duyệt, ví dụ {"E2": "C2"}.
import json
from pathlib import Path

path = Path("approved.json")
approved = json.loads(path.read_text()) if path.exists() else {}

erp_to_crm = {
    b["id"]: a["id"] for a, b, verdict, _ in results if verdict == "match"
}
erp_to_crm.update(approved)

queue = [
    {"crm": a["id"], "erp": b["id"], "score": round(score, 1)}
    for a, b, verdict, score in results
    if verdict == "review" and b["id"] not in approved
]
Path("review_queue.json").write_text(json.dumps(queue, indent=2))

rows = []
for r in crm:
    rows.append({"source_key": f"crm:{r['id']}", "canonical_id": f"cust-{r['id']}",
                 "name": r["name"], "tax": r["tax"]})
for r in erp:
    owner = erp_to_crm.get(r["id"], r["id"])
    rows.append({"source_key": f"erp:{r['id']}", "canonical_id": f"cust-{owner}",
                 "name": r["name"], "tax": r["tax"]})

print(len(rows), len({row["canonical_id"] for row in rows}), len(queue))  # 7 6 2
Kiểm tra: in ra 7 6 2, và review_queue.json có đúng C2–E2 và C3–E3. Hai cặp này chưa được gộp cho đến khi có người xác nhận. Bản rút gọn chưa lưu ca bị từ chối nên chúng sẽ quay lại hàng đợi ở lần chạy sau; dự án thật nên lưu cả hai loại quyết định.
Bước 5: Nạp vào Neo4j sao cho chạy lại vẫn an toàn
MERGE tìm mẫu đã có, nếu chưa có thì tạo, nên về nguyên tắc có thể nạp lại. Nhưng Cypher Manual cảnh báo rằng riêng MERGE chỉ đảm bảo mẫu tồn tại, không đảm bảo tính duy nhất, và key constraint là lựa chọn được ưu tiên. Hãy tạo constraint trước khi nạp.
Trước khi chạy, hãy xem instance của bạn là Enterprise hay Community Edition, vì node key constraint chỉ có ở Enterprise. Trên Community, hai lệnh IS NODE KEY dưới đây sẽ báo lỗi và script dừng ngay tại đó; phần xử lý nằm ngay sau đoạn code.
Tài liệu driver Python cũng khuyên đánh index cho thuộc tính hay lọc, nên hãy xác nhận hai khóa MERGE này đã có index.
Tài liệu đó còn khuyên ghi theo lô bằng UNWIND thay vì mỗi dòng một truy vấn. Đoạn dưới mở kết nối, tạo constraint rồi truyền danh sách rows vào tham số $rows. Địa chỉ và mật khẩu chỉ là giả định; viết thẳng vào code là cách rút gọn để học, và cú pháp driver cần đối chiếu với phiên bản bạn cài.
from neo4j import GraphDatabase

URI = "neo4j://localhost:7687"
AUTH = ("neo4j", "mat-khau-cua-ban")

CONSTRAINTS = [
    """CREATE CONSTRAINT customer_key IF NOT EXISTS
       FOR (c:Customer) REQUIRE c.canonical_id IS NODE KEY""",
    """CREATE CONSTRAINT source_key IF NOT EXISTS
       FOR (s:SourceRecord) REQUIRE s.source_key IS NODE KEY""",
]

LOAD = """
UNWIND $rows AS row
MERGE (c:Customer {canonical_id: row.canonical_id})
MERGE (s:SourceRecord {source_key: row.source_key})
SET s.name = row.name, s.tax = row.tax
MERGE (s)-[:RESOLVES_TO]->(c)
"""

driver = GraphDatabase.driver(URI, auth=AUTH)
for query in CONSTRAINTS:
    driver.execute_query(query)
driver.execute_query(LOAD, rows=rows)
Nếu lệnh tạo constraint báo lỗi trên Community: đổi sang uniqueness constraint một thuộc tính bằng cách thay danh sách CONSTRAINTS như dưới đây, rồi chạy lại script.
CONSTRAINTS = [
    """CREATE CONSTRAINT customer_key IF NOT EXISTS
       FOR (c:Customer) REQUIRE c.canonical_id IS UNIQUE""",
    """CREATE CONSTRAINT source_key IF NOT EXISTS
       FOR (s:SourceRecord) REQUIRE s.source_key IS UNIQUE""",
]
Đổi lại, uniqueness constraint không buộc thuộc tính phải tồn tại như node key. Script mẫu luôn tạo đủ hai khóa, nhưng với dữ liệu thật, hãy kiểm tra canonical_id và source_key của mọi dòng trước khi nạp.
Việc giữ SourceRecord thay vì chép đè thuộc tính lên Customer là chủ ý thiết kế. Khi kế toán hỏi vì sao hai dòng bị gộp, bạn lần được về bản ghi gốc, và một lần gộp sai được sửa ở lớp quan hệ mà dữ liệu nguồn vẫn nguyên.
Kiểm tra: thêm đoạn sau vào cuối script. Nó phải in cust-C1 2 rồi 6; nạp lại lần nữa, số Customer vẫn phải là 6.
CHECK = """
MATCH (s:SourceRecord)-[:RESOLVES_TO]->(c:Customer)
WITH c, count(s) AS n
WHERE n > 1
RETURN c.canonical_id AS id, n
"""
records, _, _ = driver.execute_query(CHECK)
for record in records:
    print(record["id"], record["n"])

records, _, _ = driver.execute_query("MATCH (c:Customer) RETURN count(c) AS total")
print(records[0]["total"])
driver.close()
Bước 6: Khi người duyệt đồng ý gộp, MERGE không tự dọn
Giả sử người duyệt xác nhận Beta Foods và Beta Foods Holdings là một, bạn ghi {"E2": "C2"} vào approved.json. Lần chạy sau, E2 mang ID cust-C2, tức canonical ID đổi có chủ đích. MERGE chỉ tìm hoặc tạo, nên nó thêm quan hệ mới nhưng để nguyên quan hệ cũ và node cust-E2.
Vì thế, trước khi nạp lại, hãy xóa dấu vết cũ của các bản ghi vừa được duyệt. Đặt đoạn dưới ngay trước dòng driver.execute_query(LOAD, rows=rows); danh sách moves được truyền vào tham số $moves.
MOVE = """
UNWIND $moves AS m
MATCH (:SourceRecord {source_key: m.source_key})-[old:RESOLVES_TO]->(c:Customer {canonical_id: m.old_id})
DELETE old, c
"""
moves = [{"source_key": f"erp:{e}", "old_id": f"cust-{e}"} for e in approved]
driver.execute_query(MOVE, moves=moves)
Đây cũng là bản rút gọn: nó giả định Customer cũ chỉ nối với đúng bản ghi ấy. Nếu node đó đã có quan hệ khác, hãy chuyển chúng đi trước khi xóa.
Kiểm tra: script in ra 7 5 1, truy vấn CHECK ở bước 5 trả về cust-C1 và cust-C2, mỗi khách hàng 2 bản ghi, và số Customer là 5. Chạy lại lần nữa vẫn là 5, vì MATCH không còn thấy quan hệ cũ để xóa.
Khi nào nên bỏ luật viết tay?
Luật tự viết giúp bạn hiểu bài toán, nhưng sẽ nhanh chóng khó bảo trì khi số trường và số nguồn tăng. Khi đó, hãy chọn công cụ theo phần việc bạn không muốn tự viết nữa.
| Công cụ | Hợp khi | Cần lưu ý |
|---|---|---|
| RapidFuzz | Cần một thước đo so sánh tên | Trong script này, nó chỉ chấm điểm chuỗi; phần ghép bản ghi bạn tự xây |
| recordlinkage | Muốn dùng sẵn block index, chỉ trả về các cặp khớp trên biến đã chọn | Full index có số cặp tăng theo cấp bình phương, nên dữ liệu lớn vẫn cần blocking |
| Splink | Dữ liệu không có mã định danh chung, cần ghép theo xác suất | Vẫn phải tự đặt luật blocking và kiểm tra kết quả |
Splink là gói Python ghép bản ghi theo xác suất, dựa trên mô hình Fellegi-Sunter và chạy trên DuckDB hoặc Spark. Với CRM và ERP không chung một mã nào, đó là ứng viên đầu tiên đáng thử.
Những lỗi nên tránh từ đầu
Đừng tin vào một điểm số duy nhất, đặc biệt là token_set_ratio, vì tên ngắn dễ nằm trọn trong tên dài. Cũng đừng chỉ đặt một luật blocking, vì cặp đúng có thể bị loại trước khi kịp được chấm mà không có cảnh báo nào.
Ở phía đồ thị, hãy tránh ba lỗi: canonical ID sinh ngẫu nhiên mỗi lần chạy, nạp song song khi chưa có constraint và gửi từng truy vấn cho mỗi dòng. Cả ba đều có thể chạy êm trên dữ liệu mẫu rồi mới lộ ra khi gặp dữ liệu thật.
Ở khách hàng, bạn làm gì đầu tiên?
Đừng mở editor ngay. Hãy ngồi với người giữ dữ liệu CRM và người giữ dữ liệu ERP, hỏi trường nào đáng tin, trường nào hay trống, và ai có quyền quyết định hai công ty là một.
Sau đó, chạy thử trên một mẫu và mang hàng đợi duyệt đến buổi họp, thay vì mang số liệu độ chính xác. Hai dòng như Beta Foods và Acme Co sẽ buộc mọi người nói rõ thế nào là công ty con, chi nhánh và “một khách hàng”. Schema không trả lời được những câu hỏi đó.
Khi đi tìm việc, hãy để ý các từ khóa entity resolution, record linkage hay master data trong mô tả công việc. Trong CV, hãy mô tả cả số bản ghi đã ghép, số ca cần duyệt và cách bạn đảm bảo nạp lại an toàn; trong phỏng vấn, câu hỏi hay nhất để tự luyện là vì sao bạn không tự động gộp một cặp có điểm 100.
Đồ thị tri thức chỉ đúng khi những quyết định “hai dòng này là một” bên dưới nó đúng. FDE giỏi là người lưu lại dấu vết của từng quyết định ấy, để khi có sai sót, họ biết chính xác phải sửa quan hệ nào.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!