Ba byte vô hình làm hỏng file CSV của khách mà không báo lỗi
Excel chèn BOM để hiển thị đúng tiếng Việt; một parser Python nhỏ cùng golden test biến lỗi này và hai lỗi im lặng khác thành test đỏ.
Tóm tắt nhanh
- Ba byte BOM 0xef 0xbb 0xbf làm hỏng tên cột đầu tiên nếu bạn giải mã bằng utf-8 thường, còn utf-8-sig tự bỏ qua chúng.
- Thư viện csv mặc định không báo lỗi khi gặp dòng hỏng, còn errors='replace' lặng lẽ chèn ký tự thay thế, nên cả hai đều phải chuyển sang chế độ strict.
- Golden test lưu đầu ra đã chuẩn hoá của parser, nên mọi thay đổi về encoding hay dấu phân cách đều hiện thành diff để bạn đọc lại.
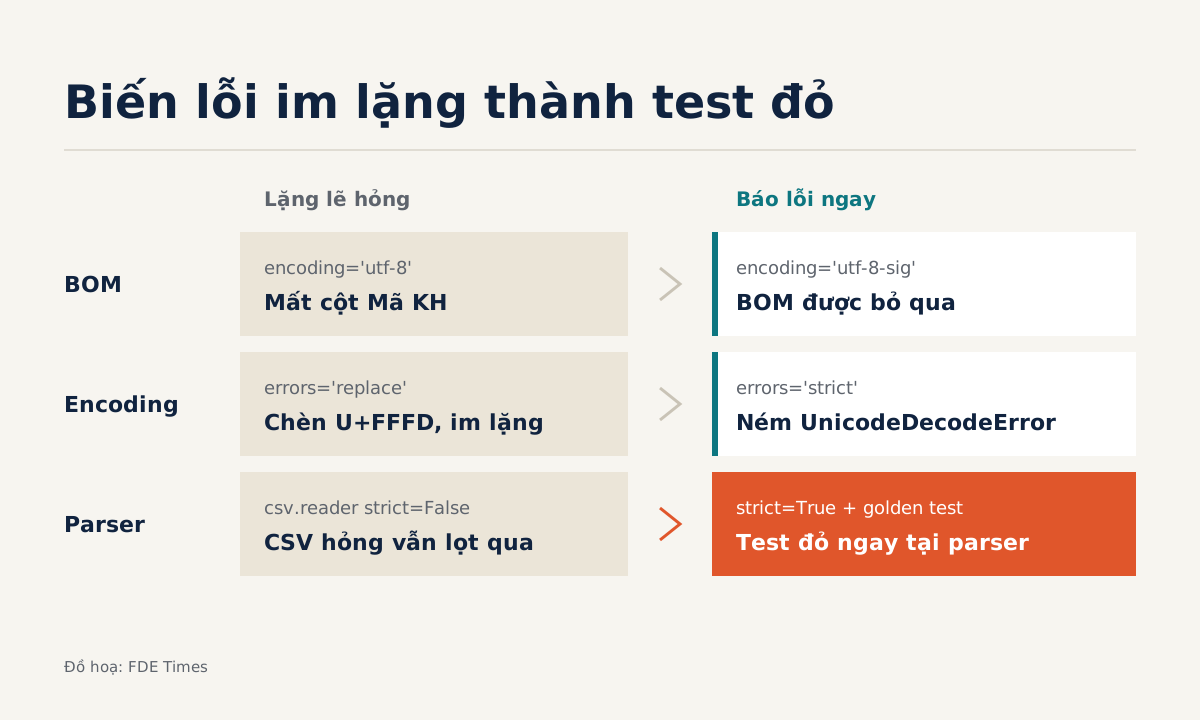
Chỉ ba byte 0xef 0xbb 0xbf ở đầu file là đủ để pipeline của bạn không tìm thấy cột “Mã KH”. Code không ném exception nào. Nó chỉ lặng lẽ tạo ra một tên cột có thêm một ký tự vô hình ở đầu, và mọi lệnh tra theo tên cột đó đều thất bại.
Làm FDE thì sớm muộn gì bạn cũng gặp chuyện này. Khách xuất dữ liệu từ Excel, từ một phần mềm kế toán cũ hoặc từ hệ thống của một bên thứ ba, rồi gửi cho bạn một file CSV. Dữ liệu tiếng Việt, hay bất kỳ ngôn ngữ nào có dấu, sẽ làm lộ ra ba lỗi kinh điển: encoding, BOM và dấu phân cách.
Bài này hướng dẫn bạn viết một parser nhỏ bằng thư viện chuẩn của Python để xử lý cả ba lỗi, rồi khoá hành vi của parser bằng golden test. Bạn chỉ cần Python 3 và pytest. Code trong bài đã được rút gọn cho dễ đọc, nên trước khi đưa vào dự án thật, bạn cần bổ sung logging và xử lý lỗi.
Vì sao file của khách hay có BOM?
Theo tài liệu Python, BOM là chuỗi byte 0xef 0xbb 0xbf. Đây là một biến thể UTF-8 bắt nguồn từ Notepad của Microsoft, và Python gọi codec của nó là utf-8-sig. Khách không tự tay thêm BOM vào file. Phần mềm của họ làm việc đó.
Thủ phạm là Excel. Trong một bài viết năm 2014, Chase Seibert ghi nhận rằng Excel 2007, 2010 và 2013 không nhận ra file UTF-8 nếu file đó thiếu BOM.
Khi đó tiếng Việt hiện ra vỡ dấu, nên các công cụ xuất file chèn BOM để Excel hiển thị cho đúng. Kết quả là file đến tay bạn thường có BOM, còn file không có BOM lại hay hiện chữ hỏng khi khách mở bằng Excel.
Bài viết đó còn chỉ ra một cái bẫy khác. Nếu file vừa có BOM vừa có dòng sep=, ở đầu, Excel trên Windows sẽ bỏ qua BOM. Bài viết đã có từ 2014, nên bạn cần kiểm tra lại trên phiên bản Excel khách đang dùng. Dù vậy, hễ thấy dòng sep= ở đầu file là bạn nên nghĩ ngay đến lỗi này.
Bước 1: tạo file mẫu giống file của khách
Hãy bắt đầu bằng một file có đủ các lỗi khó: có BOM, phân cách bằng dấu chấm phẩy và có một địa chỉ xuống dòng nằm trong dấu ngoặc kép.
# make_fixture.py
from pathlib import Path

FIX = Path("tests/fixtures")
FIX.mkdir(parents=True, exist_ok=True)
text = ('Mã KH;Họ tên;Địa chỉ\r\n'
        'KH01;Nguyễn Thị An;"12 Lý Thường Kiệt\r\nPhường 7"\r\n')
(FIX / "bom_semicolon.csv").write_bytes(text.encode("utf-8-sig"))
Kiểm tra: chạy python -c "print(open('tests/fixtures/bom_semicolon.csv','rb').read(3))". Kết quả phải là b'\xef\xbb\xbf'. Với file dùng encoding cũ, đừng tự tạo mẫu mà hãy xin khách một file thật rồi ẩn danh dữ liệu. File mẫu càng giống dữ liệu thật thì test càng có giá trị.
Bước 2: đọc bytes trước, rồi mới đoán encoding
Lỗi hay gặp nhất là mở file bằng encoding="utf-8" rồi tin rằng mọi thứ đã ổn. Với file có BOM, ký tự BOM vẫn nằm lại ở đầu tên cột thứ nhất. Theo tài liệu Python, codec utf-8-sig bỏ qua ba byte BOM nếu chúng là ba byte đầu tiên của file, nên đây là cách sửa trực tiếp.
Nếu file không phải UTF-8 hợp lệ, Python có sẵn codec cp1258, tức windows-1258, dành cho tiếng Việt. Bảng encoding chuẩn của Python không có TCVN hay VISCII. Nếu khách dùng một trong hai bảng mã này, bạn sẽ cần một bộ chuyển đổi riêng.
# doc_csv.py
CANDIDATES = ("utf-8-sig", "cp1258")

def detect_encoding(raw: bytes) -> str:
    for enc in CANDIDATES:
        try:
            raw.decode(enc, errors="strict")
            return enc
        except UnicodeDecodeError:
            continue
    raise ValueError("Không giải mã được file với các encoding đã biết")
Chi tiết quan trọng nằm ở errors="strict". Theo tài liệu Python, đây là chế độ mặc định và nó ném lỗi khi gặp byte không hợp lệ. Còn errors="replace" thì lặng lẽ chèn ký tự U+FFFD vào chỗ hỏng. Parser vẫn chạy, nhưng dữ liệu đẩy lên hệ thống của khách đã có những ô vuông thế chỗ chữ có dấu.
Thứ tự thử encoding cũng quan trọng. UTF-8 có cấu trúc chặt, nên một file viết bằng encoding khác rất dễ làm nó báo lỗi.
Ngược lại, một bảng mã một byte như cp1258 dễ dãi hơn nhiều: phần lớn chuỗi byte đưa vào đều giải mã được, kể cả khi kết quả là chữ vô nghĩa. Bạn có thể tự thấy điều này trong một dòng, lấy bytes UTF-8 của một cái tên rồi giải mã nhầm bằng cp1258:
>>> "Nguyễn".encode("utf-8").decode("cp1258")
'Nguyá»…n'
Không có exception nào, chỉ có một cái tên hỏng. Vì vậy hãy luôn thử utf-8-sig trước, và để golden test ở Bước 5 phát hiện trường hợp chọn nhầm cp1258.
Bước 3: mở file với newline=‘’
Tài liệu module csv nói rõ: nếu không đặt newline='', các ký tự xuống dòng nằm trong trường có ngoặc kép sẽ bị đọc sai. Địa chỉ “12 Lý Thường Kiệt” xuống dòng sang “Phường 7” chính là trường hợp đó. Thiếu tham số này, một khách hàng có thể bị tách thành hai dòng hỏng.
import csv

def parse_file(path, expected_cols: int) -> list[list[str]]:
    raw = open(path, "rb").read()
    enc = detect_encoding(raw)
    with open(path, encoding=enc, errors="strict", newline="") as f:
        sample = f.read(4096)
        f.seek(0)
        dialect = csv.Sniffer().sniff(sample, delimiters=",;\t|")
        rows = list(csv.reader(f, dialect, strict=True))
    check_columns(rows, expected_cols)
    return rows
Kiểm tra: chạy print(parse_file("tests/fixtures/bom_semicolon.csv", 3)). Bạn phải nhận được đúng hai dòng. Ô đầu tiên phải là 'Mã KH', không có '' đứng trước, và ô địa chỉ phải chứa ký tự xuống dòng.
Bước 4: đừng tin hoàn toàn vào Sniffer
csv.Sniffer đoán định dạng của file. Tài liệu cho phép bạn truyền tham số delimiters để giới hạn những ký tự được làm dấu phân cách, ở đây là dấu phẩy, chấm phẩy, tab và gạch đứng. Nhờ vậy Sniffer không thể chọn một ký tự lạ nào đó trong dữ liệu.
Nhưng Sniffer vẫn có điểm yếu. Theo tài liệu, khi cả , và ; đều chia mọi dòng một cách nhất quán, Sniffer chọn theo thứ tự ưu tiên trong thuộc tính preferred, bất kể mỗi ký tự xuất hiện bao nhiêu lần.
Thử hình dung file của một nhà phân phối có cột giá viết kiểu “125,5” và phân cách bằng dấu chấm phẩy. Nếu dòng nào cũng có cùng số ô giá, dấu phẩy cũng chia mọi dòng đều đặn chẳng kém dấu chấm phẩy, và Sniffer có thể chọn sai.
Vì thế bạn cần một bước kiểm tra độc lập, dựa trên điều đã biết chắc từ buổi discovery với khách: số cột.
def check_columns(rows, expected_cols):
    for i, row in enumerate(rows):
        if len(row) != expected_cols:
            raise ValueError(f"Dòng {i}: {len(row)} cột, cần {expected_cols}")
Tham số strict=True trong csv.reader cũng không thừa. Theo tài liệu, Dialect mặc định dùng dấu phẩy và đặt strict=False, nên dữ liệu CSV hỏng vẫn lọt qua mà không báo gì. Khi bật strict, lỗi dừng ngay tại parser thay vì làm hỏng dữ liệu ở các bước sau.
Bước 5: khoá hành vi của parser bằng golden test
Đến đây parser đã chạy đúng. Vấn đề là tuần sau, một đồng nghiệp có thể thêm errors="replace" cho “đỡ lỗi”, hoặc đổi thứ tự thử encoding.
Tài liệu của TensorFlow Federated định nghĩa golden test là loại test dùng khi bạn muốn lập trình viên biết code của họ đã làm thay đổi đầu ra của một hàm.
Đầu ra đã chuẩn hoá của một parser CSV rất hợp với loại test này.
# tests/test_golden.py (bản rút gọn)
import json, os
from pathlib import Path
import pytest
from doc_csv import parse_file

HERE = Path(__file__).parent

@pytest.mark.parametrize("name", ["bom_semicolon.csv"])
def test_golden(name):
    rows = parse_file(HERE / "fixtures" / name, expected_cols=3)
    actual = json.dumps(rows, ensure_ascii=False, indent=2)
    gold = HERE / "golden" / f"{name}.json"
    if os.environ.get("UPDATE_GOLDEN"):
        gold.parent.mkdir(exist_ok=True)
        gold.write_text(actual, encoding="utf-8")
    assert actual == gold.read_text(encoding="utf-8")
Lần đầu, chạy UPDATE_GOLDEN=1 pytest để tạo file chuẩn, rồi mở file JSON và đọc từng ô. Nếu không muốn tự viết, bạn có thể dùng plugin pytest-goldie. Plugin này có sẵn fixture golden và cờ update_goldens để ghi đè đầu ra đã lưu.
Sai lầm phổ biến nhất với golden test là cập nhật file chuẩn mà không đọc lại. Tài liệu của TensorFlow Federated nhấn mạnh rằng sau khi tạo lại file chuẩn, bạn phải xem diff để tìm những thay đổi ngoài dự kiến. Một chữ “Nguyễn” biến thành “Nguyá»…n” trong diff chính là lỗi chọn nhầm cp1258 mà Bước 2 đã cảnh báo.
Kỹ năng này dùng ở chỗ khách như thế nào?
Ngày đầu tiên làm việc với khách, trước khi viết dòng transform nào, hãy xin ba đến năm file mẫu từ mỗi hệ thống nguồn. Đưa từng file vào tests/fixtures, kể cả file lỗi, rồi tạo golden test cho từng file.
Khi khách gửi một file mới làm parser hỏng, bạn thêm nó vào bộ fixture, sửa code và đọc diff. Mỗi sự cố sẽ thành một test mới.
Khi đọc tin tuyển dụng FDE, hãy để ý những dòng nhắc đến việc tích hợp hay nhập dữ liệu của khách: nếu có, đó chính là công việc này. Trong CV, đừng chỉ viết “xử lý CSV”.
Hãy viết cụ thể hơn, chẳng hạn bạn đã dựng bộ golden test cho dữ liệu nhập từ khách và bắt được lỗi encoding trước khi dữ liệu lên production. Một repo nhỏ có fixture thật đã ẩn danh còn thuyết phục hơn cả đoạn mô tả đó.
Dữ liệu của khách sẽ luôn có những lỗi bạn chưa từng gặp. Golden test bảo đảm mỗi lỗi bạn đã sửa sẽ không âm thầm quay lại.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!