Bản demo RAG trơn tru cho đến khi giám đốc tài chính đặt câu hỏi
Mã lỗi cần tìm từ khoá, số liệu tổng hợp cần SQL, nên hãy phân loại câu hỏi của khách trước khi chọn vector database.
Tóm tắt nhanh
- RAG kiểu đơn giản trông ổn khi demo nhưng gãy khi lên production, vì câu hỏi trong doanh nghiệp hiếm khi chỉ là tra cứu.
- Mã lỗi, SKU, số phiên bản thì cần BM25. Câu hỏi diễn đạt khác chữ trong tài liệu thì cần vector. Câu hỏi tổng hợp số liệu thì cần chạy SQL.
- Câu SQL chạy được vẫn có thể sai, nên trước khi trả kết quả phải kiểm tra bảng được phép dùng, bộ lọc bắt buộc và đúng trường ngày.
Tuần thứ hai ở chỗ khách, bản demo RAG của bạn trả lời trơn tru mọi câu hỏi về tài liệu sản phẩm. Rồi trưởng nhóm support gõ “TS-999 nghĩa là gì?”, còn giám đốc tài chính hỏi doanh thu tháng trước theo từng vùng. Hệ thống trả lời cả hai câu rất tự tin, và sai cả hai.
Kịch bản này không hiếm. Một kỹ sư từng dựng hệ thống hỏi đáp trên dữ liệu có cấu trúc giải thích rằng RAG kiểu đơn giản gãy trên production vì câu hỏi trong doanh nghiệp hiếm khi chỉ là tra cứu. Demo thường chỉ gồm toàn câu tra cứu. Người dùng thật thì không hỏi như vậy.
Vì thế, kỹ năng FDE cần có ở đây không phải là chọn được vector database tốt nhất. Bạn cần phân loại câu hỏi của khách trước, rồi mới chọn đường đi cho từng loại. Đây là quyết định kiến trúc mà một engineer ngồi ở trụ sở rất khó tự đưa ra, vì họ không có danh sách câu hỏi thật.
Ba loại câu hỏi cần ba công cụ khác nhau
Loại đầu tiên là câu hỏi chứa mã chính xác. Anthropic, khi viết về contextual retrieval, đưa ra một ví dụ: mô hình embedding có thể tìm được nội dung nói chung về mã lỗi nhưng lại bỏ sót đúng đoạn có “TS-999”. BM25 khớp theo từng token, nên mạnh nhất với SKU, mã lỗi, số phiên bản, tên người và số hiệu văn bản pháp quy.
Điểm mạnh đó cũng là điểm yếu. BM25 so token chứ không hiểu nghĩa. Nếu khách hỏi “sao tôi bị khoá tài khoản” mà tài liệu viết “lockout policy”, BM25 gần như không tìm được gì hữu ích. Những câu như vậy cần tìm kiếm vector, vốn so theo nghĩa chứ không so từng chữ.
Loại thứ ba nguy hiểm nhất: câu hỏi tổng hợp kiểu “bao nhiêu”, “tổng”, “theo tháng”. Không có đoạn tài liệu nào chứa sẵn câu trả lời, nên dù retrieve giỏi đến đâu, mô hình cũng chỉ cộng nhẩm vài con số rải rác trong các chunk. Kỹ sư nói trên khuyên rằng câu hỏi tổng hợp thường nên đi qua bước chạy SQL.
| Loại câu hỏi | Dấu hiệu nhận ra | Công cụ | Hậu quả khi dùng sai công cụ |
|---|---|---|---|
| Tra mã chính xác | Có mã lỗi, SKU, số phiên bản, tên riêng | BM25 (thường ghép với vector) | Vector trả về tài liệu “na ná” nhưng không phải đúng mã |
| Tra theo nghĩa | Khách dùng chữ khác với tài liệu | Vector | BM25 trả về rỗng hoặc lạc đề |
| Tổng hợp số liệu | “bao nhiêu”, “tổng”, “theo vùng”, “top” | Text-to-SQL | RAG đưa ra một con số trông hợp lý nhưng bịa |
Làm thử với 200 câu hỏi
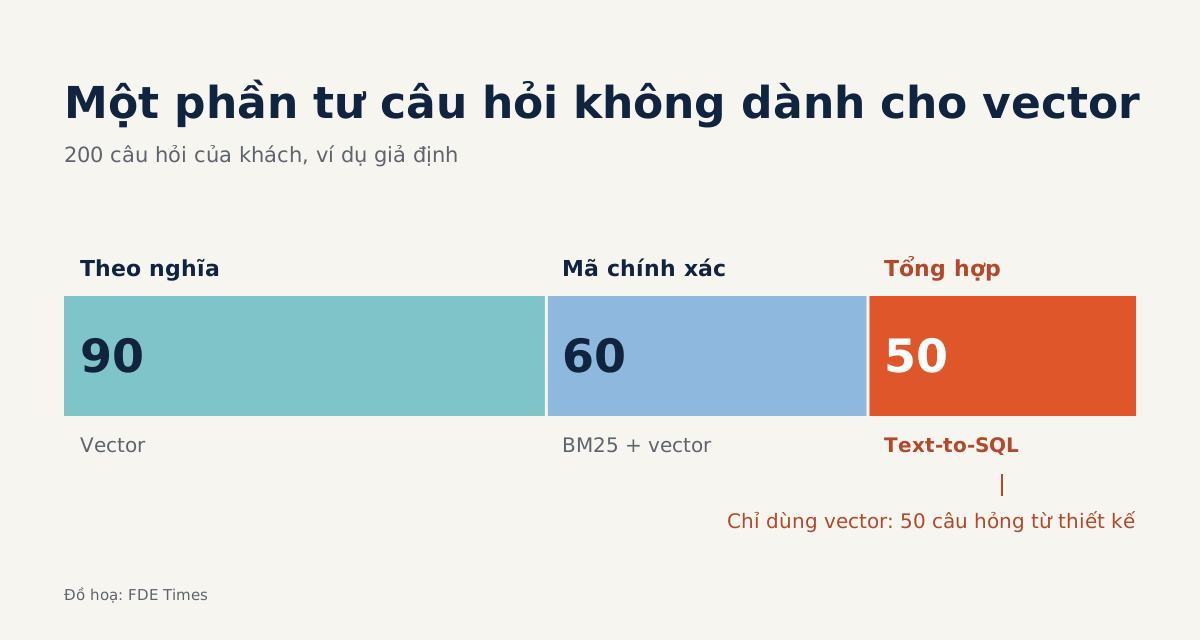
Giả sử bạn xuất được 200 câu hỏi thật từ hệ thống ticket của một công ty phần mềm, rồi ngồi một buổi chiều gắn nhãn. Kết quả giả định: 90 câu tra theo nghĩa, 60 câu có mã định danh, 50 câu hỏi số liệu tổng hợp.
Nếu đẩy cả 200 câu vào một pipeline vector, 50 câu cuối (tức một phần tư lưu lượng) sẽ hỏng ngay từ thiết kế, chưa cần nói đến chất lượng embedding.
Bộ định tuyến đầu tiên không cần phức tạp. Quy tắc đơn giản rẻ, dễ debug và dễ giải thích cho khách. Chỉ cần nhớ khớp theo ranh giới từ: nếu so chuỗi con thô, chữ “top” sẽ khớp nhầm cả “laptop” hay “stop”.
import re

# Mẫu mã định danh: TS-999, SKU-1042, v2.3...
MA_DINH_DANH = re.compile(r"\b[A-Z]{2,}-\d+\b|\bv\d+\.\d+")
# \b giữ ranh giới từ, để "top" không khớp với "laptop" hay "stop"
TU_TONG_HOP = re.compile(
    r"\b(bao nhiêu|tổng|trung bình|theo tháng|theo vùng|top)\b",
    re.IGNORECASE,
)

def dinh_tuyen(cau_hoi: str) -> str:
    if TU_TONG_HOP.search(cau_hoi):
        return "sql"
    if MA_DINH_DANH.search(cau_hoi):
        return "hybrid"  # BM25 giữ mã chính xác, vector bù phần ngữ nghĩa
    return "vector"
Sau này bạn có thể thay quy tắc bằng một bộ phân loại dùng LLM. Nhưng hãy giữ lại 200 câu đã gắn nhãn: đó là bộ eval để đo bộ định tuyến, và cũng là bằng chứng mạnh nhất khi khách hỏi vì sao kiến trúc lại có ba nhánh.
Ghép kết quả theo thứ hạng, đừng ghép theo điểm
Với nhánh hybrid, bạn cần trộn hai danh sách kết quả. Điểm BM25 và điểm cosine nằm trên hai thang đo khác nhau, nên cộng thẳng hai điểm là sai. Reciprocal Rank Fusion (RRF) giải quyết chuyện này vì nó chỉ dùng thứ hạng, không dùng điểm thô.
Công thức là: điểm của tài liệu bằng tổng của 1/(k + thứ hạng) qua từng danh sách, với k là một hằng số làm mượt. Thử với k = 60. Tài liệu A đứng hạng 1 bên BM25 và hạng 5 bên vector, nên được 1/61 + 1/65 ≈ 0,0318.
Tài liệu B đứng hạng 1 bên vector nhưng không có mặt bên BM25, chỉ được 1/61 ≈ 0,0164. Tài liệu xuất hiện ở cả hai nơi được đẩy lên trên, đúng như mong muốn.
Anthropic cũng công bố số liệu về việc ghép từ khoá với vector, nhưng trong một pipeline nhiều tầng hơn hybrid thông thường. Khi kết hợp contextual embeddings với contextual BM25, số lần retrieve thất bại giảm 49%; thêm bước reranking thì giảm 67%. Tỷ lệ thất bại trong top-20 chunk giảm từ 5,7% xuống 1,9%.
Nhưng đừng coi hybrid là chân lý. Trên benchmark thương mại điện tử WANDS, một bài viết của Denser cho thấy BM25 và dense search thuần không khác nhau có ý nghĩa thống kê (0,6983 so với 0,6953).
Bản hybrid đạt điểm cao nhất là bản đã được tinh chỉnh bằng cách tăng trọng số cho tên sản phẩm. Kết quả trên dữ liệu của người khác không thay được phép đo trên dữ liệu của khách bạn.
SQL chạy được vẫn có thể ra số sai
Với nhánh text-to-SQL, có một kết quả đáng chú ý từ thực tế, đi kèm một cái bẫy. Một kỹ sư kể rằng khi dùng truy xuất có hiểu schema kết hợp với chạy SQL, độ chính xác trên câu hỏi báo cáo có cấu trúc tăng từ khoảng 40% lên khoảng 75–80%.
Đây là đánh giá nội bộ từ một nguồn duy nhất, nên hãy xem nó là tín hiệu chứ chưa phải mức chuẩn.
Lỗi mà người này mô tả rất đáng nhớ: mô hình dùng ngày tạo hoá đơn, trong khi chỉ số cần ngày ghi sổ. Câu SQL hợp lệ, chạy không lỗi, ra một con số gọn gàng, và con số đó sai. Không có lớp kiểm tra nào về cú pháp bắt được lỗi này.
Vì vậy, câu SQL được sinh ra phải qua một lớp kiểm tra trước khi đến tay người dùng: có dùng đúng bảng được phép không, có đủ các bộ lọc bắt buộc không. Bạn có thể mã hoá định nghĩa nghiệp vụ thành luật.
Đoạn code dưới đây chỉ là bản phác hoạ để minh hoạ ý, không phải validator cho production. Nó dò chuỗi thô, nên một chú thích có chữ posting_date cũng lọt qua; bản thật nên phân tích câu SQL thành cây cú pháp rồi mới kiểm tra.
BANG_DUOC_PHEP = {"invoices", "regions"}

def kiem_tra_sql(sql: str, bang_dung: set[str], chi_so: str) -> list[str]:
    loi = []
    if not bang_dung <= BANG_DUOC_PHEP:
        loi.append(f"Bảng ngoài danh sách: {bang_dung - BANG_DUOC_PHEP}")
    if chi_so == "doanh_thu" and "posting_date" not in sql:
        loi.append("Doanh thu phải lọc theo posting_date, không theo created_at")
    if "status" not in sql:
        loi.append("Thiếu bộ lọc bắt buộc trên status")
    return loi
Luật thì đơn giản, phần khó là lấy được định nghĩa. Ở chỗ khách, hãy hỏi người phụ trách tài chính: “Doanh thu tháng này tính theo ngày nào?” Chính câu trả lời đó là luật kiểm tra đầu tiên bạn cần viết.
Bốn lỗi thường gặp
Lỗi phổ biến nhất là đưa mọi câu hỏi vào một pipeline vector vì demo chạy tốt, rồi lúc lên production mới phát hiện cả một nhóm câu hỏi tổng hợp không thể trả lời đúng. Kế đến là tin câu SQL chỉ vì nó chạy được, và trộn điểm BM25 với điểm vector bằng phép cộng thay vì dùng thứ hạng.
Lỗi cuối khó thấy hơn: chỉ báo một con số độ chính xác chung. Nếu bộ eval của bạn gồm 90% câu tra theo nghĩa, hệ thống có thể đạt điểm đẹp trong khi nhánh SQL sai một nửa. Hãy đo riêng từng loại câu hỏi.
Bài tập cho tuần này, và cách ghi vào CV
Lấy 50 câu hỏi thật, gắn nhãn ba loại, chạy qua bộ định tuyến ở trên và ghi lại bảng độ chính xác theo từng nhánh. Khi viết CV, đừng ghi “xây dựng hệ thống RAG”.
Hãy ghi kiểu: “phân loại 200 câu hỏi thật của khách, tách nhánh text-to-SQL có kiểm tra định nghĩa nghiệp vụ, đo độ chính xác riêng cho từng loại”. Một dòng như vậy cho thấy bạn biết đo, chứ không chỉ biết lắp ráp thư viện.
Thư viện retrieval sẽ còn thay đổi. Thói quen hỏi “khách thật sự hỏi gì?” trước khi viết dòng code đầu tiên thì không.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!