Tài liệu của khách đổi hằng tuần: cập nhật và xoá trong chỉ mục RAG mà không dựng lại từ đầu
Thêm tài liệu mới vào chỉ mục thì dễ. Phần khó là làm cho chỉ mục quên đúng những tài liệu khách đã gỡ khỏi nguồn mà không xoá nhầm phần còn lại.

Tóm tắt nhanh
- Mỗi chunk phải mang ID ổn định của tài liệu gốc. Không có ID này thì không xoá hay cập nhật đúng được.
- Incremental chỉ dọn tài liệu xuất hiện trong lần chạy. Muốn xoá tài liệu khách đã gỡ thì cần full, và loader phải trả về toàn bộ dữ liệu.
- Trên Qdrant, upsert thay cả point. Trên Pinecone, kết quả xoá không thấy được ngay. Hãy thiết kế bước kiểm tra cho phù hợp.
Thử hình dung một sáng thứ Hai. Đội nghiệp vụ bên khách báo rằng quy trình bồi thường bản cũ đã bị gỡ khỏi kho tài liệu từ thứ Sáu, nhưng chatbot vẫn trích dẫn nó cho nhân viên. Bản mới đã nằm trong chỉ mục từ lâu. Chỉ có điều bản cũ chưa bao giờ bị xoá.
Đây là một trong những sự cố hay gặp nhất khi RAG chạy trên dữ liệu thật. Lúc demo, bộ tài liệu đứng yên. Còn khi lên production, khách sửa, đổi tên và gỡ tài liệu hằng tuần. Vì vậy câu hỏi “làm sao để chỉ mục khớp với nguồn” sớm muộn cũng đến tay FDE.
Cách đơn giản nhất là xoá cả collection rồi embed lại từ đầu. Cách này dùng được khi bộ tài liệu nhỏ. Nhưng nó che đi vấn đề thật: hệ thống của bạn không biết chunk nào sinh ra từ tài liệu nào. Khi kho tài liệu đủ lớn để không dựng lại mỗi tuần được nữa, bạn sẽ phải trả món nợ đó.
Mỗi chunk phải biết nó sinh ra từ đâu
Mọi cơ chế đồng bộ đều dựa trên một nguyên tắc: chunk mang theo ID của tài liệu gốc, và có một nơi ghi lại những gì đã được index. Trong LangChain, nơi đó là record manager, một tập bản ghi có dấu thời gian cho biết tài liệu nào đã được cập nhật. Tham số source_id_key nối từng chunk với tài liệu nguồn của nó.
ID này phải ổn định qua các lần chạy. LlamaIndex nói rõ điều này: tính năng refresh chỉ chạy tự động khi tài liệu có id_ cố định. Với SimpleDirectoryReader, cờ filename_as_id lấy tên file làm ID. Nếu bạn sinh ID ngẫu nhiên lúc load, hệ thống sẽ coi mỗi lần chạy là một bộ tài liệu hoàn toàn mới.
Khi đã có ID gốc trong metadata, chính vector database cũng xoá được theo tài liệu. Qdrant xoá point bằng bộ lọc payload thay vì danh sách ID. Pinecone cho phép xoá các record trong một namespace theo giá trị metadata. Chỉ cần một trường như source, bạn gỡ được mọi chunk của một tài liệu bằng một lệnh.
Chọn nhầm chế độ cleanup là mất dữ liệu
Indexing API của LangChain có nhiều chế độ cleanup. Ba chế độ dưới đây là ba cách hiểu khác nhau về câu hỏi “chunk nào đã cũ”.
| Chế độ | Dọn gì, dùng khi nào | Lưu ý khi dùng |
|---|---|---|
incremental |
Chunk cũ của những source ID xuất hiện trong lần chạy này | Chunk của cùng một tài liệu rải ra nhiều batch thì API làm thừa việc, nên để chúng đi liền nhau |
full |
Mọi tài liệu mà loader không trả về trong lần chạy | Loader phải trả về toàn bộ dữ liệu, không phải một phần |
scoped_full |
Dùng khi loader không trả hết dữ liệu một lần, hoặc khó chọn batch size | Có từ langchain-core 0.3.25 |
Chi tiết quan trọng nằm ở cột giữa. Incremental chỉ dọn những gì nó “nhìn thấy”. Tài liệu khách đã xoá khỏi nguồn thì không xuất hiện trong lần chạy, nên incremental không bao giờ chạm tới nó. Đó chính là lý do quy trình bồi thường bản cũ vẫn còn trong chỉ mục.
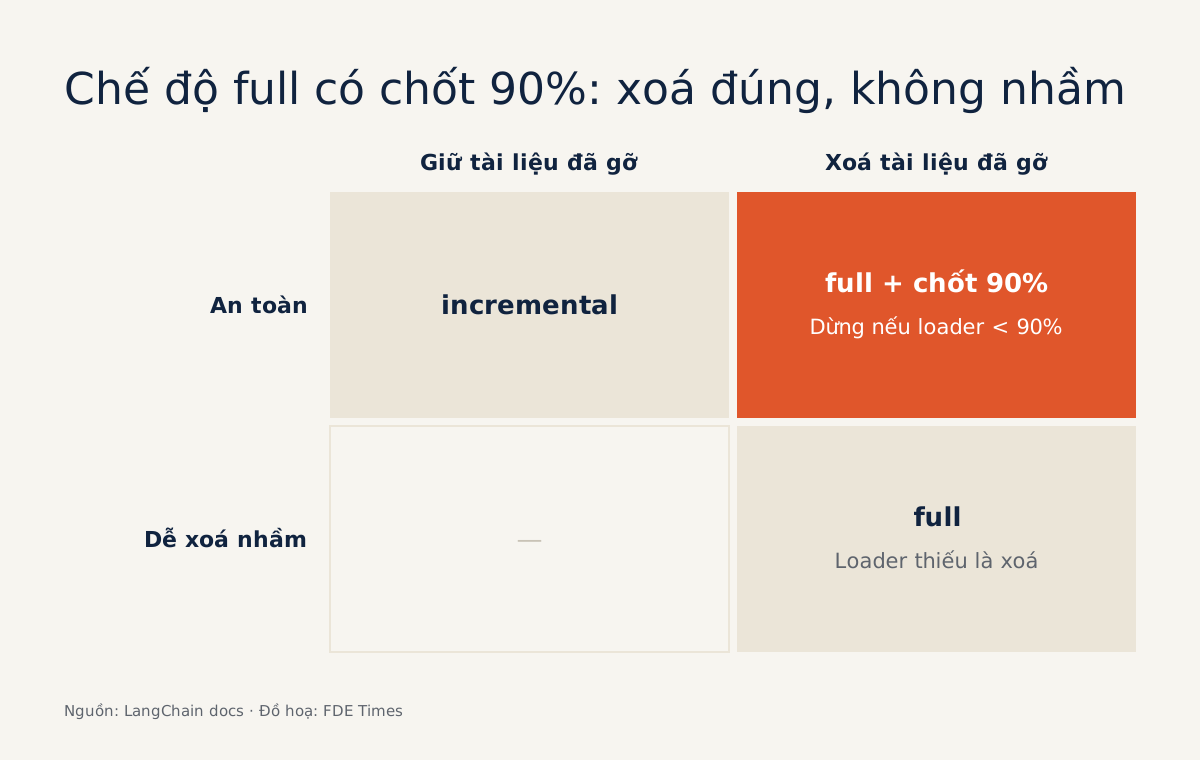
Full thì xoá được tài liệu đã gỡ, nhưng cũng là chế độ nguy hiểm nhất. Tài liệu LangChain nhắc rằng ở chế độ full, loader phải trả về toàn bộ dataset. Nếu loader chỉ trả về một phần, ví dụ vì API của khách phân trang và bạn quên lấy trang tiếp theo, full sẽ coi mọi thứ còn lại là rác và xoá đi.
Một ví dụ đi trọn từ đầu đến cuối
Các con số sau là giả định để minh hoạ. Thử hình dung khách có 1.200 tài liệu chính sách. Tuần này họ sửa 30 file, thêm 10 file và gỡ 5 file. Bạn muốn chỉ mục phản ánh đúng ba thay đổi đó, và 1.165 tài liệu không đổi thì giữ nguyên.
import json
import pathlib

from langchain.indexes import SQLRecordManager, index

record_manager = SQLRecordManager(
    namespace="acme_policies/qdrant",
    db_url="sqlite:///record_manager.db",
)
record_manager.create_schema()

docs = load_all_policies()  # loader của bạn; metadata["source"] = mã tài liệu ổn định của khách

# Số tài liệu gốc của lần chạy trước, tự lưu trong một file nhỏ
state = pathlib.Path("last_run.json")
last_count = json.loads(state.read_text())["sources"] if state.exists() else 0
current_sources = {d.metadata["source"] for d in docs}

if len(current_sources) < 0.9 * last_count:
    raise RuntimeError("Loader trả thiếu tài liệu, dừng trước khi cleanup")

result = index(
    docs,
    record_manager,
    vector_store,
    cleanup="full",
    source_id_key="source",
)
print(result)

state.write_text(json.dumps({"sources": len(current_sources)}))
Xem từng nhóm thay đổi. Với 30 file đã sửa, record manager thấy nội dung khác nên ghi chunk mới và dọn chunk cũ. Với 10 file mới, chunk được thêm vào. Với 5 file đã gỡ, chúng không có trong docs, nên chế độ full xoá chunk của chúng. Phần còn lại trùng với bản ghi cũ, nên được bỏ qua mà không cần embed lại.
Vẫn trong kịch bản giả định đó, giờ thử chạy cùng đoạn code nhưng loader bị lỗi và chỉ trả về 40 file đã đổi. Nếu không có dòng kiểm tra 0.9, chế độ full sẽ coi 1.170 tài liệu đang có trong chỉ mục mà loader không trả về là đã bị gỡ, và xoá chúng.
Con số 90% không có trong tài liệu nào cả. Đó là một chốt an toàn bạn tự đặt, và nên chỉnh theo nhịp thay đổi thực tế của từng khách. Để ý rằng số đếm chỉ được ghi lại sau khi index() chạy xong, nên một lần chạy lỗi không làm hỏng mốc so sánh của tuần sau.
Nếu một ngày bạn chuyển sang incremental, hãy giữ chunk của cùng một tài liệu đi liền nhau trong docs. LangChain cảnh báo rằng khi chunk của một source ID rơi vào nhiều batch khác nhau, API sẽ làm thừa việc.
Không dùng LangChain thì làm thế nào?
LlamaIndex có refresh(). Hàm này chỉ cập nhật những tài liệu có cùng id_ nhưng nội dung đã đổi, chỉ embed lại các tài liệu đó, và trong cùng lần gọi sẽ chèn thêm tài liệu chưa có trong chỉ mục. Refresh không lo việc xoá. Tài liệu bị gỡ phải xoá riêng theo ID, và lệnh xoá sẽ gỡ mọi node của tài liệu đó.
Có một bẫy nhỏ ở đây: delete_from_docstore mặc định là False, vì node có thể được nhiều chỉ mục dùng chung một docstore. Nếu dự án của bạn không dùng chung docstore, hãy chủ động bật cờ này, nếu không docstore sẽ phình dần theo thời gian.
Nếu bạn ghi thẳng vào Qdrant, cần hiểu đúng lệnh upsert. Khi upsert một point có ID đã tồn tại, Qdrant xoá point cũ rồi chèn lại chỉ với những vector bạn truyền vào.
Giả sử collection có cả dense vector và sparse vector, và bạn chỉ muốn embed lại phần dense. Khi đó hãy dùng thao tác update vectors, vì thao tác này giữ nguyên những vector bạn không nhắc tới.
Với Pinecone, vấn đề nằm ở thời điểm kiểm tra. Pinecone có tính nhất quán sau cùng (eventually consistent), nên ngay sau khi xoá hoặc cập nhật, truy vấn vẫn có thể trả về chunk cũ trong một khoảng ngắn. Nếu job đồng bộ kiểm tra kết quả ngay sau khi ghi, nó sẽ báo lỗi giả. Hãy chờ một lúc rồi mới chạy bước kiểm tra.
Những lỗi khiến chatbot trích dẫn tài liệu đã bị gỡ
Lỗi phổ biến nhất là ID không ổn định. Nếu tên file có kèm ngày tháng, hoặc khách hay đổi tên file, thì filename_as_id sẽ biến mỗi lần đổi tên thành một tài liệu mới, và bản cũ vẫn nằm lại trong chỉ mục.
Khi làm discovery, hãy hỏi khách xem hệ thống nguồn có mã tài liệu cố định không đổi theo tên hay không, và ưu tiên dùng mã đó.
Lỗi thứ hai là dùng incremental rồi tin rằng mọi thứ đã sạch. Lỗi thứ ba ngược lại: dùng full với một loader chưa từng được kiểm tra xem có trả đủ dữ liệu hay không. Cả hai đều chạy êm cho đến tuần khách xoá tài liệu đầu tiên, hoặc tuần API của khách trả lỗi giữa chừng.
Kỹ năng này cũng đáng có một dòng riêng trong CV. Đừng chỉ ghi “xây dựng hệ thống RAG”. Hãy mô tả cách bạn giữ chỉ mục khớp với nguồn khi dữ liệu đổi hằng tuần, và cách bạn ngăn việc xoá nhầm. Khi đọc JD có các cụm như ingestion pipeline hay data freshness, đó là chỗ để kể đúng câu chuyện này trong phỏng vấn.
Một hệ thống RAG được đánh giá vào lúc demo. Nhưng khách quyết định có tin nó hay không vào tuần đầu tiên chatbot trả lời bằng một văn bản họ đã gỡ đi.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!