Thực hành: dựng RAG chỉ trả lời theo bản chính sách đang có hiệu lực
Bản chính sách đã bị thay thế có thể đứng đầu kết quả tìm kiếm, và câu trả lời sai vẫn trông y như câu trả lời đúng.

Tóm tắt nhanh
- Bản sửa đổi và bản cũ gần như trùng nhau trong không gian embedding, nên chỉ xếp hạng theo độ tương đồng thì không phân biệt được bản nào còn hiệu lực.
- Ngày hiệu lực phải gắn trên từng chunk, mỗi truy vấn phải mang mốc as-of, còn effective_to nên ghi bằng sentinel ở tương lai xa.
- Trên benchmark VersionQA, phương pháp VersionRAG đạt 90% so với 58% của naive RAG: RAG không biết bản nào còn hiệu lực sẽ sai rất nhiều.
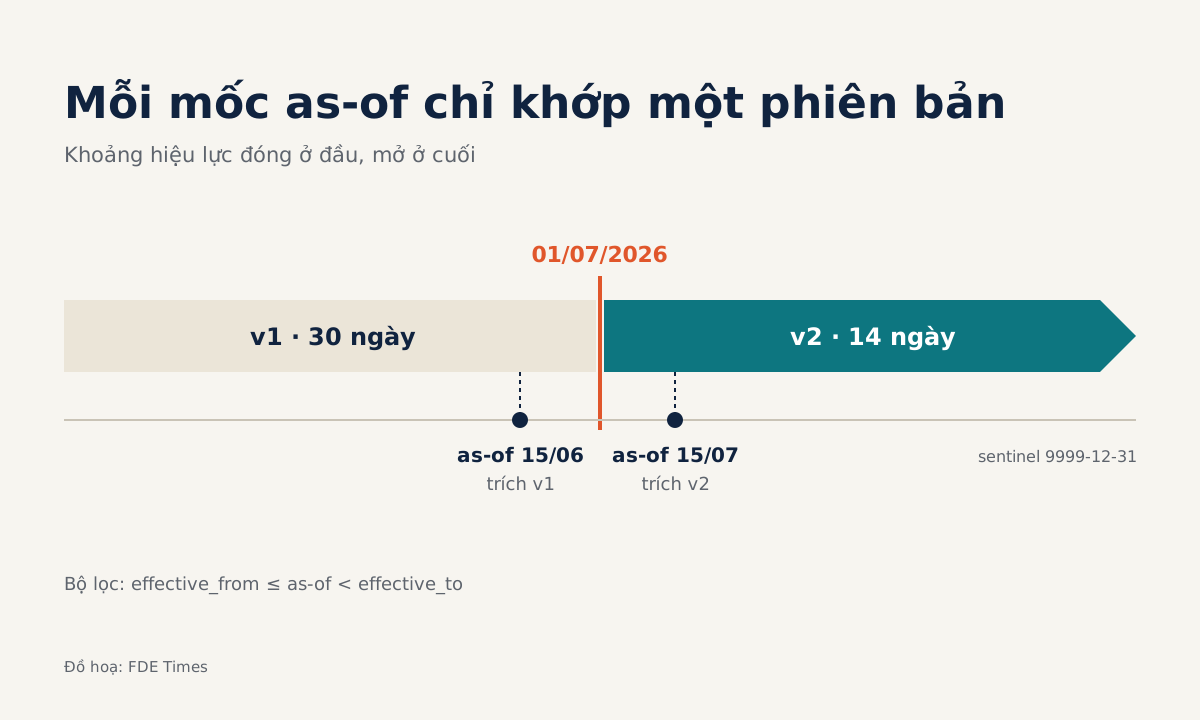
Thử hình dung khách hàng của bạn sửa chính sách hoàn tiền: thời hạn rút từ 30 ngày xuống 14 ngày, áp dụng từ 01/07/2026. Cả hai bản đều nằm trong vector store. Nhân viên hỏi chatbot “khách được hoàn tiền trong bao lâu?”, và chatbot tự tin trả lời 30 ngày, kèm trích dẫn hẳn hoi.
Lỗi này không nằm ở mô hình ngôn ngữ. Particula Tech chỉ ra rằng bản sửa đổi và bản mà nó thay thế gần như là bản sao của nhau trong không gian embedding, nên bản đã hết hiệu lực hoàn toàn có thể xếp hạng 1. Độ tương đồng ngữ nghĩa không có khái niệm thời gian.
Ở các dự án RAG doanh nghiệp, đây là lỗi mà FDE gần như chắc chắn sẽ gặp, vì chính sách, hợp đồng hay quy trình nào rồi cũng có phiên bản mới. Hướng dẫn này đi từ payload, qua bộ lọc, đến bộ test, để hệ thống chỉ trả lời theo bản đang có hiệu lực tại thời điểm được hỏi.
Bạn sẽ dựng gì, và cần gì?
Kết quả cuối cùng là một pipeline có ba phần: ingest gắn khoảng hiệu lực lên từng chunk, retrieval lọc theo mốc as-of, và một bộ test theo ngày. Bạn cần một vector store (ví dụ chính trong bài là Qdrant, kèm phần chuyển sang Pinecone và pgvector), một tài liệu có ít nhất hai phiên bản, và Python để viết code ingest.
Vì sao phải tốn công như vậy? Trên benchmark VersionQA, nhóm tác giả VersionRAG, một phương pháp đã công bố và khác với pipeline lọc metadata trong bài, đo được độ chính xác 90%, so với 58% của naive RAG và 64% của GraphRAG. Khoảng cách đó cho thấy RAG không phân biệt phiên bản sẽ sai rất nhiều trên tài liệu thay đổi theo thời gian.
Bước 1: ngày hiệu lực phải nằm trên chunk
Lỗi thiết kế hay gặp nhất là chỉ ghi ngày hiệu lực ở bảng đăng ký tài liệu. Particula Tech nhấn mạnh rằng ngày hiệu lực phải gắn trên từng chunk, vì bước retrieval lọc theo chunk chứ không lọc theo tài liệu. Vì vậy mỗi chunk cần mang đủ metadata của phiên bản sinh ra nó.
# Simplified: payload for one chunk
SENTINEL = "9999-12-31T23:59:59Z"

def make_payload(doc_id, version, text, effective_from, effective_to=None):
    return {
        "doc_id": doc_id,
        "version": version,
        "status": "effective",
        "effective_from": effective_from,           # RFC 3339
        "effective_to": effective_to or SENTINEL,   # never null
        "text": text,
    }
Dòng quan trọng là effective_to or SENTINEL. Bản đang hiệu lực thì chưa có ngày hết hạn, và theo phản xạ ta sẽ để trống. Particula Tech khuyên nên ghi hẳn một giá trị sentinel ở tương lai xa, vì ở phần lớn vector store, một khóa không tồn tại sẽ không khớp với điều kiện range. Nói cách khác, chính chunk mới nhất sẽ bị lọc mất.
Kiểm tra: đếm số chunk có effective_to rỗng hoặc vắng mặt. Con số đúng phải là 0.
Bước 2: khi có bản mới, hãy đóng bản cũ
Đến ngày 01/07/2026, bản v2 được ingest với effective_from = "2026-07-01T00:00:00Z". Đồng thời, mọi chunk của v1 phải được cập nhật effective_to thành đúng mốc đó và chuyển status sang superseded. Từ đây v1 có khoảng hiệu lực khép kín, còn v2 kéo dài tới sentinel.
Dù vậy, chưa nên yên tâm chỉ vì metadata đã đúng. Particula Tech cảnh báo rằng chỉ cần quên bộ lọc trên một collection dùng chung, hệ thống sẽ trả về điều khoản đã bị thay thế mà trông vẫn như một câu trả lời đúng.
Giải pháp họ ưu tiên là chuyển bản cũ sang một collection lưu trữ riêng. Collection chính khi đó chỉ chứa bản đang hiệu lực, còn collection lưu trữ giữ các bản đã hết hiệu lực để dùng thêm khi hỏi về quá khứ.
Kiểm tra: truy vấn collection chính mà không gắn bộ lọc nào. Nếu vẫn còn chunk mang status = superseded thì bước di chuyển sang collection lưu trữ đang có lỗi.
Bước 3: mỗi truy vấn đều mang mốc as-of
Theo Particula Tech, mọi truy vấn nên mang một mốc thời gian as-of, mặc định là thời điểm hiện tại, và chỉ giữ lại những chunk có khoảng hiệu lực chứa mốc đó. Câu “hồi tháng 5 khách được hoàn bao lâu?” khi đó chỉ khác ở chỗ truyền vào một mốc as-of khác.
Qdrant hỗ trợ điều kiện range cho payload kiểu datetime theo định dạng RFC 3339. Mệnh đề must chỉ đúng khi mọi điều kiện bên trong đều thỏa, nên rất hợp để ghép status với khoảng hiệu lực. Bộ lọc dưới đây đã được giản lược:
{
  "must": [
    { "key": "status", "match": { "value": "effective" } },
    { "key": "effective_from", "range": { "lte": "2026-10-26T00:00:00Z" } },
    { "key": "effective_to",   "range": { "gt":  "2026-10-26T00:00:00Z" } }
  ]
}
Hãy để ý cặp lte và gt. Khoảng hiệu lực được hiểu là đóng ở đầu và mở ở cuối, nên đúng 00:00 ngày 01/07 chỉ có v2 khớp, không có chuyện hai bản cùng lọt qua.
Khi hỏi về quá khứ, bạn bỏ điều kiện status, giữ hai điều kiện khoảng hiệu lực với mốc as-of mới, và tìm trên cả collection chính lẫn collection lưu trữ. Nếu chỉ tìm trong collection lưu trữ, một câu hỏi về ngày mà bản hiện hành đã có hiệu lực sẽ không tìm thấy gì, vì bản đó vẫn nằm ở collection chính.
Kiểm tra: đặt as-of là 15/06/2026 và 15/07/2026, hỏi cùng một câu trên cả hai collection. Câu đầu phải trích v1 (30 ngày), câu sau phải trích v2 (14 ngày).
Đổi sang Pinecone hay pgvector thì vướng gì?
Mỗi vector store có một cái bẫy riêng, và bạn cần biết bẫy đó trước buổi demo với khách hàng.
Pinecone có toán tử $gte/$lte trên metadata, nhưng chỉ dùng được với giá trị kiểu số. Vì thế ngày hiệu lực phải lưu dưới dạng số, ví dụ epoch giây, và sentinel cũng phải là một số. Ví dụ dưới đây đã được giản lược:
{
  "status": { "$eq": "effective" },
  "effective_from": { "$lte": 1792972800 },
  "effective_to":   { "$gt":  1792972800 }
}
Ở đây 1792972800 là epoch của 2026-10-26T00:00:00Z, và sentinel tương ứng là 253402300799 (9999-12-31T23:59:59Z). Nếu lỡ lưu ngày dưới dạng chuỗi, bộ lọc range sẽ không hoạt động như bạn mong đợi.
pgvector thì có bẫy tinh vi hơn. Khi dùng chỉ mục xấp xỉ, mệnh đề WHERE chỉ được áp dụng sau khi quét xong chỉ mục. Hệ quả là bạn xin top 10, chỉ mục trả về 10 chunk gần nhất, phần lớn trong đó là bản cũ bị lọc đi, và cuối cùng còn lại chưa tới 10.
README của pgvector gợi ý dùng iterative scan, hoặc partial index khi chỉ lọc theo ít giá trị riêng biệt, đúng như trường hợp status = 'effective'. Câu lệnh dưới đây chỉ mang tính minh họa, bạn nên đối chiếu với tài liệu pgvector theo phiên bản đang dùng:
CREATE INDEX ON policy_chunks
USING hnsw (embedding vector_cosine_ops)
WHERE status = 'effective';
Kiểm tra: xin top k và đếm số dòng trả về. Nếu thường xuyên ít hơn k, hãy bật iterative scan hoặc dùng partial index.
Bước 4: bộ test theo ngày là bằng chứng cho khách hàng
Bộ lọc chỉ chặn được nửa vấn đề. Cũng trong nghiên cứu VersionRAG, với loại câu hỏi phát hiện thay đổi ngầm giữa các phiên bản, các baseline gần như thất bại hoàn toàn với độ chính xác 0-10%, còn VersionRAG đạt 60%.
Điều nên rút ra là câu hỏi kiểu “chính sách hoàn tiền đã thay đổi gì?” vẫn khó ngay cả khi metadata đã chuẩn, nên hãy đưa loại câu này vào bộ test thay vì hứa hẹn với khách hàng.
Một bộ test tối thiểu gồm các bộ ba: câu hỏi, mốc as-of, phiên bản kỳ vọng. Bạn nên có câu trước ngày sửa đổi, câu sau ngày sửa đổi, câu đúng vào ngày chuyển giao, và vài câu hỏi về sự thay đổi.
Mỗi lần ingest lại hay đổi embedding model, cho bộ test chạy trong CI và kiểm tra phiên bản được trích dẫn, đừng chỉ kiểm tra văn bản trả lời.
Những lỗi nào hay làm hỏng cả pipeline?
Trước khi mang hệ thống tới khách hàng, hãy rà lại năm lỗi đã gặp ở các bước trên. Mỗi lỗi đều có một phép kiểm tra nhanh.
| Lỗi | Dấu hiệu | Cách sửa |
|---|---|---|
| Ngày hiệu lực chỉ có ở bảng đăng ký tài liệu | Bộ lọc retrieval không có gì để lọc | Ghi effective_from, effective_to, status lên từng chunk |
| Để effective_to rỗng cho bản đang hiệu lực | Chính bản mới nhất biến mất khỏi kết quả | Backfill bằng sentinel ở tương lai xa |
| Bản cũ nằm chung collection với bản mới | Quên filter là trả về điều khoản cũ | Chuyển bản cũ sang collection lưu trữ |
| Lưu ngày dạng chuỗi trên Pinecone | Range filter không lọc như mong đợi | Lưu epoch, sentinel cũng là số |
| Lọc WHERE sau chỉ mục xấp xỉ trên pgvector | Xin top k nhưng nhận ít hơn k | Bật iterative scan hoặc dùng partial index |
Nếu chỉ có thời gian sửa một thứ, hãy bắt đầu từ dòng thứ hai: đếm chunk thiếu effective_to là việc mất vài phút nhưng chặn được lỗi khó thấy nhất.
Ở chỗ khách hàng, kỹ năng này trông thế nào?
Việc đầu tiên cần làm tại khách hàng không phải là code. Hãy hỏi người giữ tài liệu: phiên bản được đánh dấu bằng cách nào, ngày hiệu lực lưu ở đâu, và ai quyết định một bản đã bị thay thế.
Thường thì thông tin này nằm trong tên file, trong một bảng tính, hoặc chỉ trong đầu một người ở phòng pháp chế. Bước 1 sẽ thất bại nếu bạn không lấy được câu trả lời này.
Nếu muốn ứng tuyển vào vị trí FDE làm applied AI, hãy để ý những job description nhắc tới RAG trên tài liệu nội bộ, compliance hay pháp lý.
Trong CV, thay vì viết “xây dựng RAG”, hãy mô tả đúng sự cố bạn đã xử lý: chặn việc trích dẫn bản đã hết hiệu lực, và chứng minh bằng một bộ test có mốc as-of. Nhà tuyển dụng sẽ thấy bạn hiểu dữ liệu thật của khách hàng.
Bản demo nào cũng chạy tốt khi kho chỉ có một phiên bản. Hệ thống của bạn chỉ thực sự được kiểm chứng vào ngày khách hàng ban hành bản sửa đổi đầu tiên.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!