pass@k và pass^k: vì sao agent làm đúng một lần chưa đủ để báo cáo cho khách
Cùng một bộ task có thể cho ra 100%, 84% hoặc 50%, tùy bạn đang đo khả năng hay đo độ tin cậy, và khách hàng cần biết bạn đang đưa con số nào.

Tóm tắt nhanh
- pass@k hỏi agent có làm được ít nhất một lần không, còn pass^k hỏi agent có làm được lần nào cũng đúng không.
- Khi k tăng, pass@k đi lên còn pass^k đi xuống, nên chỉ báo cáo pass@k sẽ che mất chuyện agent chạy thiếu ổn định.
- Agent chạy tự động, không có người duyệt thì phải báo cáo pass^k, và các lần chạy phải thật sự độc lập với nhau.
Thứ Sáu, agent xử lý hóa đơn chạy trơn tru trên mười task mẫu của khách trong buổi demo. Sang thứ Hai, cùng mười task đó được chạy lại và ba cái hỏng. Không ai sửa một dòng code nào.
Người phụ trách bên khách hỏi một câu rất hợp lý: rốt cuộc agent đúng bao nhiêu phần trăm? Bạn có thể trả lời bằng ba con số khác nhau, con số nào cũng “đúng” về mặt kỹ thuật. Chọn sai con số thì bạn hứa với khách một mức độ tin cậy mà hệ thống không có.
Đây là kỹ năng mà FDE nào đưa agent vào production cũng phải có: biết mình đang đo khả năng hay đo độ tin cậy, và nói rõ điều đó trước khi đưa con số lên slide.
Hai câu hỏi nghe giống nhau nhưng khác hẳn
Anthropic định nghĩa pass@k là xác suất agent có ít nhất một lời giải đúng trong k lần thử. Câu hỏi nó trả lời là: agent có làm được việc này không, nếu cho nó vài cơ hội?
pass^k thì hỏi điều khác. Theo Anthropic, đó là xác suất cả k lần thử đều thành công. Phil Schmid ở Google DeepMind diễn đạt chặt hơn: agent phải thành công trên tất cả k lần thử độc lập. Câu hỏi lúc này là: agent có làm đúng ở mọi lần không?
Metric này không phải mới. pass^k được đề xuất trong bài báo τ-bench của nhóm Yao, Shinn, Razavi và Narasimhan ở Sierra và Princeton, đăng trên arXiv ngày 17/6/2024, để đo độ tin cậy của agent qua nhiều lần thử. Sierra mô tả nó là thước đo xem agent có hoàn thành được cùng một tác vụ nhiều lần hay không, chứ không chỉ một lần.
Hai metric đi ngược chiều nhau khi k tăng. Anthropic giải thích rằng pass^k giảm vì đòi hỏi nhất quán qua nhiều lần chạy là ngưỡng khó hơn, trong khi pass@k thì tăng.
Thử hình dung một agent đúng 80% mỗi lần chạy, các lần chạy độc lập với nhau. Với k = 1, cả hai số đều là 80%. Lên k = 3, pass@3 = 1 − 0,2³ = 99,2% còn pass^3 = 0,8³ = 51,2%.
Đến k = 5, pass@5 gần chạm 100% (99,968%) trong khi pass^5 chỉ còn 0,8⁵ ≈ 32,8%: cùng một agent, một bên gần như hoàn hảo, bên kia đúng chưa tới một phần ba số lần.
Một ví dụ chạy đủ năm lần
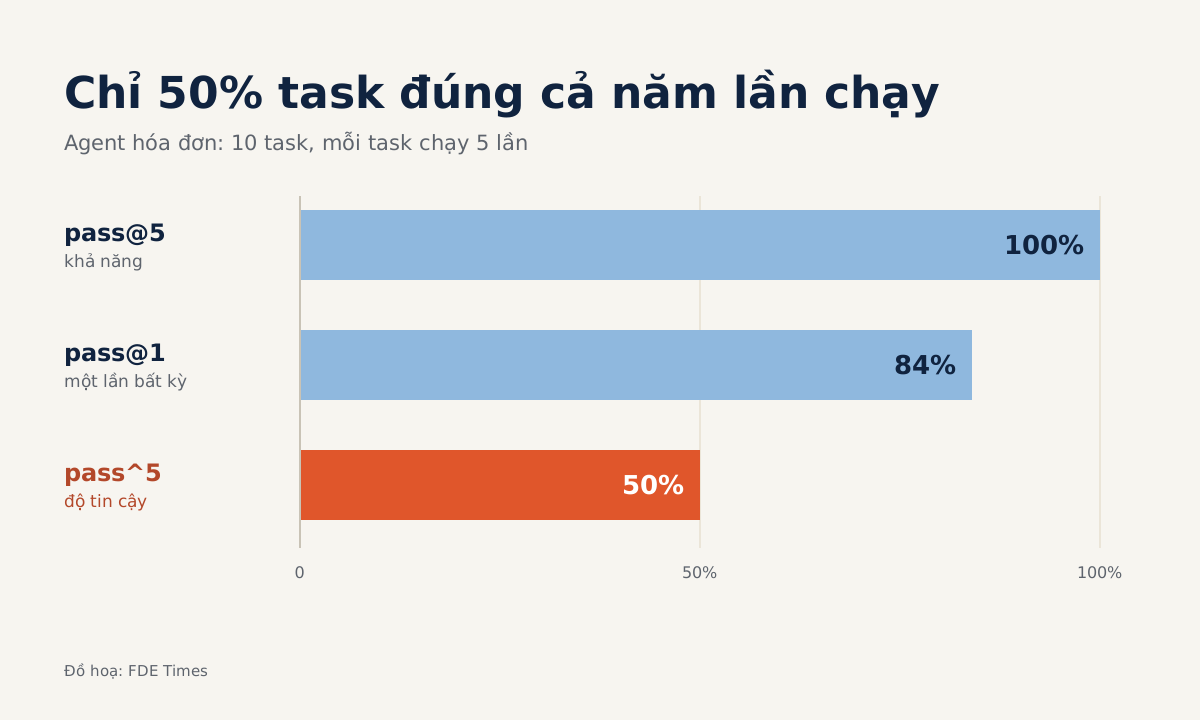
Quay lại agent hóa đơn. Giả sử bạn lấy mười task thật của khách và chạy mỗi task năm lần, mỗi lần với một phiên sạch. Kết quả ghi lại là số lần đúng trên năm lần của từng task:
results = {  # task_id: số lần đúng trên 5 lần chạy
    "T01": 5, "T02": 5, "T03": 5, "T04": 4, "T05": 4,
    "T06": 3, "T07": 5, "T08": 2, "T09": 5, "T10": 4,
}
n = k = 5

# pass@1: tỷ lệ đúng trung bình trên mọi lần chạy
pass_1 = sum(results.values()) / (len(results) * n)
# pass@5: task có ít nhất một lần đúng
pass_at_k = sum(c > 0 for c in results.values()) / len(results)
# pass^5: task đúng cả 5 lần
pass_pow_k = sum(c == n for c in results.values()) / len(results)

print(pass_1, pass_at_k, pass_pow_k)  # 0.84 1.0 0.5
Mỗi con số trả lời một câu hỏi riêng:
| Metric | Câu hỏi nó trả lời | Kết quả |
|---|---|---|
| pass@5 | Task nào agent làm được ít nhất một lần? | 100% |
| pass@1 | Một lần chạy bất kỳ đúng bao nhiêu phần trăm? | 84% |
| pass^5 | Task nào agent lần nào cũng đúng? | 50% |
Nếu slide ghi “100% task thành công”, bạn không nói dối. Nhưng khách sẽ hiểu là agent xử lý được mọi hóa đơn, trong khi thực tế một nửa số loại hóa đơn có lúc hỏng. Task T08 chỉ đúng hai trên năm lần, và đó mới là dòng khách cần thấy.
Kết quả của τ-bench cho thấy đây không phải trường hợp hiếm. Sierra báo cáo rằng mọi mô hình được thử đều giảm hiệu năng đáng kể khi k tăng, tức là chúng thiếu ổn định.
Chọn số nào để đưa lên slide?
Anthropic khuyên chọn metric theo bản chất sản phẩm: pass@k cho những công cụ mà chỉ cần một lần thành công, pass^k cho những agent cần nhất quán. Một công cụ gợi ý code cho lập trình viên, nơi người dùng sinh vài phương án rồi tự chọn, hợp với pass@k. Agent tự động trả lời khiếu nại khách hàng thì không.
Hướng dẫn trên agentpatterns.ai nói thẳng hơn: pipeline chạy tự động thì pass^k mới là con số cần nhìn. pass@k chỉ có nghĩa khi có người duyệt kết quả, và nên báo cáo cả hai số.
Phil Schmid cảnh báo pass@k có thể làm hiệu năng trông tốt hơn thực tế. Theo ông, với agent, mục tiêu nên là đo tính nhất quán chứ không phải kết quả tốt nhất. Ở chỗ khách, cách an toàn là đặt cả hai số cạnh nhau và ghi rõ dưới mỗi số: “khả năng” và “độ tin cậy”.
Cách làm ở chỗ khách hàng
Bắt đầu bằng việc hỏi khách xem kết quả của agent có ai duyệt trước khi đi tiếp không. Câu trả lời quyết định metric chính. Có người duyệt thì pass@k là số chính, kèm pass^k. Không có ai duyệt thì ngược lại.
Tiếp theo, dựng bộ task từ dữ liệu thật của khách, kể cả những ca khó mà họ hay than phiền. Chọn k gần với rủi ro thực tế: một luồng chạy hàng nghìn lần mỗi ngày cần k lớn hơn một luồng chạy vài lần mỗi tuần. Chạy từng task đủ k lần, ghi số lần đúng cho từng task chứ không chỉ con số tổng.
Cuối cùng, báo cáo theo task. Những task có pass^k thấp chính là danh sách việc cần làm tiếp: sửa prompt, thêm bước kiểm tra, hoặc đưa người vào duyệt ở đúng chỗ đó. Khách thấy được rủi ro nằm ở đâu, thay vì một con số trung bình.
Kỹ năng này cũng là điểm cộng khi đi phỏng vấn. Trong CV, thay vì viết “xây agent đạt độ chính xác 90%”, hãy viết bạn đo pass^k trên bao nhiêu task, với k bằng bao nhiêu, và đã nâng nó lên ra sao. Nếu JD có nhắc tới evals, hãy chuẩn bị sẵn cách giải thích pass^k bằng một ví dụ từ chính dự án của bạn.
Những lỗi khiến con số sai mà không ai biết
Lỗi nguy hiểm nhất là các lần thử không độc lập. Cả hai metric đều giả định điều đó. Theo agentpatterns.ai, nếu harness dùng chung context, seed hoặc cache, các mẫu sẽ tương quan với nhau và con số không còn phản ánh đúng điều metric định nghĩa. Một agent “đúng cả năm lần” có thể chỉ đang đọc lại kết quả cũ từ cache.
Lỗi thứ hai là chỉ báo cáo pass@k cho một agent chạy tự động, như slide “100%” ở trên. Lỗi thứ ba là chạy mỗi task một lần rồi gọi đó là pass@1, trong khi một lần chạy không cho bạn biết gì về độ dao động.
Và cuối cùng là gộp mọi thứ thành một số trung bình, làm mất đúng những task như T08 mà khách cần biết.
Lần tới, khi khách hỏi “agent đúng bao nhiêu phần trăm”, câu trả lời tốt nhất bắt đầu bằng một câu hỏi ngược lại: đúng một lần, hay lần nào cũng đúng?
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
5 nguồn
- Demystifying evals for AI agents · 2026-01-09
- τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains · 2024-06-17
- τ-Bench: Benchmarking AI agents for the real-world · 2024-06-20
- Pass@k vs Pass^k: Understanding Agent Reliability · 2025-03-24
- pass@k and pass^k: Capability and Consistency Metrics · 2026-06-12