Với bảng mười nghìn dòng, deep learning vẫn khó thắng mô hình cây
Với ảnh và văn bản thì ngược lại; bốn câu hỏi về dạng dữ liệu, nhãn, nhu cầu giải thích và GPU cho đáp án trong đa số trường hợp.
Tóm tắt nhanh
- Trên dữ liệu bảng cỡ vừa (khoảng 10 nghìn mẫu), mô hình dựa trên cây vẫn là state-of-the-art theo benchmark của Grinsztajn và cộng sự.
- Ảnh và văn bản không phải dữ liệu số tự nhiên; deep learning tự học đặc trưng từ dữ liệu thô nên phát huy ở đây.
- Bốn câu hỏi cần hỏi khách trước khi chọn: dạng dữ liệu, lượng dữ liệu, nhu cầu giải thích và GPU.
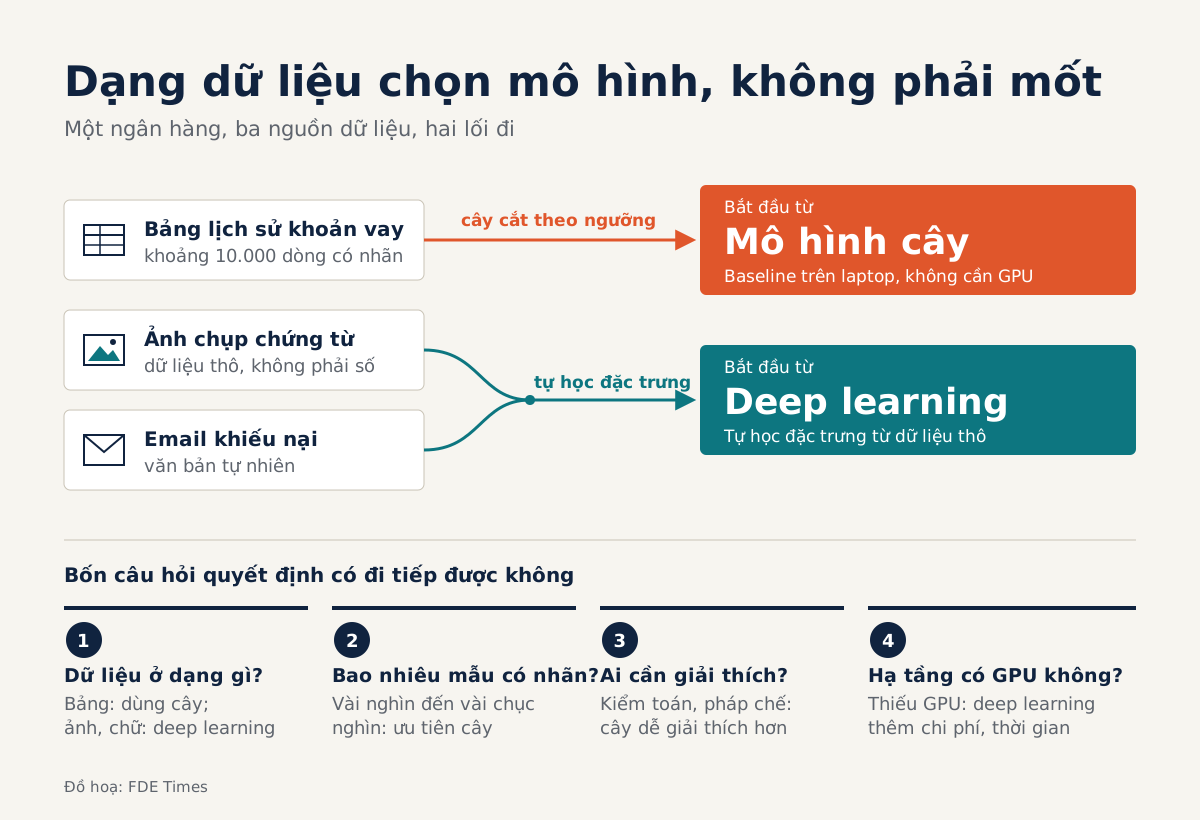
Thử hình dung tuần đầu tiên ở một ngân hàng. Bạn nhận ba thứ cùng lúc: một bảng lịch sử khoản vay, một thư mục ảnh chụp chứng từ, và một kho email khiếu nại của khách hàng. Ai đó trong phòng hỏi câu quen thuộc: “Mình dùng deep learning cho cả ba luôn nhé?”
Câu trả lời đúng không phải “có” hay “không”. Câu trả lời đúng là: tuỳ dạng dữ liệu, và bạn cần nói được lý do trong hai phút. Đây là một trong những quyết định kỹ thuật đầu tiên mà FDE phải đưa ra, và nó quyết định chi phí hạ tầng, thời gian ra kết quả, cả việc khách có tin mô hình hay không.
Bài này dạy một cách nghĩ đơn giản gồm bốn câu hỏi: dữ liệu ở dạng gì, có bao nhiêu nhãn, ai cần giải thích, và có GPU không. Phần lớn trường hợp, bốn câu đó đã cho bạn đáp án.
Bảng dữ liệu cỡ vừa vẫn là sân nhà của mô hình cây
Bảng khoản vay là bài toán học có giám sát điển hình. Microsoft Learn mô tả học có giám sát là khi dữ liệu huấn luyện có cả giá trị đặc trưng lẫn nhãn đã biết, và lấy đúng ví dụ này: đoán xem một khách hàng ngân hàng có vỡ nợ hay không dựa trên thu nhập, lịch sử tín dụng, tuổi và các yếu tố khác.
Đó là phân loại nhị phân trên dữ liệu bảng.
Với loại dữ liệu này, bằng chứng khá rõ. Benchmark của Grinsztajn và cộng sự trên dữ liệu bảng kết luận rằng mô hình dựa trên cây vẫn là state-of-the-art ở tập dữ liệu cỡ vừa, khoảng 10 nghìn mẫu. Nếu bảng khách đưa cho bạn cũng ở cỡ này, đó là tín hiệu đầu tiên nghiêng về mô hình cây.
Lý do không chỉ là kinh nghiệm truyền miệng. Nhóm tác giả chỉ ra rằng mạng nơ-ron có thiên hướng ra nghiệm quá mượt, nên khó học những hàm bất thường. Dữ liệu bảng lại đầy những bậc thang kiểu đó: thu nhập vượt một ngưỡng thì rủi ro đổi hẳn, số lần trễ hạn từ hai trở lên thì khác hoàn toàn.
Cây quyết định cắt theo ngưỡng một cách tự nhiên.
Làm thử: baseline cho bảng khoản vay
Giả sử bảng có khoảng 10.000 dòng, các cột như income, age, num_late_payments, loan_type và nhãn defaulted. Việc đầu tiên không phải là thiết kế kiến trúc mạng, mà là dựng một baseline gradient boosting trong vài chục dòng code.
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.metrics import roc_auc_score

df = pd.read_csv("loans.csv")
X = df.drop(columns=["defaulted"])
y = df["defaulted"]
X["loan_type"] = X["loan_type"].astype("category")

X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42)

model = HistGradientBoostingClassifier(categorical_features="from_dtype")
model.fit(X_tr, y_tr)
print("AUC:", roc_auc_score(y_te, model.predict_proba(X_te)[:, 1]))
Baseline này chạy trên laptop, không cần GPU, và cho bạn một con số để thương lượng. Nếu sau đó ai muốn thử mạng nơ-ron, họ phải vượt con số này trên cùng tập kiểm tra. Đó là cách biến tranh luận “mốt hay không mốt” thành một phép đo.
Mạng nơ-ron cho bảng không bị cấm. Khoá Practical Deep Learning của fast.ai có hẳn phần về dữ liệu bảng với biến phân loại, biến liên tục và dữ liệu hỗn hợp. Nhưng hãy coi đó là ứng viên thứ hai, chỉ đáng thử khi baseline cây đã có và dữ liệu đủ lớn.
Ảnh và văn bản thì cán cân đảo chiều
Thư mục chứng từ và kho email là chuyện khác. IBM giải thích rằng văn bản, ảnh, đồ thị mạng xã hội hay hành vi người dùng không phải dữ liệu số tự nhiên, nên cần xử lý đặc trưng nhiều hơn hẳn.
Với ML cổ điển, bạn sẽ phải tự nghĩ ra cách biến một tấm ảnh hoá đơn thành các cột số, một việc tốn công và dễ sai.
Deep learning làm việc trên dữ liệu thô và tự động hoá phần lớn khâu feature engineering đó. Microsoft Learn cũng ghi nhận mạng nơ-ron sâu dùng được cho hồi quy, phân loại và các mô hình chuyên biệt cho xử lý ngôn ngữ tự nhiên và thị giác máy tính. Với ảnh chứng từ và email khiếu nại, deep learning nên là điểm xuất phát.
Bốn câu hỏi phải hỏi khách trước khi chốt
Dạng dữ liệu cho bạn hướng đi, nhưng điều kiện của khách mới quyết định có đi được không. IBM nêu đánh đổi cốt lõi: deep learning dễ mở rộng hơn nhưng khó diễn giải hơn ML truyền thống, và đòi hỏi lượng dữ liệu rất lớn. Microsoft Learn thêm rằng huấn luyện mạng nơ-ron nên chạy trên máy có GPU, vốn tối ưu cho phép tính ma trận.
| Câu hỏi cho khách | Nếu câu trả lời nghiêng về… | Hệ quả cho lựa chọn |
|---|---|---|
| Dữ liệu ở dạng gì? | Bảng, hay ảnh và văn bản | Bảng: bắt đầu bằng mô hình cây; ảnh và văn bản: bắt đầu bằng deep learning |
| Có bao nhiêu mẫu đã gán nhãn? | Vài nghìn đến vài chục nghìn | Ưu tiên mô hình cây, nhất là với bảng |
| Ai cần hiểu vì sao mô hình quyết định? | Bộ phận tín dụng, kiểm toán, pháp chế | Mô hình cây dễ giải thích hơn, ghi rõ yêu cầu này |
| Hạ tầng có GPU không? | Không, hoặc phải xin ngân sách | Deep learning kéo theo chi phí và thời gian chuẩn bị |
Với ngân hàng giả định, bảng khoản vay trả lời cả bốn câu theo hướng mô hình cây. Ảnh và email thì đáng đầu tư deep learning, nhưng bạn cần hỏi ngay từ tuần đầu: họ có đủ ảnh đã gán nhãn không, và GPU nằm ở đâu.
Năm bước để tự làm ở khách hàng
Bước một, phân loại từng nguồn dữ liệu: bảng, ảnh, văn bản, hay hỗn hợp. Bước hai, đếm số mẫu có nhãn thật, không phải số dòng thô, vì nhãn mới là thứ học có giám sát cần.
Bước ba, hỏi ai sẽ dùng và phải giải thích kết quả cho ai. Bước bốn, kiểm tra hạ tầng: GPU, nơi dữ liệu được phép nằm, thời gian huấn luyện chấp nhận được.
Bước năm, dựng baseline rẻ nhất phù hợp với dạng dữ liệu trước, rồi mới thử phương án nặng hơn trên cùng tập kiểm tra. Ghi lại kết quả thành một trang ngắn để khách đọc được.
Những lỗi hay gặp
Lỗi thứ ba khó thấy hơn: quên hỏi về khả năng giải thích. Một mô hình chính xác nhưng bộ phận tín dụng không thể giải thích cho khách vay hay kiểm toán thì sẽ nằm mãi ở bản demo.
Nếu bạn đang chuẩn bị ứng tuyển FDE, hãy đưa đúng loại quyết định này vào CV: không chỉ “dùng XGBoost” mà là “chọn mô hình cây thay vì mạng nơ-ron vì dữ liệu cỡ vừa và yêu cầu giải thích, đo trên cùng tập kiểm tra”.
Ở buổi họp tiếp theo, khi ai đó hỏi “dùng deep learning cho cả ba nhé?”, bạn đã có câu trả lời ngắn gọn hơn: cây cho bảng, mạng nơ-ron cho ảnh và chữ, và một baseline để chứng minh.
Bài này có hữu ích không?
Cảm ơn bạn đã góp ý!
5 nguồn
- Why do tree-based models still outperform deep learning on tabular data? (Grinsztajn et al.) · 2022-07-18
- What is Machine Learning? | IBM · 2025-08-18
- Types of machine learning model - Training | Microsoft Learn · 2026-03-27
- Deep learning - Training | Microsoft Learn · 2026-03-27
- Practical Deep Learning for Coders - Practical Deep Learning